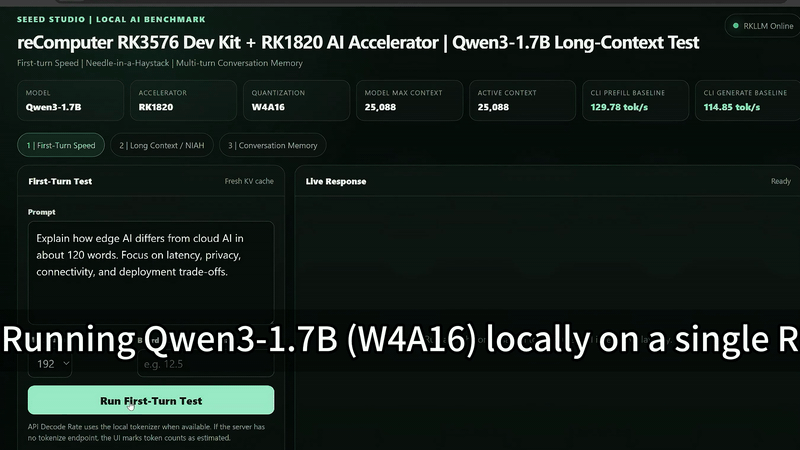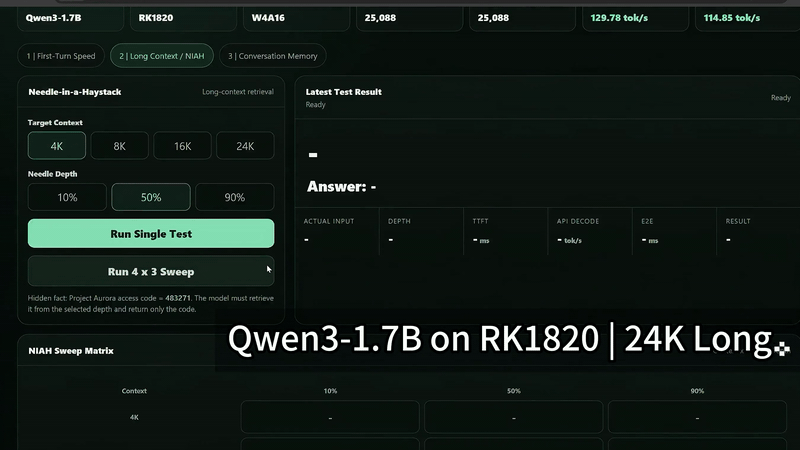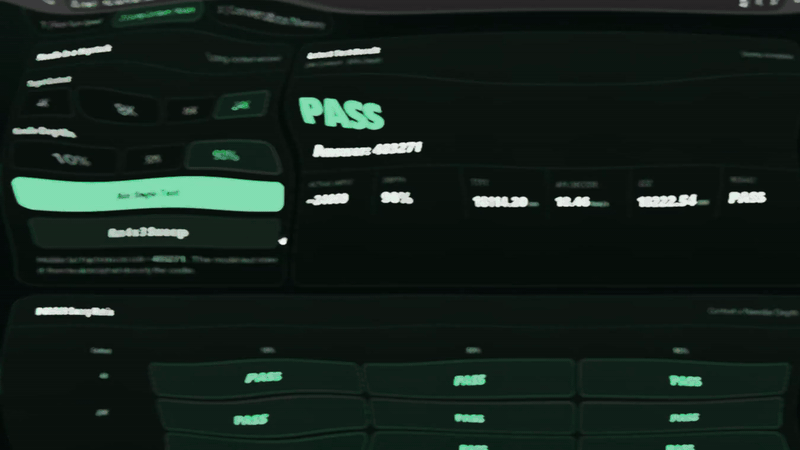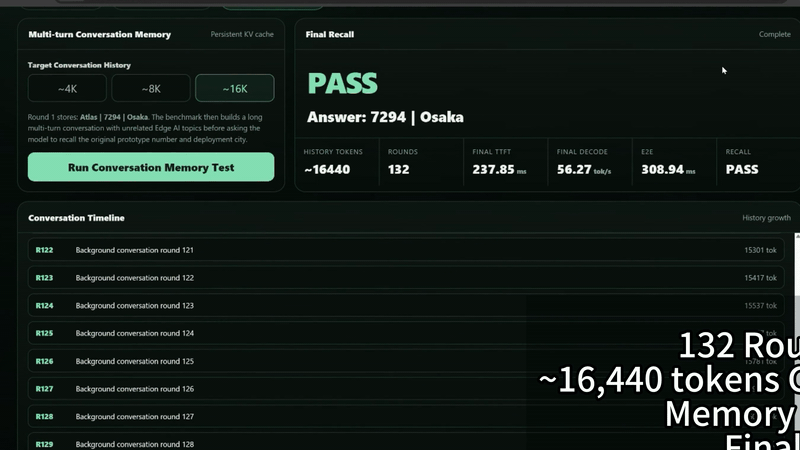
RK1820 アクセラレーターを搭載した reComputer RK3576 上で Qwen3-1.7B をローカル実行します。ブラウザー UI では、初回応答、長文中の情報を探す「干し草の山から針を探す」テスト、複数ターンにわたる会話記憶の 3 種類を確認できます。モデルサービスと UI はどちらもボード上で動作します。
デモの内容
| テスト | 確認する内容 |
|---|---|
| 初回応答 | 新しい KV キャッシュでプロンプトに応答する様子。 |
| 長文からの情報検索 | 長い入力に埋め込まれた情報を取り出せるか。 |
| 会話記憶 | 複数ターン後に以前の情報を思い出せるか。 |
収録したデモでは、モデルコンテキスト長が 25,088 トークンの Qwen3-1.7B W4A16 モデルを使用しています。画面上のトークン速度はローカルのストリーミング API を通じた測定値であり、rknn3_session_test の結果や別の構成での性能保証ではありません。
必要な環境
- RK1820 アクセラレーターが取り付けられ、認識されている reComputer RK3576。
rkllm3-serverを利用できる、互換性のあるボード側ランタイム。- FastAPI UI 用の Python 3 と
venv。Python 依存パッケージはプロジェクトのrequirements.txtに記載され、start_ui.shが pip でインストールします。 - 別途用意した RK1820 対応の Qwen3-1.7B モデルパッケージ。起動スクリプトは
MODEL_DIR内のQwen3-1.7B-25088.rknn、Qwen3-1.7B.weight、Qwen3-1.7B.tokenizer.gguf、Qwen3-1.7B.embed.binを必要とします。
実行方法
リポジトリを取得し、プロジェクトのディレクトリに移動します。
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-1p5b-benchmark
chmod +x *.sh
./check_env.sh
上流のディレクトリ名には今も 1p5b が含まれますが、このプロジェクトの README、設定、起動スクリプトは Qwen3-1.7B を使用しています。最初のターミナルで MODEL_DIR に対応するモデルパッケージを指定し、モデルサービスを起動します。
MODEL_DIR=/path/to/Firefly-Qwen3-1.7B-RK1820 ./start_model_server.shそのまま実行しておき、2 つ目のターミナルから同じディレクトリで UI を起動します。
./start_ui.sh同じネットワーク上のブラウザーで http://<RK3576-IP>:7863 を開きます。UI は既定でボード上の http://127.0.0.1:8080 に接続します。スクリプトの既定のコンテキスト長は 25,088 トークンです。変更する場合は対応モデルを使用し、サーバーの CTX_SIZE と UI の SERVER_CONTEXT を一致させてください。
ソースと注意事項
モデルファイルと互換性のあるボード側ランタイムは別途準備する必要があります。UI は信頼できるローカルネットワーク向けです。外部に公開する前にアクセス制御を確認してください。