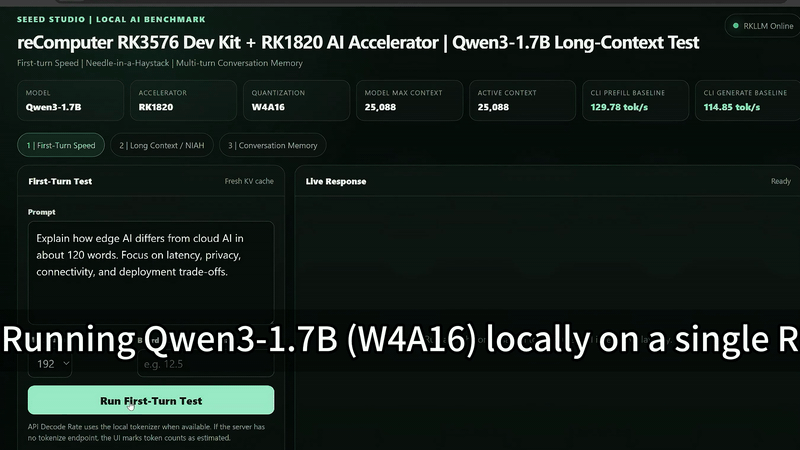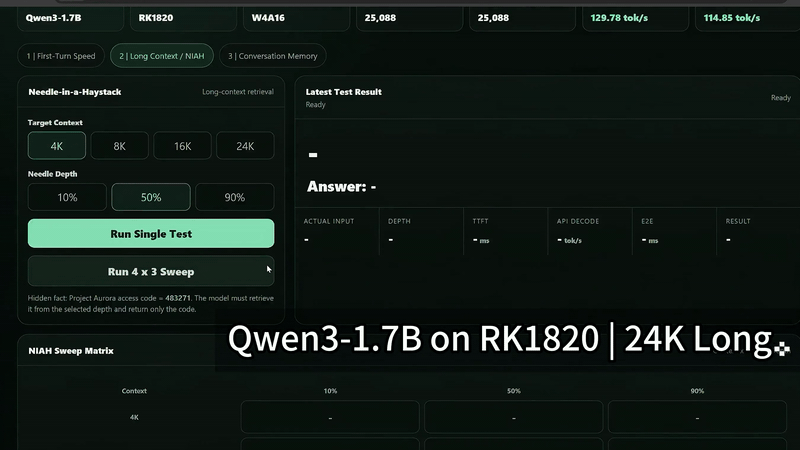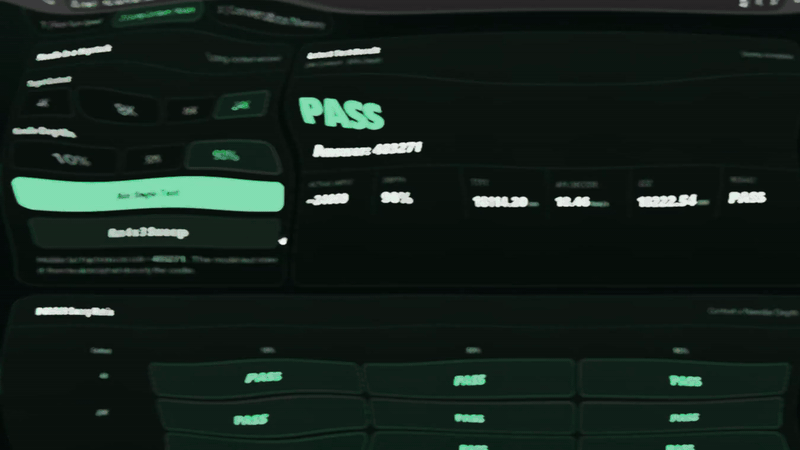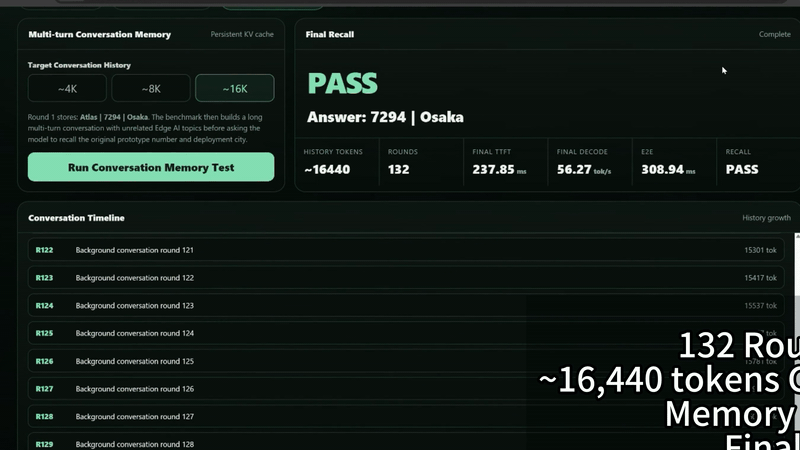
Führen Sie Qwen3-1.7B lokal auf einem reComputer RK3576 mit RK1820-Beschleuniger aus. Die Browseroberfläche vereint drei Tests: erste Antwort, Suche nach einer versteckten Information in einem langen Text und Gedächtnis über mehrere Gesprächsrunden. Modelldienst und Oberfläche laufen beide auf dem Board.
Was die Demo zeigt
| Test | Was geprüft wird |
|---|---|
| Erste Antwort | Die Antwort auf eine neue Eingabe mit frischem KV-Cache. |
| Suche im langen Kontext | Ob das Modell eine in einer langen Eingabe versteckte Information findet. |
| Gesprächsgedächtnis | Ob das Modell frühere Informationen nach vielen Runden wiedergeben kann. |
Die aufgezeichnete Demo zeigt ein Qwen3-1.7B-W4A16-Modell mit einem Modellkontext von 25,088 Token. Die angezeigten Token-Raten werden über die lokale Streaming-API gemessen. Sie sind weder Ergebnisse von rknn3_session_test noch eine Leistungsgarantie für andere Konfigurationen.
Voraussetzungen
- Ein reComputer RK3576 mit installiertem und erkanntem RK1820-Beschleuniger.
- Eine kompatible Laufzeitumgebung auf dem Board mit verfügbarem
rkllm3-server. - Python 3 und
venvfür die FastAPI-Oberfläche. Die Python-Abhängigkeiten stehen in derrequirements.txtdes Projekts;start_ui.shinstalliert sie mit pip. - Ein separat bereitgestelltes Qwen3-1.7B-Modellpaket für RK1820. Das Startskript erwartet
Qwen3-1.7B-25088.rknn,Qwen3-1.7B.weight,Qwen3-1.7B.tokenizer.ggufundQwen3-1.7B.embed.bininMODEL_DIR.
Projekt ausführen
Klonen Sie das Repository und wechseln Sie in das Projektverzeichnis:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-1p5b-benchmark
chmod +x *.sh
./check_env.sh
Der Verzeichnisname im Quellrepository enthält noch 1p5b; README, Konfiguration und Startskript dieses Projekts verwenden jedoch Qwen3-1.7B. Geben Sie im ersten Terminal mit MODEL_DIR das passende Modellpaket an und starten Sie den Modelldienst:
MODEL_DIR=/path/to/Firefly-Qwen3-1.7B-RK1820 ./start_model_server.shLassen Sie ihn weiterlaufen. Starten Sie in einem zweiten Terminal aus demselben Verzeichnis die Oberfläche:
./start_ui.shÖffnen Sie im selben Netzwerk http://<RK3576-IP>:7863 im Browser. Die Oberfläche verbindet sich standardmäßig mit http://127.0.0.1:8080 auf dem Board. Die Skripte verwenden standardmäßig 25,088 Token Kontext. Wenn Sie den Wert ändern, benötigen Sie ein entsprechendes Modellpaket; CTX_SIZE des Servers und SERVER_CONTEXT der Oberfläche müssen übereinstimmen.
Quellcode und Hinweise
Die Modelldateien und eine kompatible Laufzeitumgebung auf dem Board müssen separat vorbereitet werden. Die Oberfläche ist für ein vertrauenswürdiges lokales Netzwerk gedacht; prüfen Sie die Zugriffskontrolle, bevor Sie sie außerhalb dieses Netzwerks verfügbar machen.