这个项目在配备 RK1820 加速模块的 reComputer RK3576 上本地运行 Qwen3-1.7B。网页界面集中展示三类测试:首轮响应、长文本“大海捞针”检索和多轮对话记忆。模型服务与网页都运行在板端。
演示内容
| 测试 | 检查内容 |
|---|---|
| 首轮响应 | 使用全新 KV 缓存处理一个问题时的响应情况。 |
| 大海捞针 | 能否从长文本中找回隐藏的信息。 |
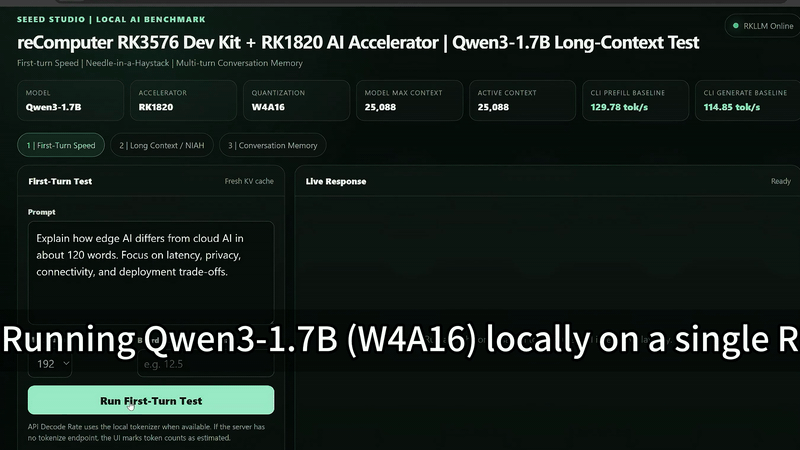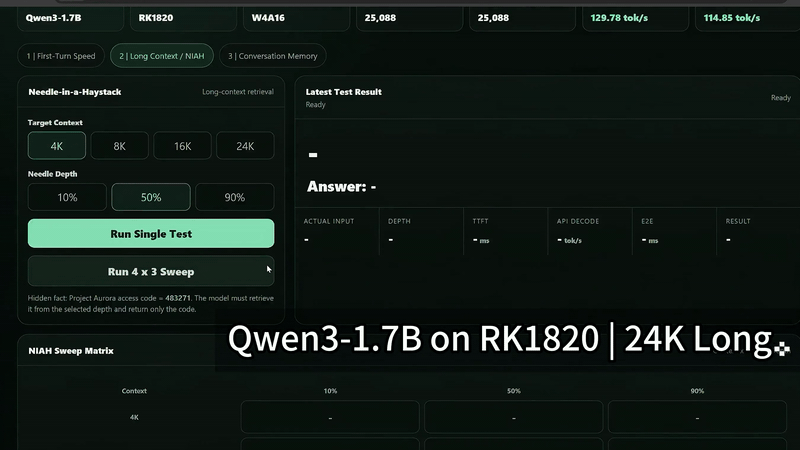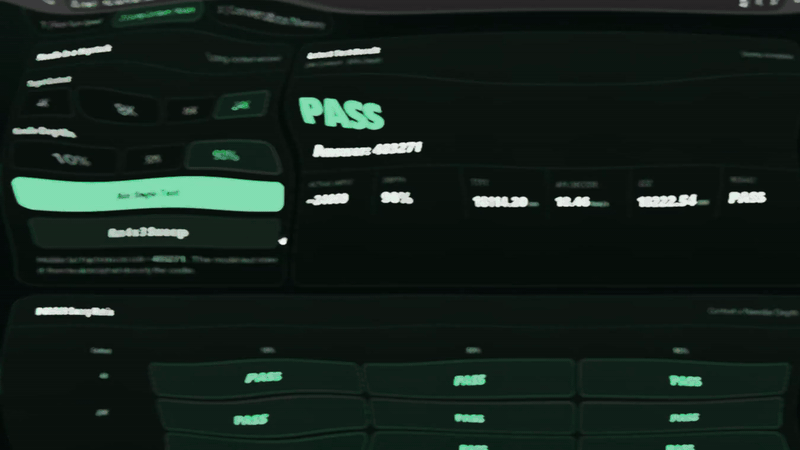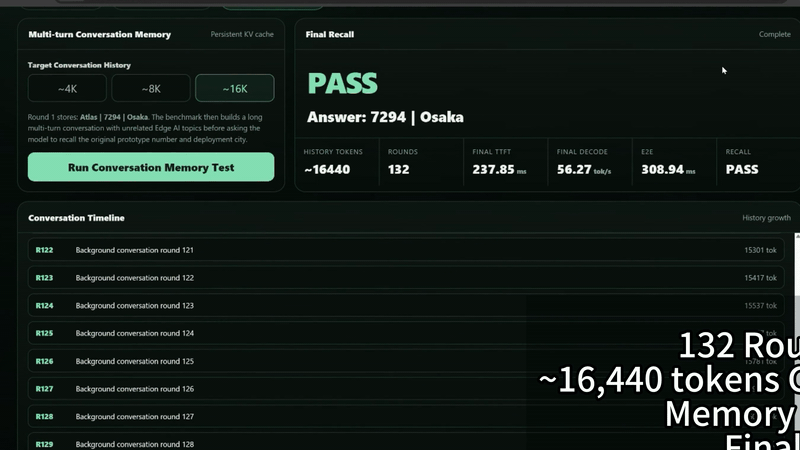
| 多轮对话记忆 | 经过多轮对话后,能否记住之前给出的信息。 |
演示视频展示的是 Qwen3-1.7B W4A16 模型,模型上下文长度为 25,088 token。页面上的 token 速率通过本地流式 API 测得,与 rknn3_session_test 的结果不是同一口径,也不代表其他环境一定能达到相同表现。
硬件与环境
- reComputer RK3576,并已安装、识别 RK1820 加速模块。
- 板端有兼容的运行环境,能够调用
rkllm3-server。 - 用于 FastAPI 网页的 Python 3 和
venv。Python 依赖列在项目的requirements.txt中,start_ui.sh会通过 pip 安装。 - 另行准备适用于 RK1820 的 Qwen3-1.7B 模型包。启动脚本要求
MODEL_DIR下有Qwen3-1.7B-25088.rknn、Qwen3-1.7B.weight、Qwen3-1.7B.tokenizer.gguf和Qwen3-1.7B.embed.bin。
运行项目
获取代码并进入项目目录:
bash
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-1p5b-benchmark
chmod +x *.sh
./check_env.sh
上游目录名仍包含 1p5b,但项目 README、配置和启动脚本实际使用的是 Qwen3-1.7B。在第一个终端将 MODEL_DIR 指向匹配的模型包,启动模型服务:
bash
MODEL_DIR=/path/to/Firefly-Qwen3-1.7B-RK1820 ./start_model_server.sh保持模型服务运行。在第二个终端进入同一目录,启动网页:
bash
./start_ui.sh在同一局域网的浏览器打开 http://<RK3576-IP>:7863。网页默认连接板端的 http://127.0.0.1:8080。脚本默认使用 25,088-token 上下文;如果调整上下文长度,模型包应支持该长度,且模型服务的 CTX_SIZE 与网页的 SERVER_CONTEXT 应保持一致。
源码与说明
模型文件与兼容的板端运行环境需要另行准备。网页适用于可信的局域网环境;如需对外提供访问,应先检查访问控制。