Ejecuta Qwen3-1.7B localmente en un reComputer RK3576 con un acelerador RK1820. La interfaz web reúne tres pruebas: primera respuesta, recuperación de información oculta en un texto largo y memoria de una conversación de múltiples turnos. Tanto el servicio del modelo como la interfaz se ejecutan en la placa.
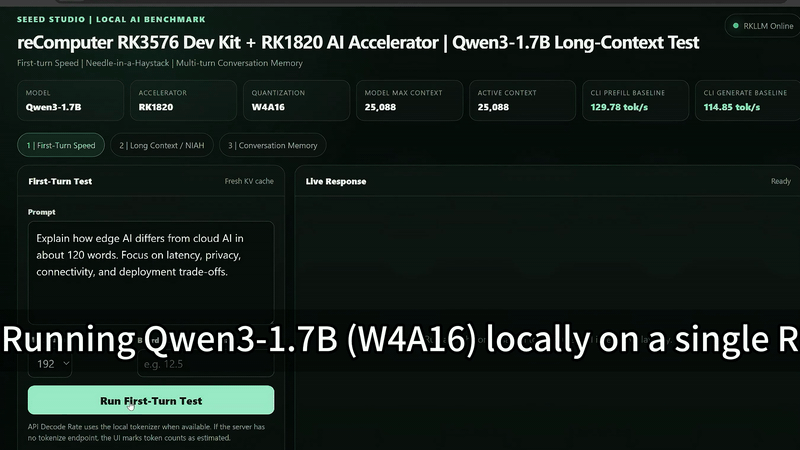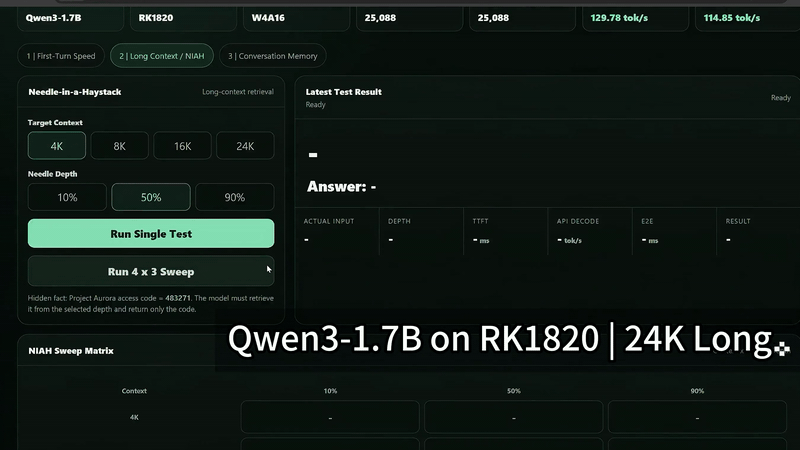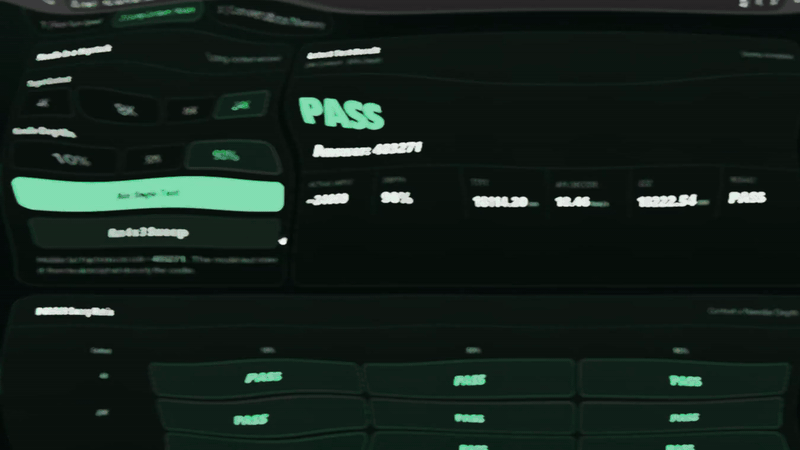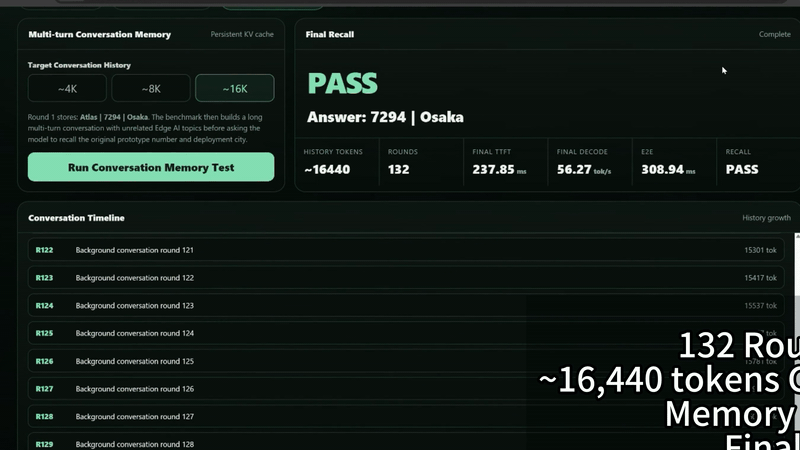
Qué muestra la demostración
| Prueba | Qué comprueba |
|---|---|
| Primera respuesta | La respuesta a una nueva instrucción con la caché KV vacía. |
| Información en contexto largo | Si el modelo recupera un dato oculto en una entrada extensa. |
| Memoria conversacional | Si recuerda información anterior después de muchos turnos. |
La demostración grabada muestra un modelo Qwen3-1.7B W4A16 con un contexto de 25,088 tokens. Las tasas de tokens que aparecen en pantalla se miden mediante la API local de transmisión; no son resultados de rknn3_session_test ni garantizan el mismo rendimiento en otra configuración.
Requisitos
- reComputer RK3576 con un acelerador RK1820 instalado y reconocido.
- Un entorno de ejecución compatible en la placa con
rkllm3-serverdisponible. - Python 3 y
venvpara la interfaz FastAPI. Las dependencias de Python figuran enrequirements.txtdel proyecto;start_ui.shlas instala con pip. - Un paquete de modelo Qwen3-1.7B para RK1820 preparado por separado. El script de inicio espera encontrar
Qwen3-1.7B-25088.rknn,Qwen3-1.7B.weight,Qwen3-1.7B.tokenizer.ggufyQwen3-1.7B.embed.binenMODEL_DIR.
Ejecutar el proyecto
Clona el repositorio y entra en el directorio del proyecto:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-1p5b-benchmark
chmod +x *.sh
./check_env.sh
El nombre del directorio original todavía contiene 1p5b, pero el README, la configuración y el lanzador de este proyecto utilizan Qwen3-1.7B. En la primera terminal, indica con MODEL_DIR la ruta del paquete de modelo correspondiente e inicia el servicio:
MODEL_DIR=/path/to/Firefly-Qwen3-1.7B-RK1820 ./start_model_server.shDéjalo en ejecución. En una segunda terminal, desde el mismo directorio, inicia la interfaz:
./start_ui.shAbre http://<RK3576-IP>:7863 desde un navegador de la misma red. De forma predeterminada, la interfaz se conecta a http://127.0.0.1:8080 en la placa. Los scripts utilizan un contexto de 25,088 tokens por defecto; si lo modificas, usa un paquete de modelo compatible y mantén iguales CTX_SIZE en el servidor y SERVER_CONTEXT en la interfaz.
Código fuente y notas
Los archivos del modelo y un entorno de ejecución compatible en la placa deben prepararse por separado. La interfaz está pensada para una red local de confianza; revisa el control de acceso antes de exponerla fuera de esa red.