Voer Qwen3-1.7B lokaal uit op een reComputer RK3576 met RK1820-versneller. De browserinterface combineert drie tests: de eerste respons, het terugvinden van verborgen informatie in een lange tekst en geheugen over meerdere gespreksbeurten. Zowel de modelservice als de interface draaien op het bord.
Wat de demo laat zien
| Test | Wat wordt gecontroleerd |
|---|---|
| Eerste respons | De respons op een nieuwe prompt met een lege KV-cache. |
| Zoeken in lange context | Of het model informatie terugvindt die in een lange invoer verborgen is. |
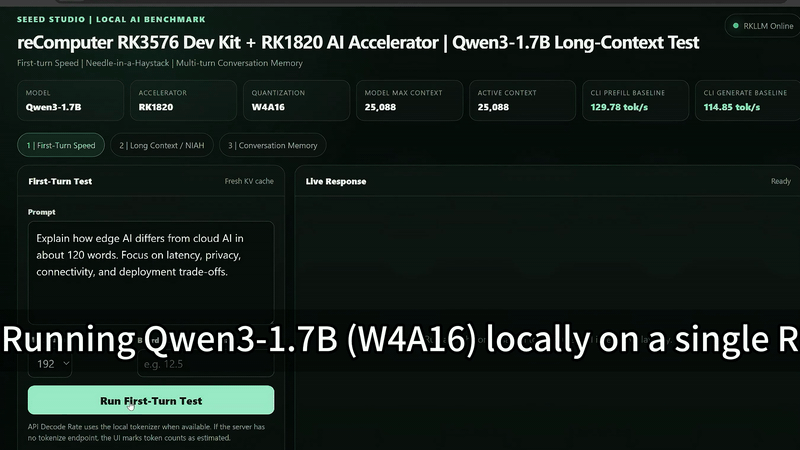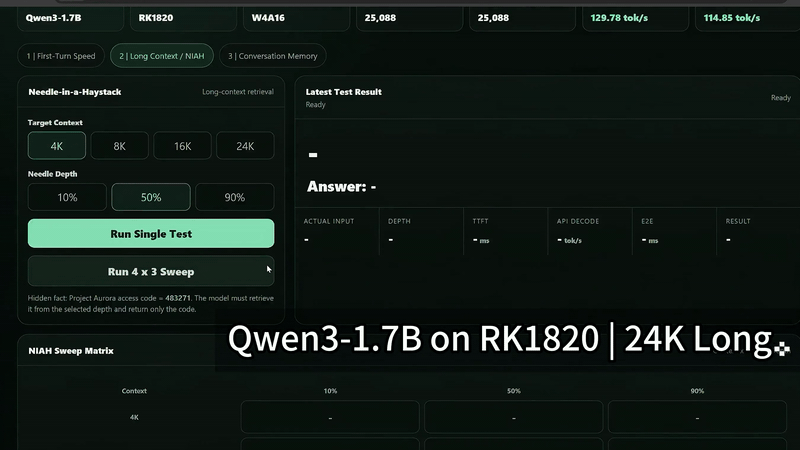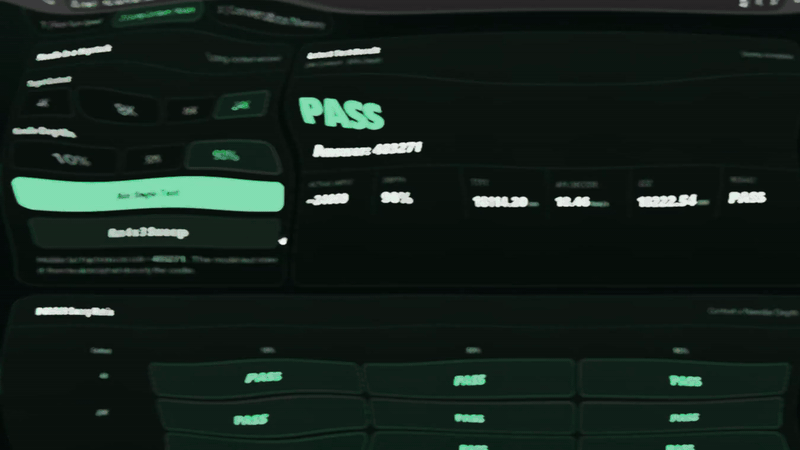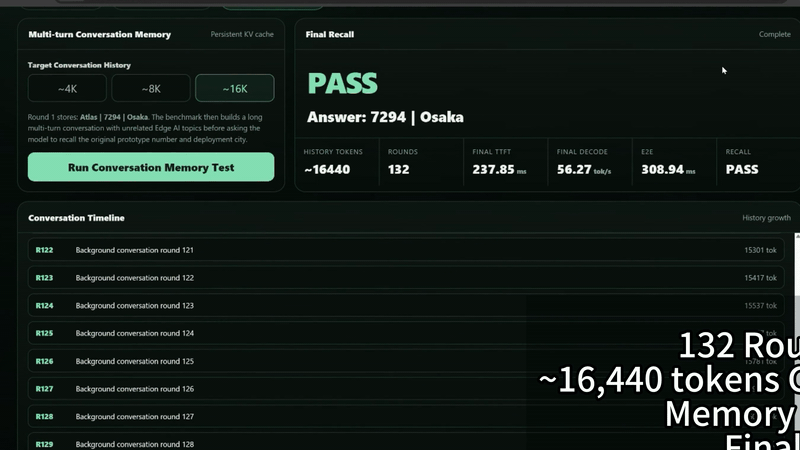
| Gespreksgeheugen | Of het model eerdere informatie na veel gespreksbeurten kan ophalen. |
De opgenomen demo toont een Qwen3-1.7B W4A16-model met een modelcontext van 25,088 tokens. De getoonde tokensnelheden zijn gemeten via de lokale streaming-API; het zijn geen resultaten van rknn3_session_test en geen prestatiegarantie voor andere configuraties.
Vereisten
- Een reComputer RK3576 met een geïnstalleerde en herkende RK1820-versneller.
- Een compatibele runtime op het bord waarin
rkllm3-serverbeschikbaar is. - Python 3 en
venvvoor de FastAPI-interface. De Python-afhankelijkheden staan in derequirements.txtvan het project;start_ui.shinstalleert ze met pip. - Een afzonderlijk voorbereid Qwen3-1.7B-modelpakket voor RK1820. Het startscript verwacht
Qwen3-1.7B-25088.rknn,Qwen3-1.7B.weight,Qwen3-1.7B.tokenizer.ggufenQwen3-1.7B.embed.bininMODEL_DIR.
Het project uitvoeren
Kloon de repository en ga naar de projectmap:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-1p5b-benchmark
chmod +x *.sh
./check_env.sh
De mapnaam in de bronrepository bevat nog 1p5b, maar de README, configuratie en het startscript van dit project gebruiken Qwen3-1.7B. Wijs in de eerste terminal met MODEL_DIR naar het juiste modelpakket en start de modelservice:
MODEL_DIR=/path/to/Firefly-Qwen3-1.7B-RK1820 ./start_model_server.shLaat de service draaien. Start in een tweede terminal vanuit dezelfde map de interface:
./start_ui.shOpen http://<RK3576-IP>:7863 in een browser op hetzelfde netwerk. De interface maakt standaard verbinding met http://127.0.0.1:8080 op het bord. De scripts gebruiken standaard een context van 25,088 tokens. Gebruik bij een wijziging een passend modelpakket en houd CTX_SIZE van de server en SERVER_CONTEXT van de interface gelijk.
Broncode en opmerkingen
De modelbestanden en een compatibele runtime op het bord moeten apart worden voorbereid. De interface is bedoeld voor een vertrouwd lokaal netwerk; controleer de toegangsbeveiliging voordat je haar buiten dat netwerk beschikbaar stelt.