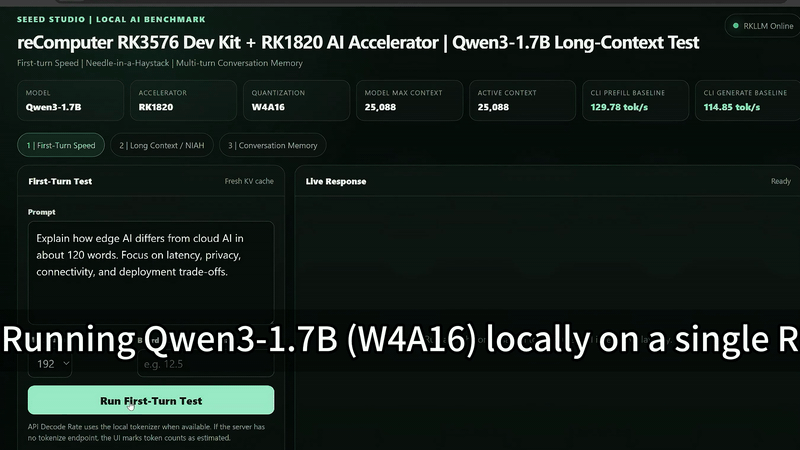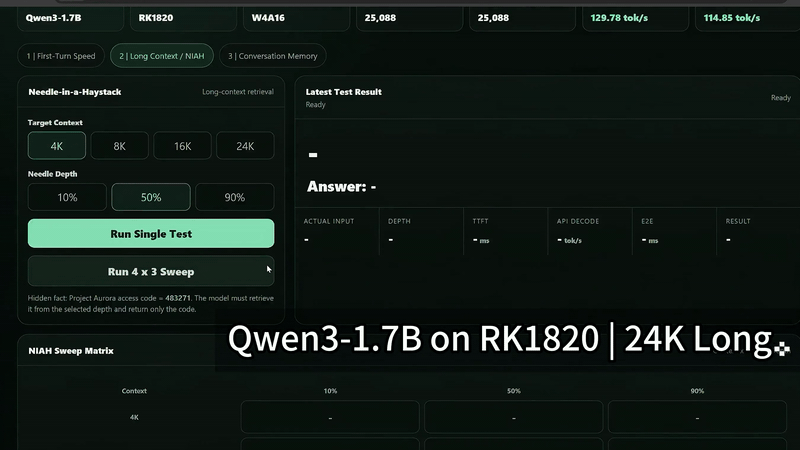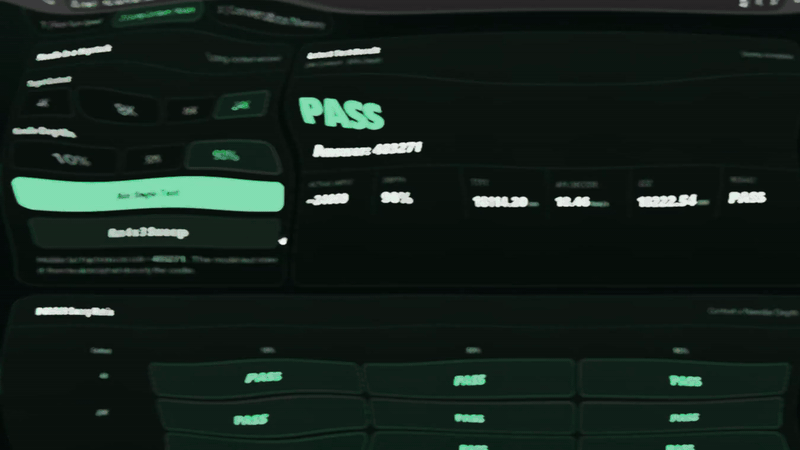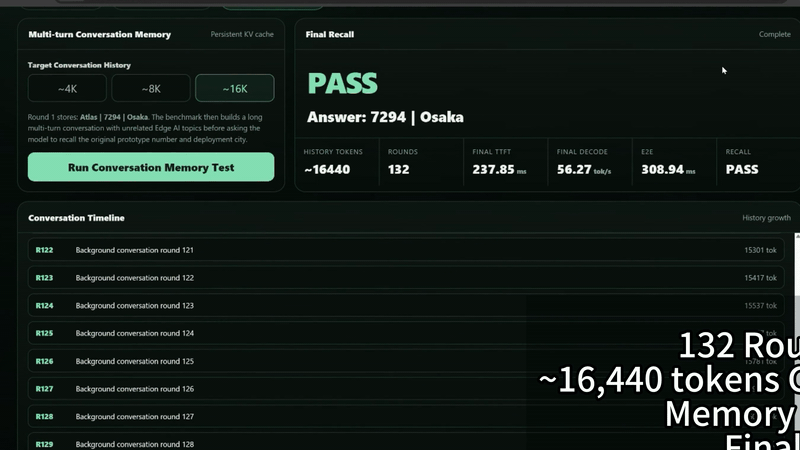
Exécutez Qwen3-1.7B localement sur un reComputer RK3576 équipé d'un accélérateur RK1820. L'interface Web regroupe trois tests : première réponse, recherche d'une information cachée dans un long texte et mémoire d'une conversation à plusieurs tours. Le service du modèle et l'interface fonctionnent tous deux sur la carte.
Contenu de la démonstration
| Test | Ce qu'il vérifie |
|---|---|
| Première réponse | La réponse à une nouvelle requête avec un cache KV vierge. |
| Recherche dans un long contexte | La capacité à retrouver une information cachée dans une longue entrée. |
| Mémoire conversationnelle | La capacité à rappeler une information antérieure après de nombreux échanges. |
La démonstration enregistrée utilise un modèle Qwen3-1.7B W4A16 avec un contexte de 25,088 tokens. Les débits de tokens affichés sont mesurés via l'API locale de streaming : ce ne sont ni des résultats de rknn3_session_test, ni une garantie de performances sur une autre configuration.
Prérequis
- Un reComputer RK3576 avec un accélérateur RK1820 installé et reconnu.
- Un environnement d'exécution compatible sur la carte, avec
rkllm3-serverdisponible. - Python 3 et
venvpour l'interface FastAPI. Les dépendances Python figurent dans le fichierrequirements.txtdu projet ;start_ui.shles installe avec pip. - Un paquet de modèle Qwen3-1.7B pour RK1820 préparé séparément. Le script de démarrage attend
Qwen3-1.7B-25088.rknn,Qwen3-1.7B.weight,Qwen3-1.7B.tokenizer.ggufetQwen3-1.7B.embed.bindansMODEL_DIR.
Exécuter le projet
Clonez le dépôt et accédez au dossier du projet :
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-1p5b-benchmark
chmod +x *.sh
./check_env.sh
Le nom du dossier amont contient encore 1p5b, mais le README, la configuration et le script de lancement du projet utilisent bien Qwen3-1.7B. Dans un premier terminal, faites pointer MODEL_DIR vers le paquet de modèle correspondant, puis démarrez le service :
MODEL_DIR=/path/to/Firefly-Qwen3-1.7B-RK1820 ./start_model_server.shLaissez-le fonctionner. Dans un second terminal, depuis le même dossier, démarrez l'interface :
./start_ui.shSur un navigateur du même réseau, ouvrez http://<RK3576-IP>:7863. Par défaut, l'interface se connecte à http://127.0.0.1:8080 sur la carte. Les scripts utilisent un contexte de 25,088 tokens par défaut ; si vous le modifiez, utilisez un paquet de modèle compatible et gardez CTX_SIZE côté serveur et SERVER_CONTEXT côté interface à la même valeur.
Source et remarques
Les fichiers du modèle et l'environnement d'exécution compatible sur la carte doivent être préparés séparément. L'interface est destinée à un réseau local de confiance ; vérifiez le contrôle d'accès avant de l'exposer au-delà de ce réseau.