RK3588 開発ボードを購入し、6 TOPS の NPU に期待しながら電源投入、イメージ書き込み、起動まで成功したとします。続いて RK3588 用の YOLO サンプルを見つけて実行すると、次のような表示が出ます。
rknpu driver version is too low
failed to initialize rknn runtime
invalid rknn model
unsupported target platform
failed to submit task
何が起きたのでしょうか。
汎用ではないエッジコンピューティング環境へ初めて AI アプリを展開する際、多くの人が同様の状況に遭遇します。 PC では動くプログラムが、なぜボードへ移すと動かないのでしょうか。 変換に成功しても、なぜボード上で実行できないのでしょうか。 同じモデルが一方のボードでは動き、別のボードでは動かないのはなぜでしょうか。
この記事では、Rockchip ソリューションで NPU を使う仕組みを分かりやすく詳しく説明します。
主に次の疑問へ回答します。
- RKNN-Toolkit2、RKNN Runtime、RKNPU ドライバーとは何か。
librknnrt.soを更新しても動かないのはなぜか。rknpu.koを安易に置き換えてはいけないのはなぜか。- CNN、Transformer、LLM の展開経路はどう異なるか。
- 問題がモデル、Runtime、ドライバー、システムイメージのどこにあるか判断する方法。
- NPU を使うべきでないのはどのような場合か。
1. 全体像:RK NPU は単一のソフトウェアパッケージではない
「NPU を呼び出す」という表現は、モデルと画像を渡せば計算が始まる一つの関数のように聞こえます。しかし PyTorch モデルを NPU で実行するまでには、モデル変換ツール、モデルファイル、ボード側 Runtime、Linux カーネルドライバー、NPU ハードウェアという少なくとも五つの要素があります。
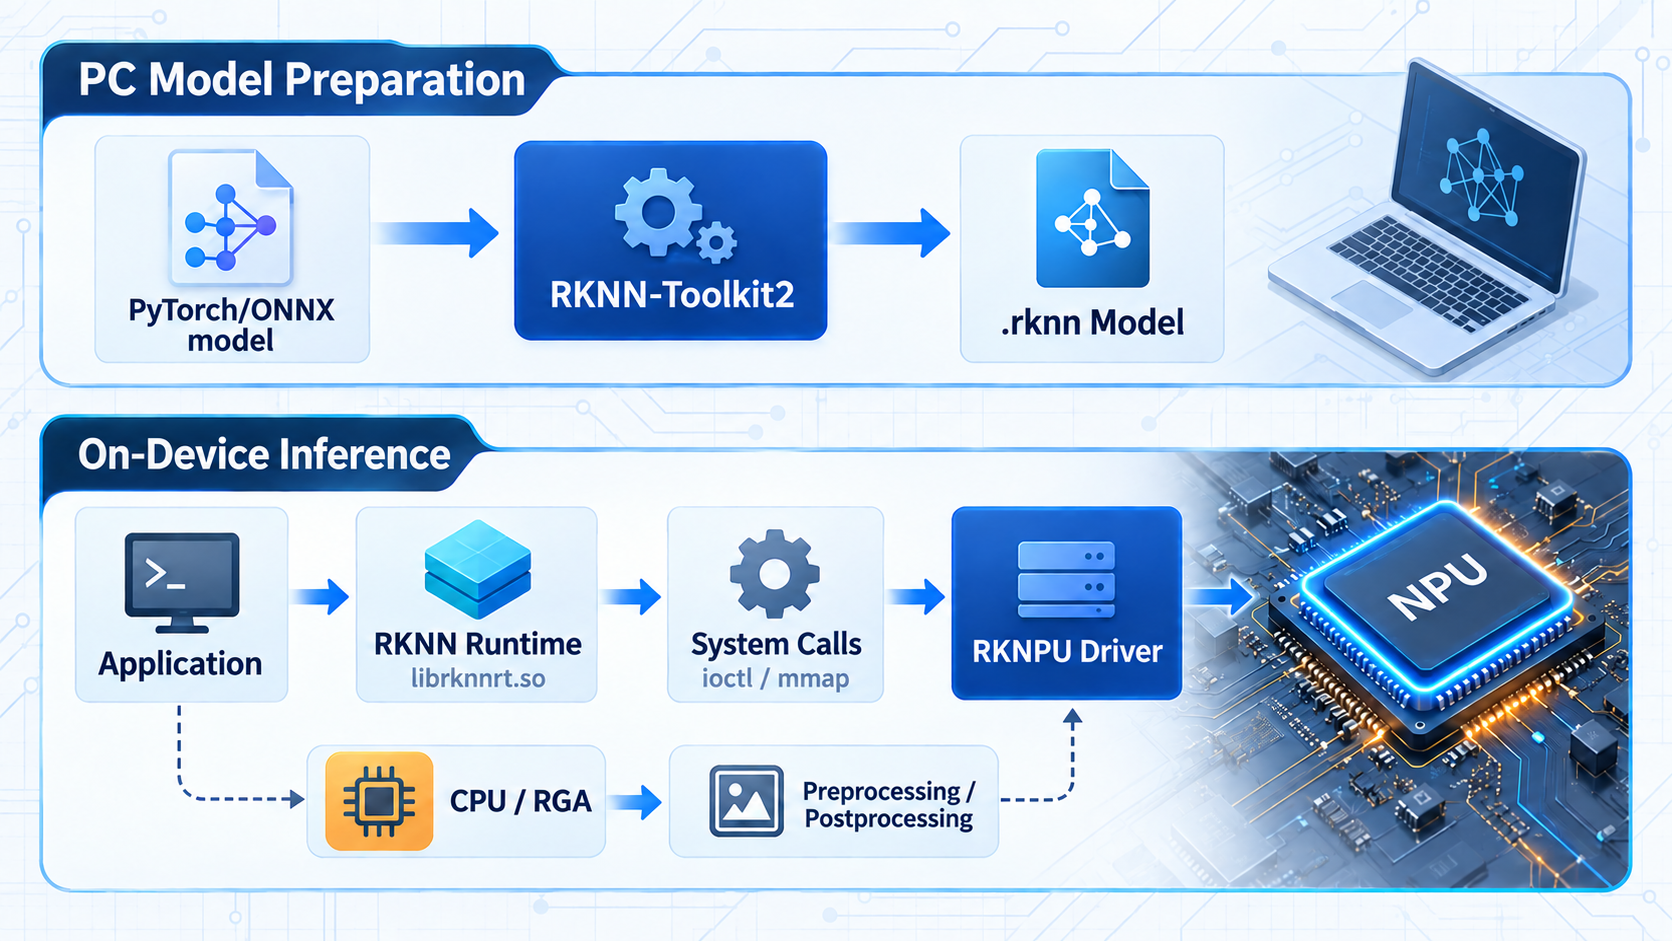
この流れは二つの段階に分けられます。
第1段階は PC 上でのモデル準備です。
PyTorch / TensorFlow
        ↓
       ONNX
        ↓
RKNN-Toolkit2
        ↓
RK3588 または RK3576 向けにコンパイルされた .rknn モデル
第2段階は開発ボード上でのモデル実行です。
アプリケーション
   ↓
RKNNLite / RKNN C API
   ↓
librknnrt.so
   ↓
Linux システムコール
   ↓
RKNPU カーネルドライバー
   ↓
NPU ハードウェア
各コンポーネントの役割は異なります。
| コンポーネント | 実行場所 | 主な役割 |
|---|---|---|
| RKNN-Toolkit2 | PC | モデルの解析、最適化、量子化、コンパイル |
.rknn | PC で生成、ボードで読み込み | 特定の Rockchip NPU 向けモデルと実行情報を保存 |
| RKNN-Toolkit-Lite2 | ボード上の Python 環境 | Python アプリへ推論 API を提供 |
librknnrt.so | ボードのユーザー空間 | モデル読み込み、メモリ管理、ドライバーへのタスク送信 |
| RKNPU ドライバー | Linux カーネル空間 | NPU、メモリ、割り込み、タスクスケジューリングを管理 |
| NPU | SoC 内部 | 畳み込みや行列積などを実行 |
公式の構成も同じです。詳しくは RKNN-Toolkit2 公式リポジトリを参照してください。
問題が起きたら「NPU が壊れた」「RKNN が動かない」と一括りにせず、どの層の問題かを先に判断します。
2. .rknn モデルの生成方法
NPU は通常の PyTorch モデルを直接実行できず、一般に ONNX も直接実行しません。ONNX は計算グラフ交換用の中間形式であり、.rknn は Rockchip ツールチェーンで最適化・コンパイルされた展開用モデルです。
一般的な ONNX モデルの最小変換手順は次のとおりです。
from rknn.api import RKNN

rknn = RKNN(verbose=True)

rknn.config(
    target_platform="rk3576",
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
)

rknn.load_onnx(model="model.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("model_rk3576.rknn")
rknn.release()
見落としやすいのが target_platform です。生成モデルが特定チップ向けにコンパイルされることを示し、.rknn は ONNX のような汎用形式ではありません。RK3588 向けモデルが RK3576、RK3568 などでそのまま動くとは限りません。
RKNN-Toolkit2 はビルド時に次の処理も行います。
- 計算グラフと Tensor Shape の解析。
- 定数畳み込みと不要ノードの削除。
- 複数処理を NPU 向けの演算子へ融合。
- NCHW、NHWC などのデータレイアウト変換。
- 演算子、データ型、Shape が対象プラットフォームで対応するか確認。
- 設定に従って FP16、INT8 などへ量子化。
- 対象 NPU 用の実行グラフと重みデータを生成。
よくある誤解は、ONNX Runtime で動いても RKNN 変換できるとは限らず、RKNN 変換に成功してもボードで読み込めるとは限らないことです。
変換段階はモデルとコンパイラーに依存し、ボードでの読み込みは Runtime、ドライバー、メモリ、対象チップにも依存します。
3. Runtime とは何か
RK3588/RK3576 の Linux では、ボード側 Runtime の中心は通常次のファイルです。
librknnrt.soこれはユーザー空間の共有ライブラリであり、Linux カーネルドライバーでも完全な「システム環境」でもありません。アプリの高水準 API は最終的にこのライブラリへ到達します。
Python アプリの一般的な呼び出し経路は次のとおりです。
Python アプリケーション
   ↓
RKNNLite
   ↓
librknnrt.so
   ↓
RKNPU ドライバー
C/C++ アプリでは次のようになります。
C/C++ アプリケーション
   ↓
RKNN C API
   ↓
librknnrt.so
   ↓
RKNPU ドライバー
ボード上の最小 Python 推論プログラムは次のとおりです。
from rknnlite.api import RKNNLite

runtime = RKNNLite()

ret = runtime.load_rknn("model_rk3576.rknn")
if ret != 0:
    raise RuntimeError("load_rknn failed")

ret = runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)
if ret != 0:
    raise RuntimeError("init_runtime failed")

outputs = runtime.inference(inputs=[input_tensor])
runtime.release()
init_runtime() は環境をインストールする処理ではなく、現在のプロセス用に推論コンテキストを作成します。内部処理には次が含まれます。
- チップとドライバーを確認。
- RKNN モデルを解析。
- モデルと Runtime の互換性を確認。
- NPU コアを選択。
- 重みと中間 Tensor 用メモリを準備。
- ドライバーへタスクを送るためのリソースを作成。
簡単に言えば Runtime は「翻訳者兼スケジューラー」です。アプリの要求をドライバーが理解できるタスクへ変換し、ドライバーが NPU を制御します。
rknn_server は必須か
必須ではありません。rknn_server は主に PC の RKNN-Toolkit2 からボードへ接続し、実機デバッグ、性能分析、リモート推論を行うために使います。USB または ADB 経由の要求を受け、ボード側 Runtime を呼び出します。
アプリがボード上で単独実行される場合、通常は librknnrt.so を直接呼び出せるため、毎回 rknn_server を経由する必要はありません。
4. Linux における RKNPU ドライバーの位置
Linux は通常のアプリとハードウェアを分離します。ユーザー空間のアプリは NPU レジスターや割り込み、任意の物理メモリへ直接アクセスできないため、カーネル空間の RKNPU ドライバーが処理します。
ユーザー空間:アプリケーション → RKNNLite / RKNN API → librknnrt.so
                         │
                    システムコール境界
                         │
カーネル空間:       RKNPU ドライバー
                         │
ハードウェア:       NPU
ドライバーの主な役割は次のとおりです。
- NPU ハードウェアを初期化。
- クロック、電源ドメイン、リセットを管理。
- NPU がアクセスするメモリを管理。
- Runtime から計算タスクを受信。
- NPU コアをスケジュール。
- 割り込みを処理しタスク完了を通知。
- IOMMU と連携してデバイスアドレスをマップ。
- ドライバーバージョンとハードウェア能力を Runtime に公開。
ioctl と mmap とは
Runtime とドライバーはユーザー空間とカーネル空間の境界を越えて通信します。一般的な仕組みは ioctl、mmap、poll、DMA によるメモリ共有です。
ioctlはコンテキスト作成、タスク送信、状態照会などデバイス固有の命令を送ります。mmapはドライバー管理バッファーをアプリの仮想アドレス空間へマップします。DMAはCPUが1バイトずつコピーせずにNPUがメモリへ直接アクセスできるようにします。pollなどはハードウェアタスクの完了を待ちます。
簡単には次のように理解できます。
mmap:データの配置場所と両側からのアクセス方法を解決
ioctl:デバイスに実行させる操作を指定
これらの低水準処理は通常 librknnrt.so に隠されています。1回の inference() 内部でメモリ同期、タスク送信、完了待ちなどが行われます。
この構造は NIC や USB デバイスと本質的に同じです。ネットワークアプリは Socket と Linux ネットワークスタックを、libusb は USB Core とコントローラードライバーを、RKNN アプリは Runtime と RKNPU ドライバーを介して各ハードウェアへアクセスします。
5. バージョン互換性が重要な理由
RKNN は単一のバージョン番号だけを持つパッケージではありません。完全な展開には少なくとも次のバージョンが関係します。
RKNN-Toolkit2 バージョン
        ↓
.rknn モデル形式とターゲットチップ
        ↓
RKNN-Toolkit-Lite2 / librknnrt.so バージョン
        ↓
RKNPU ドライバーバージョン
        ↓
Linux カーネルと BSP
実機デバッグでは rknn_server のバージョンも関係します。C/C++ 開発ではヘッダーとリンクライブラリが同じ SDK 由来か確認してください。
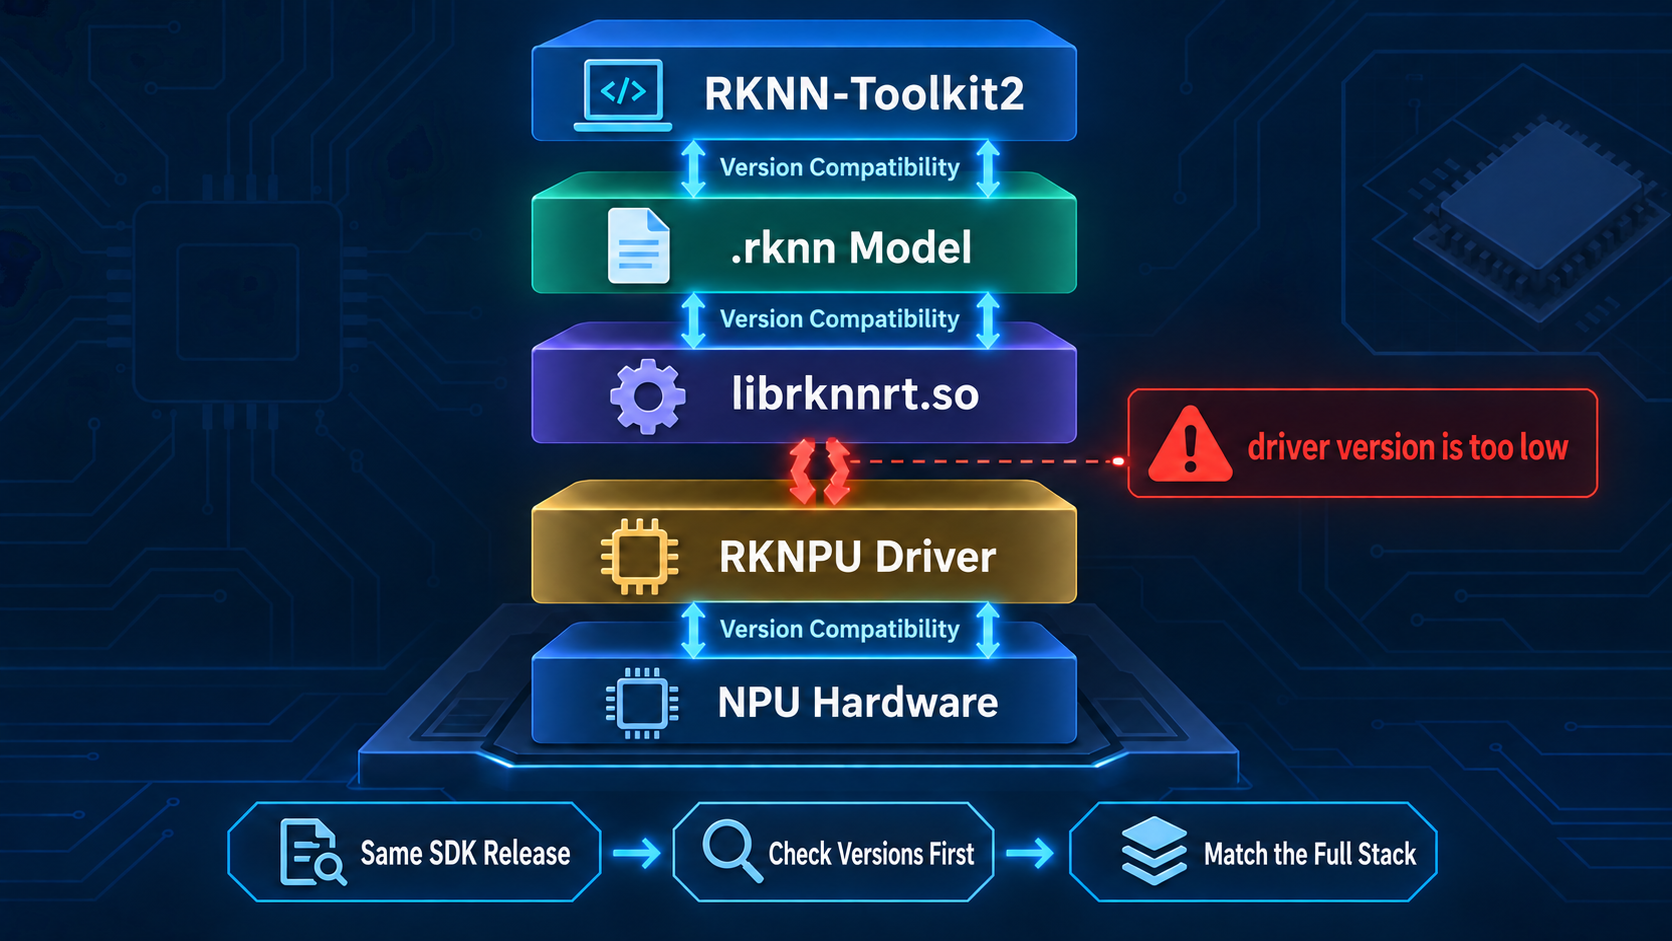
代表的な非互換は次のとおりです。
- 新しい Toolkit で生成したモデルを古いボード Runtime が解析できない。
librknnrt.soだけ更新し、新 Runtime が必要とするドライバー機能がない。- Python パッケージは新しいが、実際にはシステムディレクトリの古い Runtime を読み込む。
rknn_serverとボード Runtime のリリースが異なる。- モデルは RK3588 向けだが、実機は RK3576。
- コンテナ内 Runtime は新しいが、ホストのカーネルドライバーは古い。
RK ベースのボードでは公式資料を必ず確認してください。資料が古いまま最新の AI アプリやモデルを動かすと、上記の問題が発生しやすくなります。
Seeed Studio の reComputer AI Lab は、RK3588、RK3576 などの最新 AI 開発資料を集約しており、お勧めです。 CV、LLM、VLM をワンクリックで展開でき、RK ボードの問題を解決する詳しいツールや資料、学習・開発の参考になるオープンソースの実践プロジェクトもあります。
これは開発者視点です。成熟製品では「すべてを最新にする」よりも、次の原則が安全です。
Toolkit、モデル、Runtime、Server、ドライバーには検証済みの互換構成を使用する。
6. rknpu driver version is too low が発生する仕組み
このエラーを見ると新しい rknpu.ko をダウンロードして上書きしたくなりますが、まず発生源を理解してください。
Runtime 初期化時、librknnrt.so は RKNPU ドライバーのバージョンと機能を照会します。Runtime が必要とするインターフェースや機能がドライバーより新しい場合、次を出力することがあります。
rknpu driver version is too low古いボードで最新の Rockchip アプリやモデルを動かし、ベンダーがシステムイメージや Wiki を更新していない場合によく起こります。ボード側 Runtime だけを更新すると不一致になります。 出荷当初から十分な資料を提供しないベンダーもあります。価格だけで選ばず、資料不足が後の問題につながる点を考慮してください。
これは通常 Runtime とドライバーの不一致であり、このメッセージだけでドライバーファイルの破損とは断定できません。
一般的な原因は次のとおりです。
librknnrt.soだけを更新し、BSP やドライバーを更新していない。- 複数の
librknnrt.soがあり、アプリが誤った版を読み込んだ。 - 新モジュールをディスクへコピーしたが、実行中カーネルは旧ドライバーを使用中。
- RKNPU ドライバーがカーネル組み込みで、
.koの置換が無効。 - 新モジュールが現行カーネルの
vermagic、シンボル、設定と一致せず読み込み失敗。 - コンテナは新しいユーザー空間ライブラリを使うが、ホストドライバーは古い。
- ベンダー独自 BSP と Runtime が同じ検証済みリリース構成ではない。
まず次の情報を収集します。
# カーネルバージョンを確認
uname -a

# RKNPU ドライバーの初期化とエラー情報を確認
dmesg | grep -i rknpu

# ドライバーがモジュールとして読み込まれている場合、現在のモジュールを確認
lsmod | grep rknpu

# ディスク上のモジュール情報を確認。パスは実際のシステムに合わせて調整
modinfo rknpu

# システム内のすべての Runtime コピーを検索
find / -name 'librknnrt.so*' 2>/dev/null

# アプリケーションがリンクする共有ライブラリを確認
ldd ./your_application
実行中プロセスについては次も確認できます。
grep librknnrt /proc/$(pidof your_application)/mapsこれにより、想定したものではなく、実際にどの librknnrt.so を読み込んだかが分かります。
次の順序で対処することを推奨します。
現在のカーネルとドライバーのバージョンを確認
        ↓
アプリケーションが実際に読み込んだ Runtime を確認
        ↓
モデルのターゲットチップと変換ツールのバージョンを確認
        ↓
ボードベンダーが提供する互換 SDK またはシステムイメージを検索
        ↓
必要に応じて BSP 全体をアップグレードするか、現在のカーネルソースに対してドライバーを再ビルド
7. rknpu.ko を安易に置き換えてはいけない理由
.ko は Linux カーネルモジュールであり、通常のユーザー空間共有ライブラリではありません。カーネル空間で動くため、現行カーネルと厳密に一致する必要があります。
まずドライバーのビルド方式を確認します。
CONFIG_ROCKCHIP_RKNPU=y   ドライバーをカーネルに組み込む
CONFIG_ROCKCHIP_RKNPU=m   ドライバーを独立モジュールとしてビルド
カーネル組み込みなら、起動時にカーネルイメージ内のドライバーを使います。新しい rknpu.ko をコピーしても置き換わらず、通常はカーネルまたはシステムイメージ全体の更新が必要です。
モジュール形式でも、単独更新には次の条件が必要です。
- 現行カーネルソースまたは一致するソースツリーでビルド。
- 互換性のあるカーネル設定とクロスコンパイラを使用。
vermagicが一致。- 必要なカーネルシンボルが存在。
- Device Tree、電源ドメイン、クロック、IOMMU、予約メモリ設定が一致。
- NPU を使用中のプロセスがない。
- モジュール署名とセキュアブート方針が読み込みを許可。
実行カーネルとモジュール情報を比較します。
uname -r
modinfo ./rknpu.ko | grep vermagic
モジュールが読み込めてもシステム全体の互換性は保証されません。BSP 固有の Device Tree、電源管理、メモリパッチがあるため、次の優先順位を推奨します。
- ボードベンダーの完全なイメージまたは更新パッケージを優先。
- 次に、ベンダーの対応 BSP からカーネルとモジュールを再ビルド。
- カーネル、設定、依存関係の完全一致を確認した場合のみモジュール単体を置換。
- 作業前に起動可能な旧イメージと復旧手段を残す。
「RKNPU 0.9.8 へ更新」とは、ファイルシステムに 0.9.8 と書かれた .ko があることではなく、実行中カーネルが 0.9.8 ドライバーを読み込み、現行 Runtime と BSP に互換性があることを確認することです。
8. CNN、Transformer、LLM の展開経路
すべて AI モデルと呼ばれても、同じ展開経路を使うとは限りません。
CNN:代表的な RKNN 経路
画像分類、YOLO 検出、セマンティックセグメンテーション、姿勢推定などは通常次を使います。
PyTorch → ONNX → RKNN-Toolkit2 → .rknn → RKNN Runtime → NPU畳み込み、活性化、プーリングは NPU へマップしやすい一方、次に注意が必要です。
- 入力サイズとレイアウト。
- RGB/BGR 順序。
- mean、std とアプリ前処理の重複。
- INT8 量子化データセット。
- 検出ヘッドのデコードと NMS。
- カメラ、RGA、NPU 間のデータコピー。
一般的な Transformer:演算子と動的 Shape に注目
Vision Transformer や軽量エンコーダーも RKNN-Toolkit2 を試せますが、次に注意してください。
- MatMul;
- Softmax;
- LayerNorm または RMSNorm。
- reshape と transpose。
- 動的シーケンス長。
- 中間 Tensor メモリ。
- CPU または GPU 支援が必要な演算子。
名前に Transformer が含まれるだけで NPU 上ですべて動くとは限りません。計算グラフの演算子、Shape、データ型が対象プラットフォームに対応するかで決まります。
LLM:通常は RKLLM ツールチェーンを使用
大規模言語モデルには KV Cache、Prefill、トークン単位 Decode、長いコンテキスト、サンプリングもあります。Rockchip は独立した RKNN-LLM ツールチェーンを提供しています。
Hugging Face モデル
        ↓
RKLLM-Toolkit による変換と量子化
        ↓
.rkllm モデル
        ↓
RKLLM Runtime
        ↓
RKNPU ドライバーと NPU
RKLLM も RKNPU ドライバーに依存しますが、通常の CNN の RKNN モデル、Runtime API、実行方式とは同一ではありません。対応モデルは該当バージョンの公式一覧で確認してください。
9. RK3588 で大規模モデルを動かす二つの経路
RK3588 での一般的な選択肢は二つに整理できます。
経路1:GGUF + llama.cpp + CPU
導入が簡単でモデル資産が多く、デバッグしやすい方法です。メモリ容量に合う GGUF 量子化モデルなら、通常 RKNN 変換や RKNPU ドライバーバージョンを扱う必要がありません。
次の場合に適しています。
- モデル機能を素早く検証。
- モデルを頻繁に切り替える。
- 互換性を優先。
- チームに NPU 適応経験がない。
- モデルが RKLLM の対応範囲外。
代わりに CPU 使用率が高く、トークン速度、消費電力、並列処理能力が NPU 最適化構成より劣る場合があります。
経路2:RKLLM + NPU
推論スループット向上と CPU 負荷軽減を期待できますが、より多くのエンジニアリングが必要です。
- モデル構造が対応するか確認。
- 指定ツールチェーンで量子化・変換。
- RKLLM Runtime と RKNPU ドライバーを一致。
- 量子化後の精度を評価。
- モデル重み、KV Cache、システムメモリを計画。
- Prefill と Decode の速度を区別。
- 異なるコンテキスト長で安定性を確認。
したがって NPU 経路は「GGUF を NPU に渡す」ものではありません。別のモデル形式と Runtime を使い、固定モデル向けに適応します。
選択時の目安は次のとおりです。
| 要件 | 適した出発点 |
|---|---|
| できるだけ早く実行 | GGUF + CPU |
| 頻繁にモデルを変更 | GGUF + CPU |
| 固定モデルで高性能を追求 | RKLLM + NPU を評価 |
| 公式対応一覧にないモデル | CPU または別バックエンドを優先 |
| 量産準備 | NPU ソフトウェアスタック全体を固定して検証 |
どちらでも宣伝上の TOPS や単一演算子時間だけでなく、エンドツーエンド性能を測定してください。LLM はメモリ容量、帯域、KV Cache、CPU 側ロジックにも影響されます。
10. 汎用的な層別トラブルシューティング
エラーログを見たら、すぐ命令を検索・コピーするのではなく、失敗した層をまず特定します。
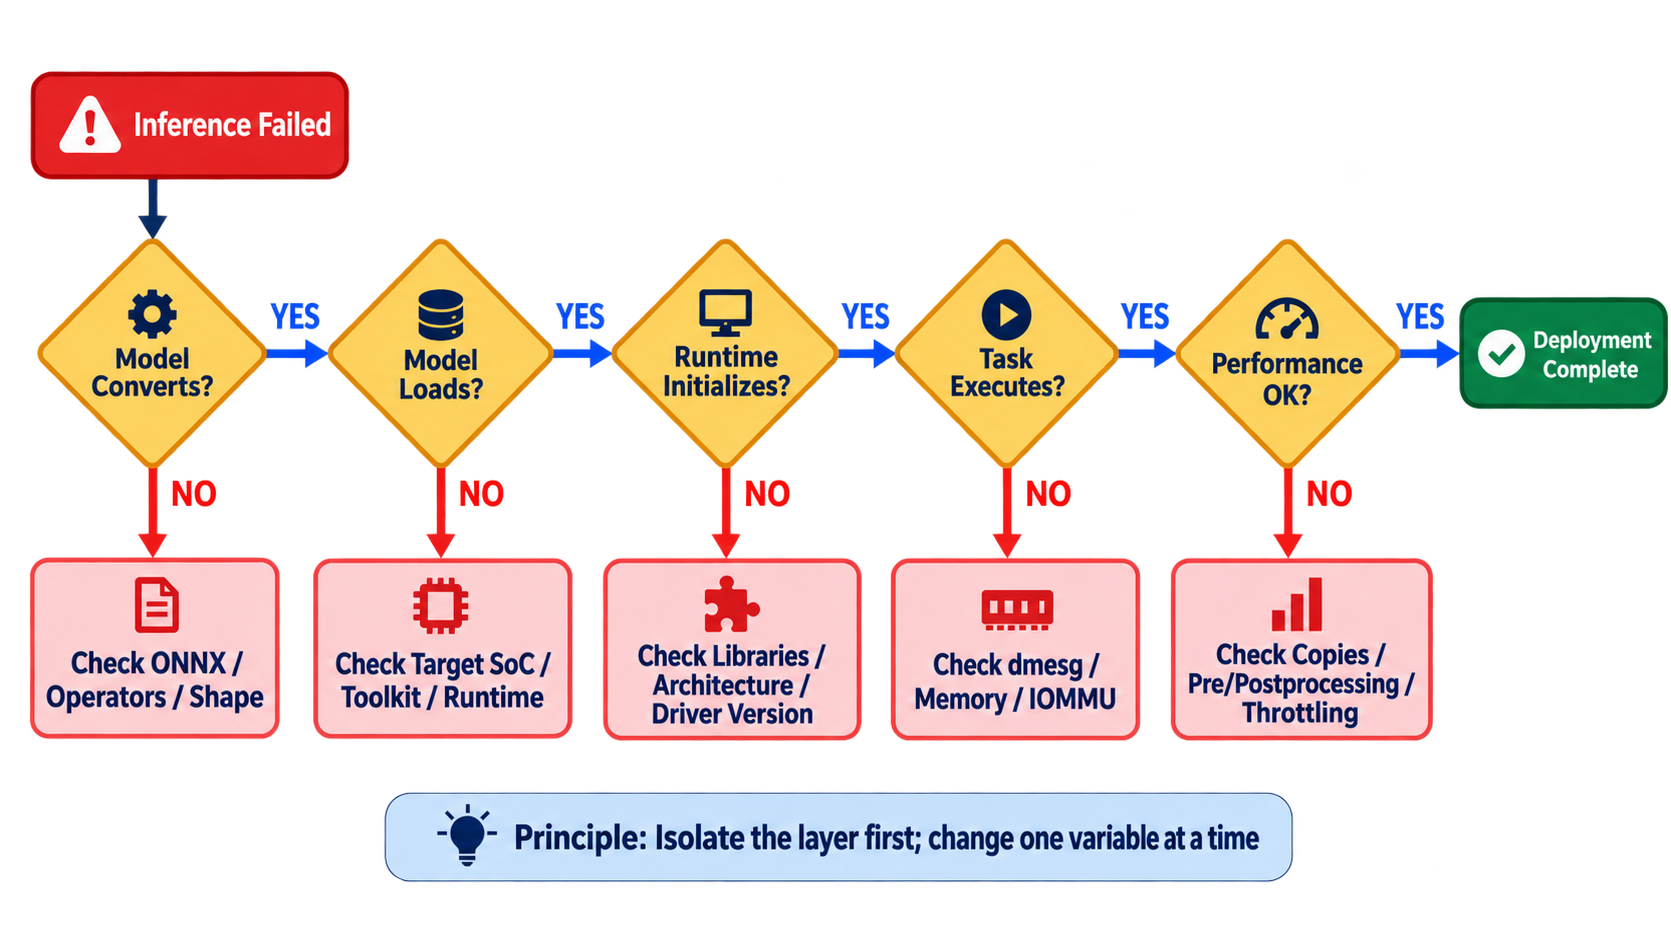
第1層:モデル変換
代表的な症状:
unsupported operator
shape inference failed
build model failed
ONNX の妥当性、Opset、入力 Shape、動的次元、演算子対応、変換ログを確認します。量子化時は校正データが実入力を代表するかも確認します。
第2層:モデル読み込み
代表的な症状:
invalid rknn model
unsupported target platform
load_rknn failed
生成した Toolkit 版、target_platform、ボード Runtime が形式を解析できるか、コピーしたファイルが完全かを確認します。
第3層:Runtime 初期化
代表的な症状:
failed to initialize rknn runtime
driver version is too low
cannot open shared object file
undefined symbol
共有ライブラリパス、CPU アーキテクチャ、32/64 bit、実際の Runtime 位置、ドライバー版、デバイスノードを確認します。
第4層:タスク実行
代表的な症状:
failed to submit task
IOMMU fault
allocate memory failed
dmesg を確認し、空きメモリ、CMA/DMA バッファー、IOMMU エラー、入力 Tensor 属性、同時タスクが資源上限を超えていないか調べます。
第5層:性能
モデルが動いても NPU 性能を十分に使えているとは限りません。次の時間は単一の rknn_run() 計測に含まれないことがあります。
- 画像の読み込みとデコード。
- resize、letterbox、色変換。
- CPU と NPU 間のデータコピー。
- 出力デコードと NMS。
- 不要な同期待ち。
- NPU コア選択。
- CPU、NPU、メモリのクロック低下。
- 高温によるサーマルスロットリング。
- 不適切なマルチスレッドパイプライン設計。
少なくとも次の時間を個別に記録してください。
入力読み込み時間
前処理時間
モデル推論のみの時間
後処理時間
エンドツーエンドの合計時間
NPU 推論時間だけを報告すると、見栄えは良くても実運用性能を表さない数字になります。
11. 質問や Issue 投稿前に収集する情報
自己解決できない場合、一つのエラーより完全な情報が重要です。少なくとも次を提示してください。
SoC モデル:
開発ボードのモデル:
オペレーティングシステムとイメージの入手元:
Linux カーネルバージョン:
RKNPU ドライバーバージョン:
RKNN-Toolkit2 バージョン:
RKNN-Toolkit-Lite2 バージョン:
RKNN Runtime バージョン:
rknn_server バージョン(使用している場合):
モデルの入手元と ONNX Opset:
ターゲットプラットフォーム:
量子化の有無:
完全なアプリケーションログ:
関連する dmesg ログ:
公式サンプルが実行可能か:
「公式サンプルが動くか」は特に重要です。
- 公式サンプルも失敗:システム、Runtime、ドライバーの可能性が高い。
- 公式サンプルは動き独自モデルは失敗:変換または入出力処理の可能性が高い。
- 同じモデルの C は動き Python は失敗:Python パッケージと共有ライブラリパスを優先確認。
- ホストは動きコンテナは失敗:デバイスマッピング、権限、コンテナ Runtime を優先確認。
12. 混同しやすい点
最後に、誤解されやすい点をまとめます。
- NPU 搭載チップでも、任意のニューラルネットワークを実行できるとは限らない。
- ONNX で動いても、RKNN 変換できるとは限らない。
- RKNN 変換成功は、ボード側バージョン互換性を保証しない。
librknnrt.soの更新はカーネルドライバーの更新ではない。- 新しい
rknpu.koのコピーは、新ドライバーの読み込みを意味しない。 - 新しいドライバーが現行カーネルと BSP に適合するとは限らない。
- NPU 使用時も、前処理、後処理、全演算子が NPU 上で動くとは限らない。
- 複数 NPU コアでも、単一モデル性能がコア数倍になるとは限らない。
- コンテナはユーザー空間 Runtime を含められるが、ホストのカーネルドライバーを置き換えられない。
- NPU 推論時間はアプリのエンドツーエンド時間ではない。
- 公称 TOPS が同じでも、チップ、モデル、精度ごとの実性能が同じとは限らない。