当你购买了一块RK3588开发版,看着6 Tops参数的NPU时,激动地上电、烧镜像、启动。一切顺利。然后费劲心思找到了一个运行在RK3588开发版上的YOLO程序案例。一运行:
rknpu driver version is too low
failed to initialize rknn runtime
invalid rknn model
unsupported target platform
failed to submit task
什么情况?
我相信很多人第一次在非通用的边缘计算平台部署AI应用时应该多多少少都遇到过这样的情况。 我在我的电脑上运行的好好的程序,为什么迁移程序到这里来就会运行不起来? 为什么转换成功但板端运行失败? 同一个模型在一块板子能跑,另一块不能跑?
这篇文章将深入浅出带你了解Rockchip方案中的NPU使用。
本文将在这些核心问题上进行详细解答,如有类似疑惑,可放心阅读:
- RKNN-Toolkit2、RKNN Runtime 和 RKNPU 驱动分别是什么?
- 为什么更新一个 librknnrt.so 仍然不能运行?
- 为什么不能随便替换 rknpu.ko?
- CNN、Transformer、LLM 的部署路线有什么区别?
- 如何判断问题发生在模型、Runtime、驱动还是系统镜像?
- 什么情况下根本不应该使用 NPU?
1. 先建立全局认识:RK NPU 不是一个单独的软件包
我们平时说“调用 NPU”,听起来像调用一个函数:把模型和图片传进去,NPU 就开始计算。但从一个 PyTorch 模型到 NPU 真正执行,中间至少要经过模型转换工具、模型文件、板端 Runtime、Linux 内核驱动以及 NPU 硬件五个部分。
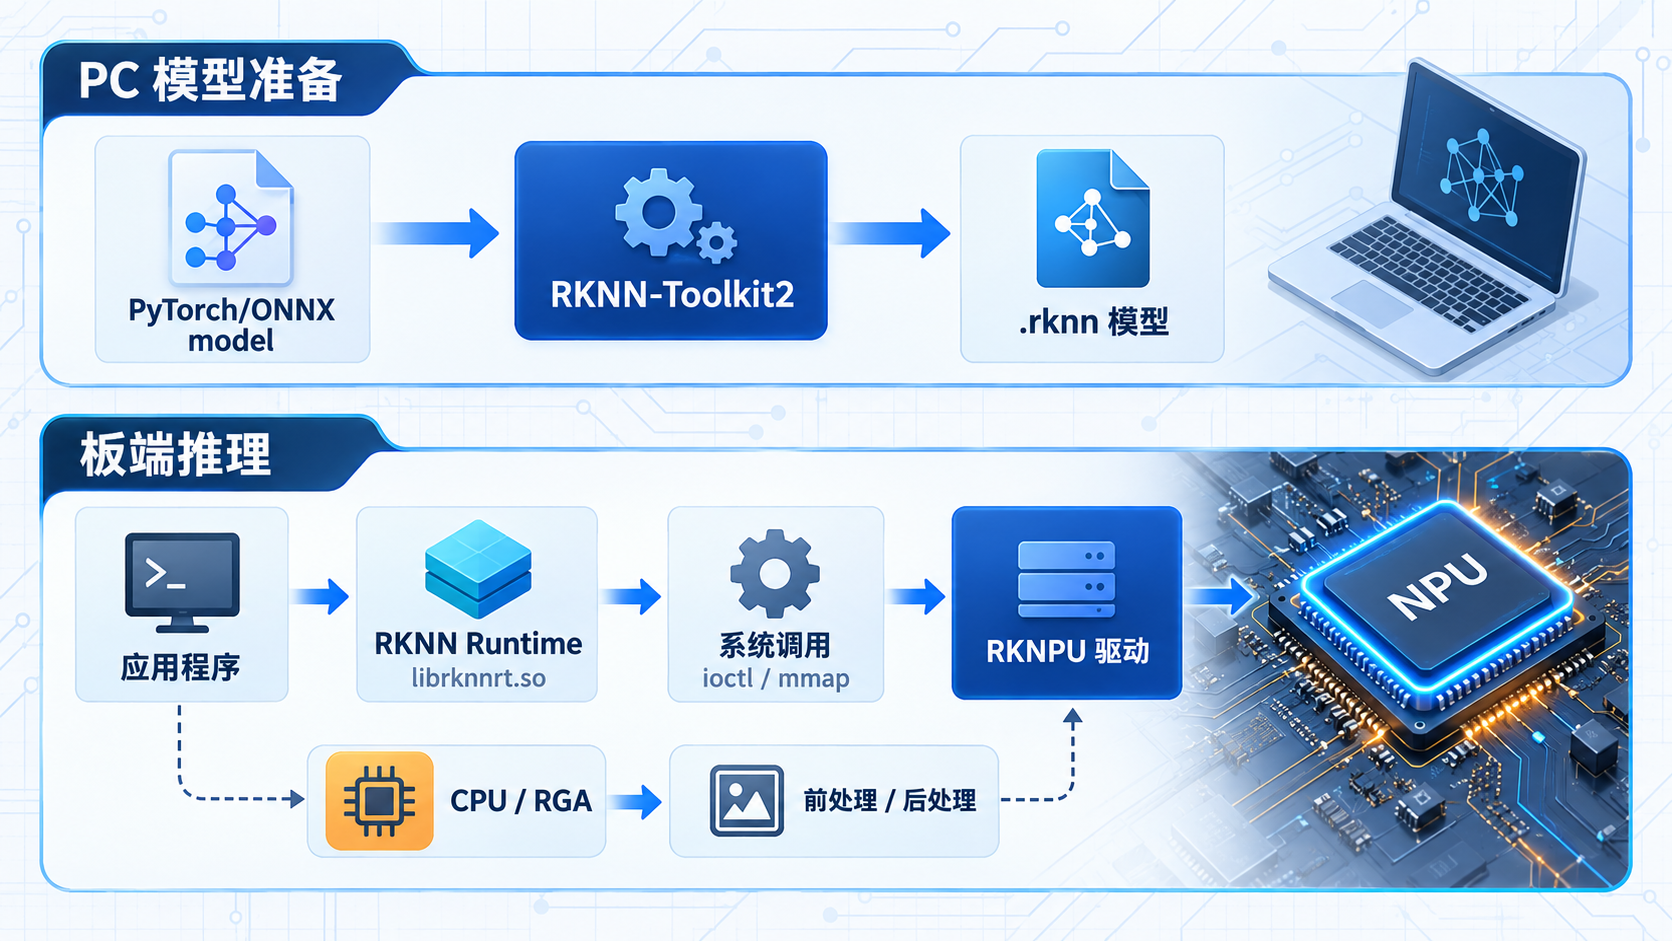
把这条链路拆开来看,可以得到两个阶段。
第一阶段是在 PC 上准备模型:
PyTorch / TensorFlow
        ↓
       ONNX
        ↓
RKNN-Toolkit2
        ↓
面向 RK3588 或 RK3576 编译的 .rknn 模型
第二阶段是在开发板上运行模型:
应用程序
   ↓
RKNNLite / RKNN C API
   ↓
librknnrt.so
   ↓
Linux 系统调用
   ↓
RKNPU 内核驱动
   ↓
NPU 硬件
这几个组件承担的职责不同:
| 组件 | 运行位置 | 主要职责 |
|---|---|---|
| RKNN-Toolkit2 | PC | 解析、优化、量化并编译模型 |
.rknn | PC生成,板端加载 | 保存面向指定 Rockchip NPU 的模型和执行信息 |
| RKNN-Toolkit-Lite2 | 板端Python环境 | 为Python程序提供推理接口 |
librknnrt.so | 板端用户空间 | 加载模型、管理内存并向驱动提交任务 |
| RKNPU驱动 | Linux内核空间 | 管理NPU硬件、内存、中断和任务调度 |
| NPU | SoC内部 | 执行卷积、矩阵乘等计算 |
官方对这套架构的定义也是如此:可以参考RKNN-Toolkit2官方仓库。
因此,遇到问题时不能笼统地说“NPU坏了”或者“RKNN不能运行”,而应该先判断问题属于哪一层。
2. .rknn模型是怎样生成的
NPU不能直接执行普通的PyTorch模型,也通常不能直接执行ONNX。ONNX更像一种用于交换计算图的中间格式,而.rknn则是经过Rockchip工具链优化和编译后的部署模型。
以一个常见的ONNX模型为例,最小转换过程大致如下:
from rknn.api import RKNN

rknn = RKNN(verbose=True)

rknn.config(
    target_platform="rk3576",
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
)

rknn.load_onnx(model="model.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("model_rk3576.rknn")
rknn.release()其中最容易忽略的是target_platform。它意味着生成的模型已经面向具体芯片编译,不能把.rknn简单理解为和ONNX一样的通用格式。给RK3588生成的模型,不应默认可以在RK3576、RK3568或者其他平台上直接运行。
在构建模型时,RKNN-Toolkit2还会完成以下工作:
- 解析计算图和Tensor形状;
- 常量折叠和无用节点消除;
- 将多个操作融合为更适合NPU执行的算子;
- 转换NCHW、NHWC等数据布局;
- 检查算子、数据类型和Shape是否受目标平台支持;
- 根据配置执行FP16、INT8或其他量化;
- 生成面向目标NPU的执行图和权重数据。
这也解释了一个常见误区:ONNX Runtime能够运行,不代表RKNN一定可以转换;RKNN转换成功,也不代表板端一定可以加载。
转换阶段关注的是模型和编译器,板端加载阶段还会受到Runtime、驱动、内存和目标芯片的影响。
3. Runtime到底是什么
在RK3588和RK3576 Linux系统上,板端Runtime的核心通常是:
librknnrt.so它是一个运行在用户空间的动态链接库,不是Linux内核驱动,也不是一个完整的“系统环境”。应用程序调用的高级接口最终会进入这个动态库。
Python程序的调用关系通常是:
Python应用
   ↓
RKNNLite
   ↓
librknnrt.so
   ↓
RKNPU驱动
C/C++程序则是:
C/C++应用
   ↓
RKNN C API
   ↓
librknnrt.so
   ↓
RKNPU驱动
一个最小的Python板端推理程序如下:
from rknnlite.api import RKNNLite

runtime = RKNNLite()

ret = runtime.load_rknn("model_rk3576.rknn")
if ret != 0:
    raise RuntimeError("load_rknn failed")

ret = runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)
if ret != 0:
    raise RuntimeError("init_runtime failed")

outputs = runtime.inference(inputs=[input_tensor])
runtime.release()这里的init_runtime()并不是安装某个运行环境,而是为当前进程创建一次推理上下文。其内部可能包括:
- 检查芯片和驱动;
- 解析RKNN模型;
- 检查模型和Runtime兼容性;
- 选择NPU核心;
- 准备权重和中间Tensor内存;
- 建立向驱动提交任务所需的资源。
通俗地说,Runtime是一位“翻译和调度员”。应用告诉它要运行哪个模型,它把这个请求转换成驱动能够理解的任务;驱动再真正控制NPU硬件。
rknn_server是不是必须的
不是。rknn_server主要用于PC端RKNN-Toolkit2连接开发板进行连板调试、性能分析和远程推理。它在板端接收PC通过USB或ADB传来的请求,再调用板端Runtime执行。
当应用已经独立运行在开发板上时,通常可以直接调用librknnrt.so,不需要让每次推理都经过rknn_server。
4. RKNPU驱动在Linux中处于什么位置
Linux把普通应用和硬件隔离开来。应用运行在用户空间,不能直接访问NPU寄存器、操作中断或者随意访问物理内存。这些工作必须由内核空间的RKNPU驱动完成。
用户空间:应用 → RKNNLite / RKNN API → librknnrt.so
                         │
                    系统调用边界
                         │
内核空间:           RKNPU驱动
                         │
硬件:                 NPU
驱动主要负责:
- 初始化NPU硬件;
- 管理时钟、电源域和复位;
- 管理NPU可访问的内存;
- 接收Runtime提交的计算任务;
- 调度NPU核心;
- 处理中断并报告任务完成;
- 配合IOMMU完成设备地址映射;
- 向Runtime暴露驱动版本和硬件能力。
ioctl和mmap是什么
Runtime与驱动之间需要跨过用户态和内核态边界。常见机制包括ioctl、mmap、poll以及DMA相关的内存共享。
ioctl用于向驱动发送设备专用命令,例如创建上下文、提交任务或查询状态;mmap用于把驱动管理的缓冲区映射到应用的虚拟地址空间;DMA允许NPU直接访问内存,而不需要CPU逐字节搬运;poll等机制可以等待硬件任务完成。
可以简单理解为:
mmap:解决“数据放在哪里、双方怎样访问”
ioctl:解决“让设备做什么”这些底层操作通常已经被librknnrt.so封装。用户调用一次inference(),其内部可能进行内存同步、任务提交和等待完成等多项操作。
这套结构与网卡、USB设备并没有本质区别。网卡应用通过Socket进入Linux网络协议栈,再到网卡驱动;libusb通过USB Core和控制器驱动访问USB设备;RKNN应用则通过Runtime和RKNPU驱动访问NPU。
5. 为什么版本兼容如此重要
RKNN不是一个只有单一版本号的软件包。一次完整部署至少涉及以下版本:
RKNN-Toolkit2版本
        ↓
.rknn模型格式和目标芯片
        ↓
RKNN-Toolkit-Lite2 / librknnrt.so版本
        ↓
RKNPU驱动版本
        ↓
Linux内核和BSP如果使用连板调试,还要加入rknn_server版本;如果使用C/C++开发,还要关注编译时的头文件和链接库是否来自同一套SDK。
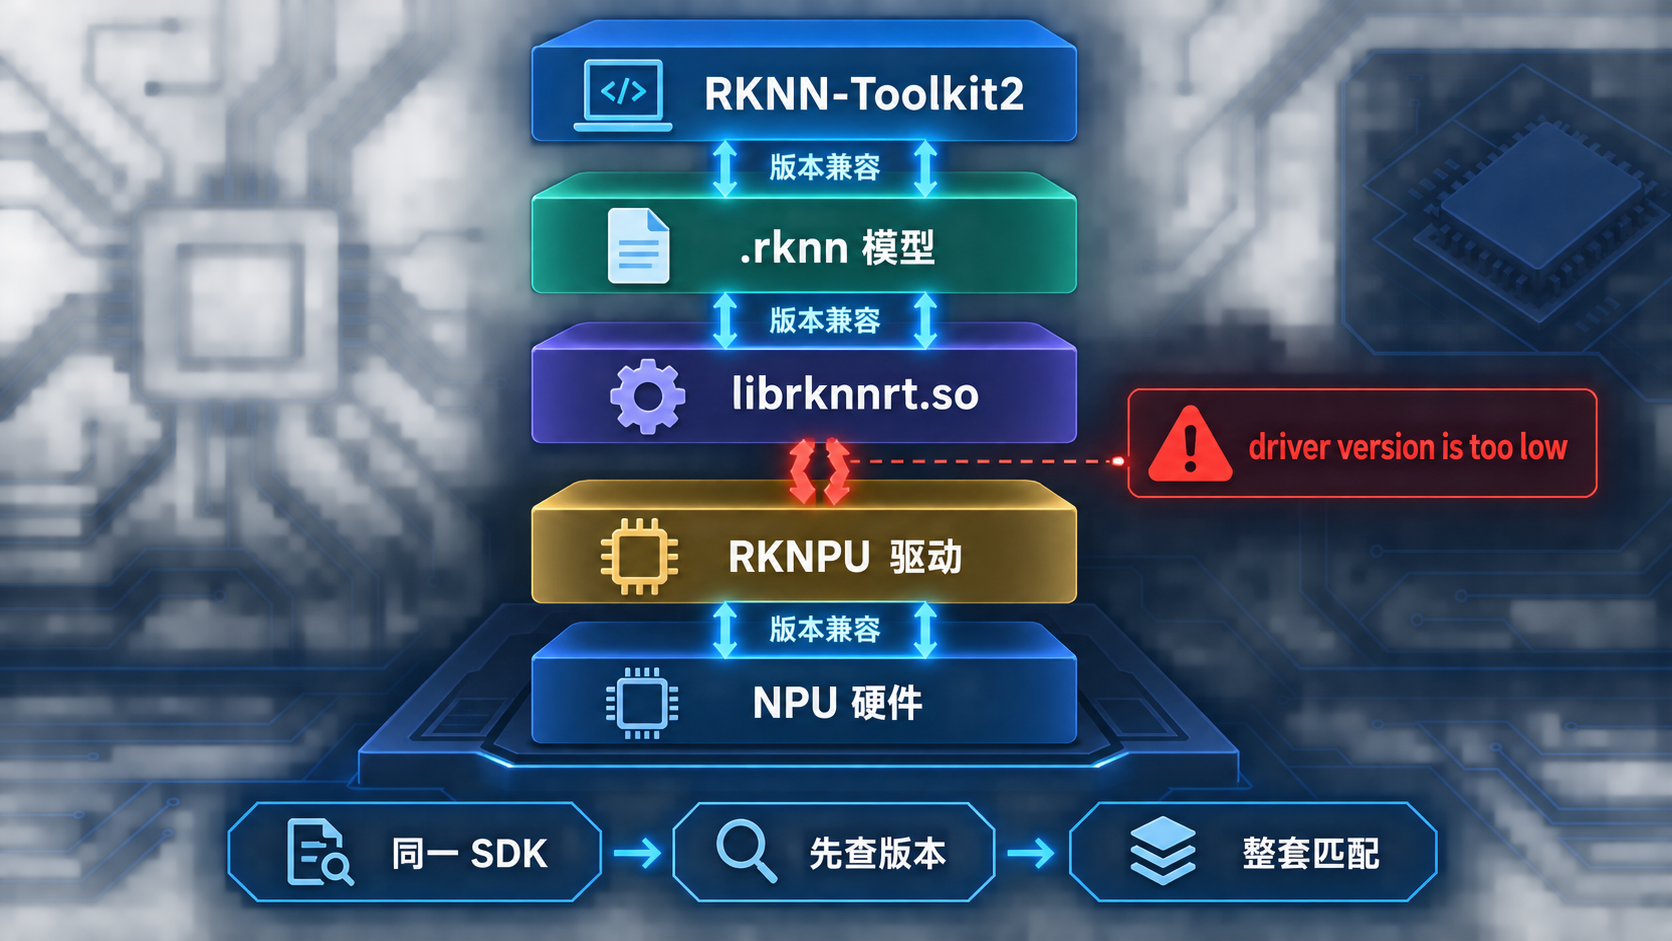
典型的不兼容情况包括:
- 使用新版Toolkit生成模型,但板端Runtime过旧,无法解析模型;
- 只升级
librknnrt.so,新版Runtime需要的驱动能力不存在; - Python包是新版,但实际加载到了系统目录中的旧版Runtime;
rknn_server与板端Runtime来自不同版本;- 模型目标平台是RK3588,实际运行平台却是RK3576;
- 容器中更新了Runtime,但宿主机仍然使用旧内核驱动。
因此,在使用某款以RK芯片为核心的开发板时,一定要查阅官方提供的相应资料,如果官方提供的资料老旧过时,而我们又想运行市场上最新出现的AI应用或AI模型时,就会遇到以上提到的各种问题。
这里我十分推荐Seeed Studio所推出的reComputer AI Lab平台,这里提供了最新的RK3588和RK3576等RK设备面对AI开发时的资料集合。 你可以一键部署CV、LLM、VLM等模型,也有详细的工具和资料解答你在RK开发版上遇到的各种技术问题。还有有趣的实际项目,源码级开源,不论是学习还是开发,都可以获得灵感来源。
当然这是以一个开发者的角度所看到的,如果是市场上已经成熟的产品,最稳妥的原则不是“所有组件越新越好”,而是:
Toolkit、模型、Runtime、Server和驱动应使用经过验证的兼容组合。
6. rknpu driver version is too low是怎样产生的
看到这条错误时,很多人的第一反应是从网上下载一个更新的rknpu.ko覆盖进去。但在执行这个动作之前,应该先理解错误是从哪里产生的。
初始化Runtime时,librknnrt.so会查询板端RKNPU驱动版本及能力。当Runtime需要的接口或能力高于当前驱动所提供的版本时,Runtime就可能输出:
rknpu driver version is too low一般情况下,这个报错会出现在我们购买了一块RK的开发板,运行了Rockchip最新发布的应用或模型,而开发板的厂商发布这款开发板的时间较久远,又没有及时更新板载镜像和wiki资料。我们在使用的时候只更新了板端Runtime的环境而导致的。 也有一种情况是提供开发板的厂商没有产品资料的维护团队,在开发版出场时就没有提供相关的详细资料而导致的,因此在选择开发板时不要盲目贪图价格便宜,缺乏详细资料的开发板在后续的使用过程中会暴露出各种问题。
再说回这个报错,这通常是一个Runtime与驱动不匹配的问题,并不能仅凭这一句话断定驱动文件损坏。
常见原因包括:
- 只升级了
librknnrt.so,没有同步升级BSP或驱动; - 系统中存在多份
librknnrt.so,程序实际加载了错误版本; - 新的驱动模块已经复制到磁盘,但当前内核仍在运行旧驱动;
- RKNPU驱动被编译进内核,替换
.ko没有任何效果; - 新模块与当前内核的
vermagic、符号或配置不匹配,实际加载失败; - 容器使用了新的用户态库,但宿主机驱动仍然较旧;
- 板卡厂商的定制BSP与所使用的Runtime不是同一套发布组合。
可以先收集以下信息:
# 查看内核版本
uname -a

# 查看RKNPU驱动初始化和报错信息
dmesg | grep -i rknpu

# 如果驱动以模块形式加载,查看当前模块
lsmod | grep rknpu

# 查看磁盘上模块的信息;路径需按实际系统调整
modinfo rknpu

# 查找系统中所有Runtime副本
find / -name 'librknnrt.so*' 2>/dev/null

# 查看应用链接到哪些动态库
ldd ./your_application
对于正在运行的进程,还可以检查:
grep librknnrt /proc/$(pidof your_application)/maps它能够回答一个非常关键的问题:程序实际加载的是哪一份librknnrt.so,而不是你认为它会加载哪一份。
推荐按照以下顺序处理:
确认当前内核和驱动版本
        ↓
确认应用实际加载的Runtime
        ↓
确认模型的目标芯片和生成工具版本
        ↓
查找板卡厂商提供的兼容SDK或系统镜像
        ↓
必要时整体升级BSP,或基于当前内核源码重新编译驱动
7. 为什么不能随便替换rknpu.ko
.ko是Linux内核模块,不是普通的用户态动态库。它会直接运行在内核空间,因此必须和当前内核保持高度一致。
首先需要确定驱动采用哪种方式构建:
CONFIG_ROCKCHIP_RKNPU=y   驱动编译进内核
CONFIG_ROCKCHIP_RKNPU=m 驱动编译为独立模块如果驱动已经编译进内核,系统启动时使用的是内核镜像中的驱动,复制一个新的rknpu.ko并不会替换它。此时通常需要更新完整内核或系统镜像。
如果驱动以模块形式存在,单独升级仍然要确保:
- 模块基于当前内核源码或匹配的源码树编译;
- 使用兼容的内核配置和交叉编译工具链;
vermagic一致;- 模块依赖的内核符号存在;
- Device Tree、电源域、时钟、IOMMU和保留内存配置匹配;
- 当前没有进程占用NPU;
- 模块签名和安全启动策略允许加载。
可以比较运行内核与模块信息:
uname -r
modinfo ./rknpu.ko | grep vermagic
即使模块成功加载,也不等于整个系统已经兼容。板卡厂商可能在BSP中加入特定的Device Tree、电源管理或内存补丁。因此,升级优先级建议如下:
- 优先使用板卡厂商提供的完整镜像或升级包;
- 其次使用厂商对应版本的BSP重新构建内核和模块;
- 只有确认内核、配置和依赖完全匹配时,才考虑单独替换模块;
- 操作前保留可启动的旧镜像和恢复方式。
所谓“升级到RKNPU 0.9.8”,真正需要确认的是正在运行的内核已经加载0.9.8驱动,并且它与当前Runtime和BSP兼容,而不是文件系统里出现了一个标注0.9.8的.ko文件。
8. CNN、Transformer和LLM的部署路线
虽然它们都叫AI模型,但并不一定使用同一条部署路径。
CNN:最典型的RKNN路线
图像分类、YOLO检测、语义分割和姿态估计等模型通常走:
PyTorch → ONNX → RKNN-Toolkit2 → .rknn → RKNN Runtime → NPU卷积、激活、池化等算子通常更容易映射到NPU。需要重点处理的是:
- 输入尺寸和布局;
- RGB/BGR顺序;
- mean、std与应用预处理是否重复;
- INT8量化数据集;
- 检测头解码和NMS;
- 摄像头、RGA与NPU之间的数据复制。
普通Transformer:关注算子和动态Shape
视觉Transformer、轻量编码器等仍可尝试RKNN-Toolkit2,但需要额外关注:
- MatMul;
- Softmax;
- LayerNorm或RMSNorm;
- reshape和transpose;
- 动态序列长度;
- 中间Tensor内存;
- 算子是否需要CPU或GPU辅助。
不要仅因为模型名称包含Transformer,就默认它能完整运行在NPU上。真正决定能否执行的是计算图中的算子、Shape和数据类型是否被目标平台支持。
LLM:通常使用RKLLM工具链
大语言模型还涉及KV Cache、Prefill、逐Token Decode、长上下文和采样等机制。Rockchip为这类模型提供了独立的RKNN-LLM工具链:
Hugging Face模型
        ↓
RKLLM-Toolkit转换和量化
        ↓
.rkllm模型
        ↓
RKLLM Runtime
        ↓
RKNPU驱动和NPU
RKLLM仍然依赖RKNPU驱动,但它和普通CNN使用的RKNN模型、Runtime接口以及执行方式并不完全相同。模型是否受支持,应以相应版本的官方支持列表为准。
9. RK3588运行大模型的两条路线
在RK3588上运行大模型,常见选择可以概括为两条路线。
路线一:GGUF + llama.cpp + CPU
这条路线的优点是上手简单、模型生态丰富、调试方便。下载适合内存容量的GGUF量化模型后,通常不需要接触RKNN模型转换和RKNPU驱动版本问题。
它适合:
- 快速验证模型能力;
- 经常切换模型;
- 优先考虑兼容性;
- 团队暂时没有NPU适配经验;
- 当前模型不在RKLLM支持范围内。
代价是CPU占用较高,Token速度、功耗和多任务能力可能不如针对NPU完成优化的方案。
路线二:RKLLM + NPU
这条路线有机会提高推理吞吐并降低部分CPU计算压力,但需要承担更多工程工作:
- 确认模型结构是否受支持;
- 使用指定工具链完成量化和转换;
- 匹配RKLLM Runtime与RKNPU驱动;
- 评估量化后的精度;
- 规划模型权重、KV Cache和系统内存;
- 区分Prefill速度与Decode速度;
- 验证不同上下文长度下的稳定性。
因此,NPU路线不是“把GGUF文件交给NPU运行”。它通常意味着采用另一套模型格式和Runtime,并围绕固定模型做针对性适配。
选择时可以参考:
| 需求 | 更适合的起点 |
|---|---|
| 尽快跑起来 | GGUF + CPU |
| 经常更换模型 | GGUF + CPU |
| 固定模型并追求更高性能 | 评估RKLLM + NPU |
| 模型不在官方支持列表 | 优先CPU或其他后端 |
| 准备量产 | 固定并验证完整NPU软件栈 |
无论使用哪条路线,都应该测量端到端性能,而不是只看宣传中的TOPS或某一个算子耗时。LLM往往同时受内存容量、内存带宽、KV Cache和CPU侧逻辑影响。
10. 一套通用的分层排障方法
面对一条错误日志时,最有效的方法不是立刻搜索并复制某条命令,而是先判断失败发生在哪一层。
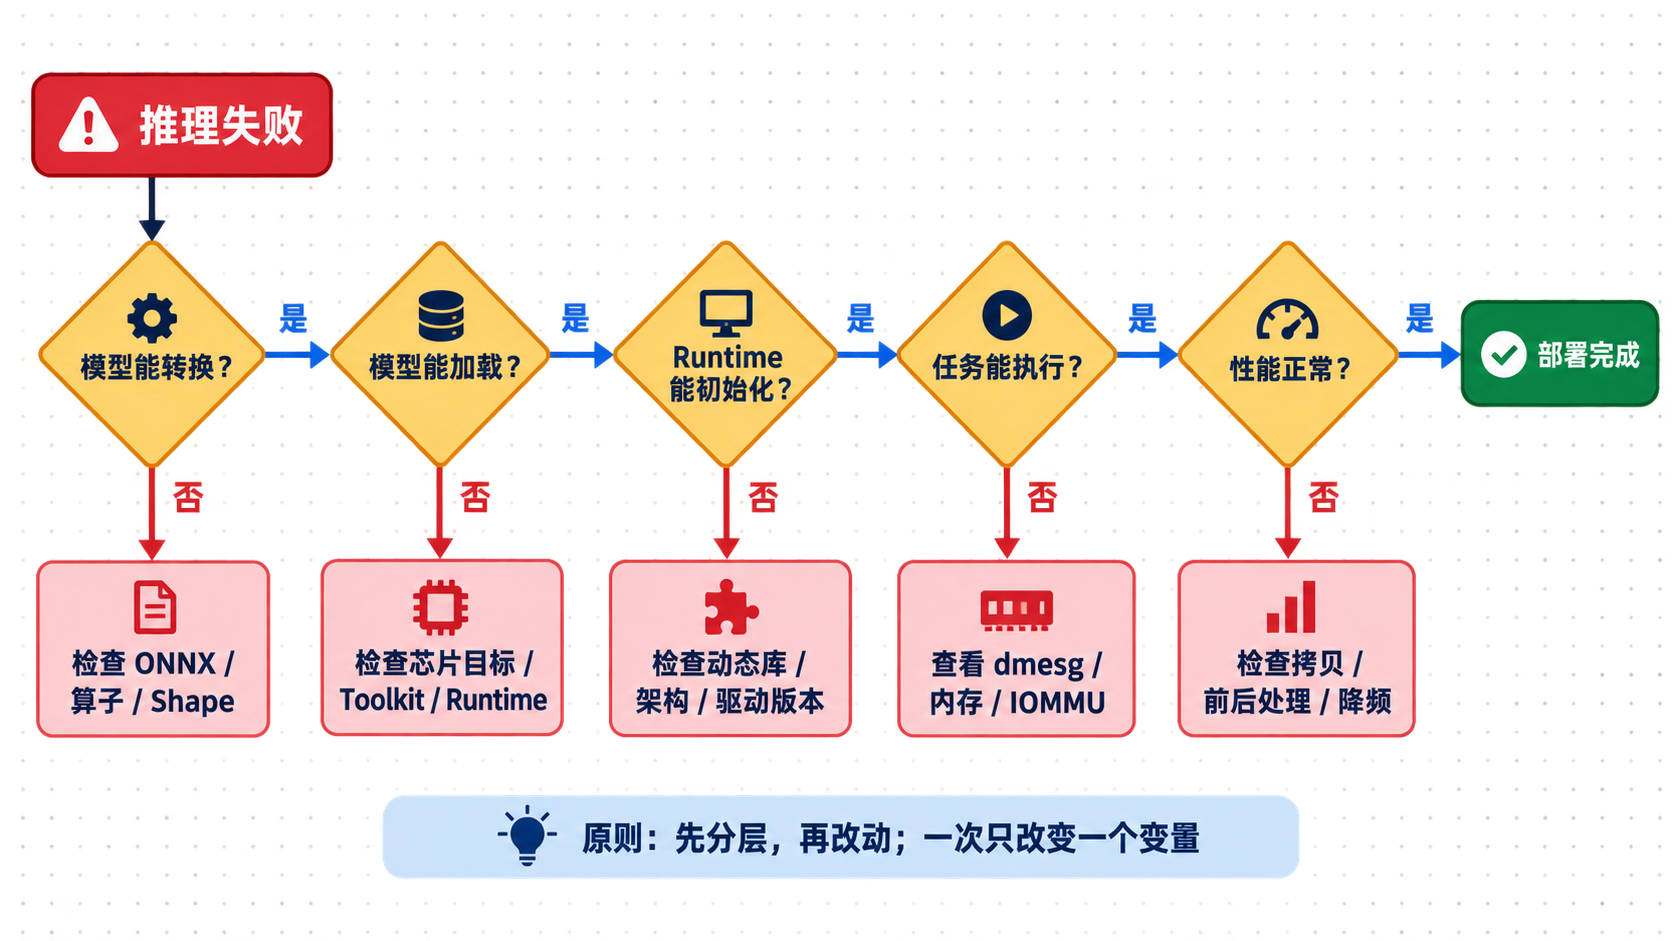
第一层:模型转换
典型现象:
unsupported operator
shape inference failed
build model failed
重点检查ONNX有效性、Opset、输入Shape、动态维度、算子支持情况以及转换日志。如果使用量化,还要检查校准数据是否能够代表真实输入。
第二层:模型加载
典型现象:
invalid rknn model
unsupported target platform
load_rknn failed重点核对模型由哪个Toolkit版本生成、target_platform是什么、板端Runtime是否能够解析该模型格式,以及文件在复制过程中是否完整。
第三层:Runtime初始化
典型现象:
failed to initialize rknn runtime
driver version is too low
cannot open shared object file
undefined symbol
重点检查动态库路径、CPU架构、32/64位、Runtime实际加载位置、驱动版本和设备节点。
第四层:任务执行
典型现象:
failed to submit task
IOMMU fault
allocate memory failed重点查看dmesg,检查可用内存、CMA或DMA缓冲区、IOMMU错误、输入Tensor属性以及并发任务是否超出资源限制。
第五层:性能
模型能运行并不代表已经正确发挥NPU性能。以下问题经常不体现在rknn_run()的单次耗时中:
- 图片读取和解码;
- resize、letterbox和颜色转换;
- CPU与NPU之间的数据复制;
- 输出解码和NMS;
- 不必要的同步等待;
- NPU核心选择;
- CPU、NPU或内存降频;
- 温度过高导致的热降频;
- 多线程流水线设计不合理。
建议至少分别记录:
输入读取时间
前处理时间
纯模型推理时间
后处理时间
端到端总时间
只报告纯NPU推理时间,很容易得到一个看起来很漂亮、却不能代表真实业务性能的数字。
11. 提问或提交问题前应该收集什么
当问题无法自行解决时,完整的信息比一句报错更重要。建议至少提供:
SoC型号:
开发板型号:
操作系统及镜像来源:
Linux内核版本:
RKNPU驱动版本:
RKNN-Toolkit2版本:
RKNN-Toolkit-Lite2版本:
RKNN Runtime版本:
rknn_server版本(如使用):
模型来源和ONNX Opset:
目标平台:
是否量化:
完整应用日志:
dmesg相关日志:
官方示例能否运行:
其中“官方示例能否运行”非常关键:
- 官方示例也不能运行,问题更可能在系统、Runtime或驱动;
- 官方示例可以运行,自己的模型不能运行,问题更可能在模型转换或输入输出处理;
- 同一模型的C示例能运行、Python不能运行,优先检查Python包和动态库路径;
- 宿主机能运行、容器不能运行,优先检查设备映射、权限和容器内Runtime。
12. 容易混淆的认识
最后总结一些最容易产生误判的说法:
- 芯片有NPU,不代表任意神经网络都能运行;
- ONNX能运行,不代表RKNN一定能够转换;
- RKNN转换成功,不代表板端版本一定兼容;
- 更新
librknnrt.so,不等于更新了内核驱动; - 复制新的
rknpu.ko,不等于新驱动已经加载; - 驱动版本更高,不代表它一定适配当前内核和BSP;
- 使用NPU,不代表前处理、后处理和所有算子都在NPU上;
- 多个NPU核心,不代表单模型性能会自动按核心数倍增;
- 容器可以携带用户态Runtime,但不能替代宿主机内核驱动;
- NPU推理时间,不等于完整应用的端到端时间;
- 标称TOPS相同,不代表不同芯片、模型和精度下的实际性能完全相同。