Tras comprar una placa RK3588, encenderla, grabar la imagen y arrancar, encuentras un ejemplo YOLO para su NPU de 6 TOPS. Al ejecutarlo aparece:
rknpu driver version is too low
failed to initialize rknn runtime
invalid rknn model
unsupported target platform
failed to submit task
¿Qué ha ocurrido?
Es una situación habitual al desplegar por primera vez IA en una plataforma edge no generalista. ¿Por qué un programa que funciona en mi PC falla al trasladarlo aquí? ¿Por qué la conversión termina bien pero la ejecución en la placa falla? ¿Por qué el mismo modelo funciona en una placa y no en otra?
Este artículo explica de forma clara y profunda cómo utilizar la NPU de Rockchip.
Responde a estas preguntas principales:
- ¿Qué son RKNN-Toolkit2, RKNN Runtime y el controlador RKNPU?
- ¿Por qué actualizar
librknnrt.sopuede no ser suficiente? - ¿Por qué no debe sustituirse
rknpu.kosin más? - ¿En qué difieren las rutas de despliegue de CNN, Transformer y LLM?
- ¿Cómo localizar el fallo en el modelo, Runtime, controlador o imagen del sistema?
- ¿Cuándo no conviene usar la NPU?
1. Visión global: la NPU RK no es un único paquete
«Llamar a la NPU» parece una función que recibe modelo e imagen. En realidad, desde PyTorch hasta la ejecución intervienen al menos la herramienta de conversión, el archivo del modelo, el Runtime de la placa, el controlador Linux y el hardware NPU.
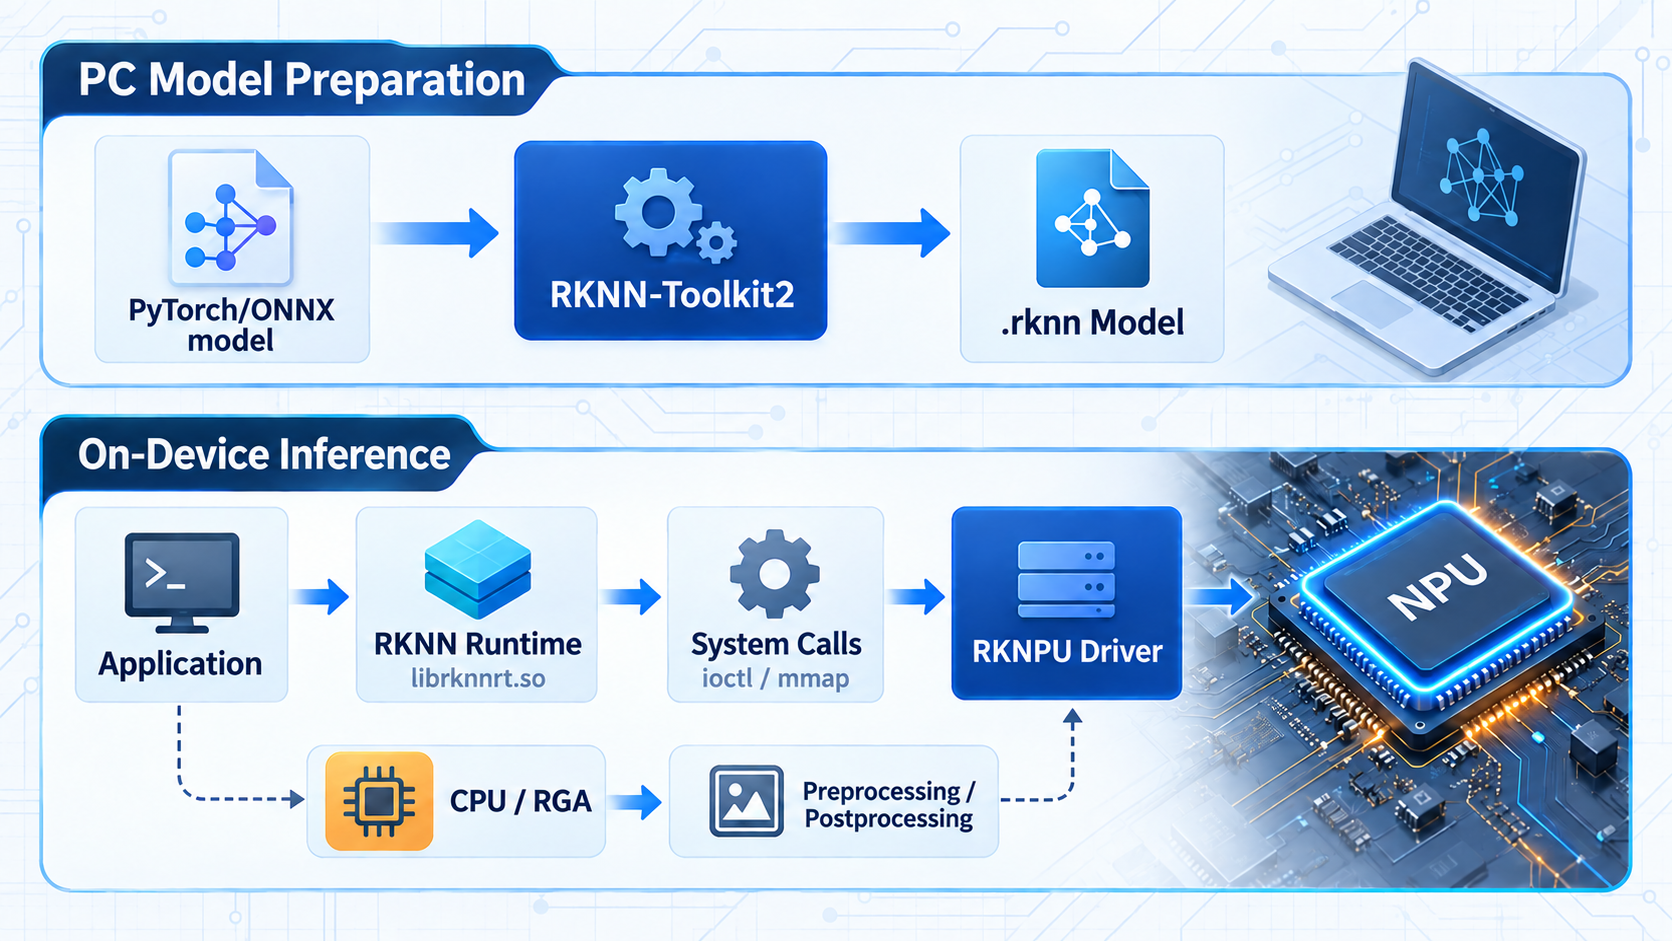
La cadena se divide en dos etapas.
Primero se prepara el modelo en el PC:
PyTorch / TensorFlow
        ↓
       ONNX
        ↓
RKNN-Toolkit2
        ↓
Modelo .rknn compilado para RK3588 o RK3576
Después se ejecuta en la placa:
Aplicación
   ↓
RKNNLite / RKNN C API
   ↓
librknnrt.so
   ↓
Llamadas al sistema Linux
   ↓
Controlador RKNPU del kernel
   ↓
Hardware NPU
Cada componente tiene una función distinta:
| Componente | Ubicación | Función principal |
|---|---|---|
| RKNN-Toolkit2 | PC | Analizar, optimizar, cuantizar y compilar el modelo |
.rknn | Generado en PC; cargado en placa | Guardar modelo e información de ejecución para una NPU Rockchip concreta |
| RKNN-Toolkit-Lite2 | Python en la placa | Proporcionar API de inferencia a Python |
librknnrt.so | Espacio de usuario | Cargar modelos, gestionar memoria y enviar tareas al controlador |
| Controlador RKNPU | Kernel Linux | Gestionar NPU, memoria, interrupciones y planificación |
| NPU | Dentro del SoC | Ejecutar convoluciones, productos matriciales y otros cálculos |
La arquitectura oficial es la misma; consulta el repositorio oficial de RKNN-Toolkit2.
Ante un problema, no concluyas que «la NPU está rota»: identifica primero la capa que falla.
2. Cómo se genera un modelo .rknn
La NPU no ejecuta directamente un modelo PyTorch y normalmente tampoco ONNX. ONNX intercambia grafos; .rknn es un modelo de despliegue optimizado y compilado por Rockchip.
La conversión mínima de un ONNX típico es:
from rknn.api import RKNN

rknn = RKNN(verbose=True)

rknn.config(
    target_platform="rk3576",
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
)

rknn.load_onnx(model="model.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("model_rk3576.rknn")
rknn.release()
Suele olvidarse target_platform: compila para un chip concreto. .rknn no es universal como ONNX; un modelo para RK3588 no debe suponerse válido en RK3576, RK3568 u otra plataforma.
RKNN-Toolkit2 también realiza:
- Análisis del grafo y Shapes de Tensor;
- Plegado de constantes y eliminación de nodos inútiles;
- Fusión de operaciones para la NPU;
- Conversión de diseños NCHW, NHWC, etc.;
- Comprobación de operadores, tipos y Shapes admitidos;
- Cuantización FP16, INT8 u otra según la configuración;
- Generación del grafo y pesos para la NPU destino.
Error habitual: que ONNX Runtime funcione no garantiza la conversión RKNN; convertir con RKNN tampoco garantiza que la placa pueda cargarlo.
La conversión depende del modelo y compilador; la carga también del Runtime, controlador, memoria y chip.
3. Qué es exactamente el Runtime
En Linux para RK3588/RK3576, el núcleo del Runtime suele ser:
librknnrt.soEs una biblioteca compartida de usuario, no un controlador del kernel ni un «entorno de sistema» completo. Las API de alto nivel terminan aquí.
La ruta habitual de Python es:
Aplicación Python
   ↓
RKNNLite
   ↓
librknnrt.so
   ↓
Controlador RKNPU
Para C/C++ es:
Aplicación C/C++
   ↓
RKNN C API
   ↓
librknnrt.so
   ↓
Controlador RKNPU
Un programa Python mínimo en la placa es:
from rknnlite.api import RKNNLite

runtime = RKNNLite()

ret = runtime.load_rknn("model_rk3576.rknn")
if ret != 0:
    raise RuntimeError("load_rknn failed")

ret = runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)
if ret != 0:
    raise RuntimeError("init_runtime failed")

outputs = runtime.inference(inputs=[input_tensor])
runtime.release()
init_runtime() no instala un entorno: crea un contexto de inferencia para el proceso y puede:
- Comprobar chip y controlador;
- Analizar el modelo RKNN;
- Verificar compatibilidad entre modelo y Runtime;
- Elegir núcleos NPU;
- Preparar memoria para pesos y Tensors intermedios;
- Crear recursos para enviar tareas al controlador.
El Runtime actúa como traductor y planificador: transforma la petición de la aplicación en tareas para el controlador, que gobierna la NPU.
¿Es obligatorio rknn_server?
No. rknn_server conecta RKNN-Toolkit2 del PC con la placa para depuración, análisis y ejecución remota mediante USB o ADB.
Una aplicación autónoma en la placa suele llamar directamente a librknnrt.so, sin pasar cada inferencia por rknn_server.
4. Lugar del controlador RKNPU en Linux
Linux separa aplicaciones y hardware. Una aplicación no accede directamente a registros NPU, interrupciones o memoria física; lo hace el controlador RKNPU del kernel.
Espacio de usuario: Aplicación → RKNNLite / RKNN API → librknnrt.so
                         │
                    Límite de llamadas al sistema
                         │
Espacio del kernel:   Controlador RKNPU
                         │
Hardware:             NPU
El controlador se encarga de:
- Inicializar la NPU;
- Gestionar relojes, dominios de energía y reinicios;
- Gestionar memoria accesible por la NPU;
- Recibir tareas del Runtime;
- Planificar núcleos NPU;
- Gestionar interrupciones y notificar finalización;
- Mapear direcciones con la IOMMU;
- Exponer versión y capacidades al Runtime.
Qué son ioctl y mmap
Runtime y controlador cruzan el límite usuario/kernel mediante ioctl, mmap, poll y memoria compartida DMA.
ioctlenvía órdenes específicas: crear contexto, enviar tarea o consultar estado;mmapmapea búferes del controlador en el espacio virtual de la aplicación;DMApermite a laNPUacceder a memoria sin que laCPUcopie cada byte;polly mecanismos similares esperan al hardware.
En términos sencillos:
mmap: determina dónde se colocan los datos y cómo acceden ambas partes
ioctl: indica al dispositivo qué operación debe realizar
librknnrt.so encapsula estas operaciones. Una llamada a inference() puede sincronizar memoria, enviar tareas y esperar su fin.
Es similar a una tarjeta de red o USB: sockets y la pila Linux llegan al controlador de red; libusb, al dispositivo mediante USB Core; RKNN, a la NPU mediante Runtime y RKNPU.
5. Por qué importa la compatibilidad de versiones
RKNN no tiene una sola versión. Un despliegue completo implica al menos:
Versión de RKNN-Toolkit2
        ↓
Formato del modelo .rknn y chip de destino
        ↓
Versión de RKNN-Toolkit-Lite2 / librknnrt.so
        ↓
Versión del controlador RKNPU
        ↓
Kernel de Linux y BSP
La depuración añade la versión de rknn_server; en C/C++, cabeceras y bibliotecas deben pertenecer al mismo SDK.
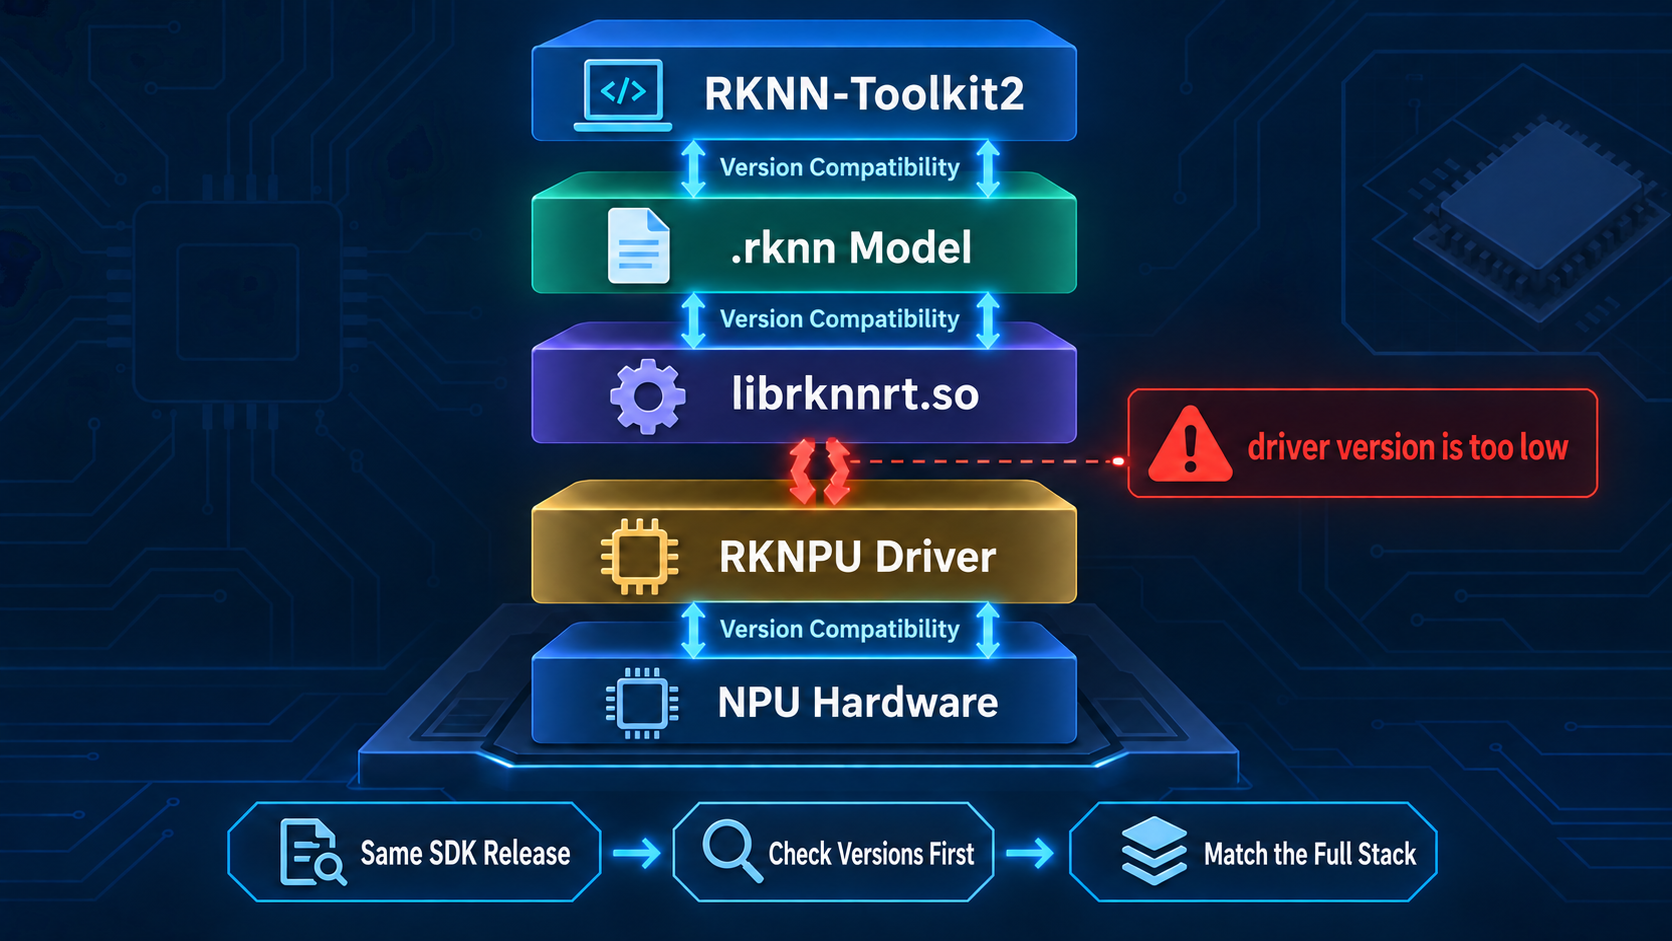
Incompatibilidades típicas:
- Un Toolkit nuevo genera un modelo que un Runtime antiguo no analiza;
- Se actualiza solo
librknnrt.so, pero faltan funciones del controlador; - El paquete Python es nuevo, pero carga un Runtime antiguo del sistema;
rknn_servery Runtime pertenecen a versiones distintas;- El modelo apunta a RK3588, pero se ejecuta en RK3576;
- El Runtime del contenedor es nuevo, pero el controlador del host es antiguo.
Consulta siempre la documentación oficial de la placa. Si está desactualizada y usas aplicaciones o modelos recientes, aparecerán estos problemas.
Recomiendo reComputer AI Lab de Seeed Studio, con recursos actuales para desarrollo de IA en RK3588, RK3576 y otros dispositivos RK. Permite desplegar CV, LLM y VLM con un clic, ofrece herramientas y documentación técnica, y proyectos prácticos de código abierto.
Para un producto maduro, la regla segura no es «todo más nuevo», sino:
Utiliza una combinación validada de Toolkit, modelo, Runtime, Server y controlador.
6. Cómo aparece rknpu driver version is too low
No descargues y sobrescribas inmediatamente rknpu.ko; primero comprende el origen del error.
Al iniciar, librknnrt.so consulta la versión y capacidades de RKNPU. Si necesita interfaces superiores a las del controlador, puede mostrar:
rknpu driver version is too lowSuele ocurrir al ejecutar software Rockchip reciente en una placa antigua cuyo proveedor no actualizó la imagen ni la wiki, tras actualizar solo el Runtime. También hay proveedores sin mantenimiento documental. No elijas únicamente por precio: la falta de documentación causa problemas posteriores.
Normalmente es una incompatibilidad Runtime–controlador, no prueba de que el archivo esté dañado.
Causas comunes:
- Se actualizó
librknnrt.so, pero no BSP ni controlador; - Existen varias copias y se carga el
librknnrt.soequivocado; - El módulo nuevo está en disco, pero el kernel ejecuta el antiguo;
- RKNPU está integrado en el kernel y sustituir
.kono sirve; vermagic, símbolos o configuración no coinciden y el módulo no carga;- El contenedor usa biblioteca nueva, pero el host mantiene controlador antiguo;
- El BSP personalizado y Runtime no forman una versión validada.
Recopila primero esta información:
# Comprobar la versión del kernel
uname -a

# Comprobar la inicialización y los errores del controlador RKNPU
dmesg | grep -i rknpu

# Si el controlador se carga como módulo, listar los módulos actuales
lsmod | grep rknpu

# Inspeccionar el módulo en disco; ajustar la ruta al sistema real
modinfo rknpu

# Buscar todas las copias del Runtime en el sistema
find / -name 'librknnrt.so*' 2>/dev/null

# Comprobar las bibliotecas compartidas enlazadas por la aplicación
ldd ./your_application
Para un proceso activo, comprueba también:
grep librknnrt /proc/$(pidof your_application)/mapsAsí sabrás qué librknnrt.so cargó realmente el programa, no cuál creías que cargaría.
Sigue este orden:
Confirmar las versiones actuales del kernel y del controlador
        ↓
Confirmar el Runtime cargado realmente por la aplicación
        ↓
Confirmar el chip de destino del modelo y la versión de la herramienta de conversión
        ↓
Buscar un SDK o una imagen de sistema compatible del fabricante de la placa
        ↓
Si es necesario, actualizar el BSP completo o recompilar el controlador con el código fuente del kernel actual
7. Por qué no sustituir rknpu.ko sin más
Un .ko es un módulo del kernel, no una biblioteca de usuario. Se ejecuta en el kernel y debe coincidir estrechamente con él.
Primero determina cómo se compiló el controlador:
CONFIG_ROCKCHIP_RKNPU=y   Controlador integrado en el kernel
CONFIG_ROCKCHIP_RKNPU=m   Controlador compilado como módulo independiente
Si está integrado, se usa el del kernel al arrancar. Copiar rknpu.ko no lo sustituye; debe actualizarse el kernel o la imagen completa.
Si es un módulo, verifica:
- Compilación con el código del kernel actual o equivalente;
- Configuración y toolchain cruzado compatibles;
vermagiccoincidente;- Símbolos requeridos presentes;
- Device Tree, energía, reloj, IOMMU y memoria reservada coincidentes;
- Ningún proceso usa la NPU;
- Firma y arranque seguro permiten cargarlo.
Compara kernel y módulo:
uname -r
modinfo ./rknpu.ko | grep vermagic
Que cargue no garantiza compatibilidad total: el BSP puede incluir parches de Device Tree, energía o memoria. Prioridad recomendada:
- Imagen o actualización completa del proveedor;
- Recompilar kernel y módulo desde su BSP correspondiente;
- Sustituir solo el módulo únicamente si todo coincide;
- Conservar imagen arrancable y método de recuperación.
«Actualizar a RKNPU 0.9.8» significa verificar que el kernel activo cargó el controlador 0.9.8 compatible con Runtime y BSP, no solo tener un .ko etiquetado 0.9.8.
8. Rutas de despliegue de CNN, Transformer y LLM
Aunque todos sean modelos de IA, no necesariamente siguen la misma ruta.
CNN: la ruta RKNN típica
Clasificación, YOLO, segmentación y pose suelen seguir:
PyTorch → ONNX → RKNN-Toolkit2 → .rknn → RKNN Runtime → NPUConvolución, activación y pooling se mapean bien a la NPU. Revisa:
- Dimensiones y disposición de entrada;
- Orden RGB/BGR;
- Duplicación de mean y std con el preprocesado;
- Dataset de cuantización INT8;
- Decodificación de cabeza y NMS;
- Copias entre cámara, RGA y NPU.
Transformer común: operadores y Shape dinámico
Vision Transformer y codificadores ligeros pueden usar RKNN-Toolkit2, prestando atención a:
- MatMul;
- Softmax;
- LayerNorm o RMSNorm;
- reshape y transpose;
- Longitud de secuencia dinámica;
- Memoria de Tensors intermedios;
- Operadores que requieren CPU o GPU.
Que se llame Transformer no implica ejecución completa en NPU: depende de operadores, Shapes y tipos admitidos.
LLM: normalmente con RKLLM
Los LLM añaden KV Cache, Prefill, Decode por token, contextos largos y muestreo. Rockchip ofrece RKNN-LLM:
Modelo de Hugging Face
        ↓
Conversión y cuantización con RKLLM-Toolkit
        ↓
Modelo .rkllm
        ↓
RKLLM Runtime
        ↓
Controlador RKNPU y NPU
RKLLM depende de RKNPU, pero su modelo, API Runtime y ejecución difieren de CNN. Consulta la lista oficial de la versión.
9. Dos rutas para modelos grandes en RK3588
Las opciones habituales se resumen en dos rutas.
Ruta 1: GGUF + llama.cpp + CPU
Es sencilla, tiene muchos modelos y facilita depuración. Un GGUF adecuado a la memoria evita conversión RKNN y conflictos de versión RKNPU.
Conviene para:
- Validación rápida;
- Cambio frecuente de modelos;
- Priorizar compatibilidad;
- Equipos sin experiencia NPU;
- Modelos no admitidos por RKLLM.
A cambio usa más CPU y puede ofrecer peor velocidad por token, consumo y multitarea que una solución NPU optimizada.
Ruta 2: RKLLM + NPU
Puede aumentar throughput y reducir carga CPU, pero exige más ingeniería:
- Confirmar que la arquitectura está admitida;
- Cuantizar y convertir con la toolchain indicada;
- Emparejar RKLLM Runtime y RKNPU;
- Evaluar precisión cuantizada;
- Planificar pesos, KV Cache y memoria;
- Distinguir velocidades Prefill y Decode;
- Verificar estabilidad con distintas longitudes.
No consiste en «dar GGUF a la NPU»: usa otro formato y Runtime, adaptados a un modelo fijo.
Guía de elección:
| Necesidad | Punto de partida |
|---|---|
| Ejecutar cuanto antes | GGUF + CPU |
| Cambiar modelos a menudo | GGUF + CPU |
| Modelo fijo y mayor rendimiento | Evaluar RKLLM + NPU |
| Modelo fuera de la lista oficial | CPU u otro backend |
| Preparar producción | Fijar y validar toda la pila NPU |
Mide rendimiento extremo a extremo, no solo TOPS o un operador. Los LLM también dependen de capacidad y ancho de banda de memoria, KV Cache y lógica CPU.
10. Diagnóstico general por capas
Ante un error, localiza primero la capa que falla en vez de copiar inmediatamente un comando.
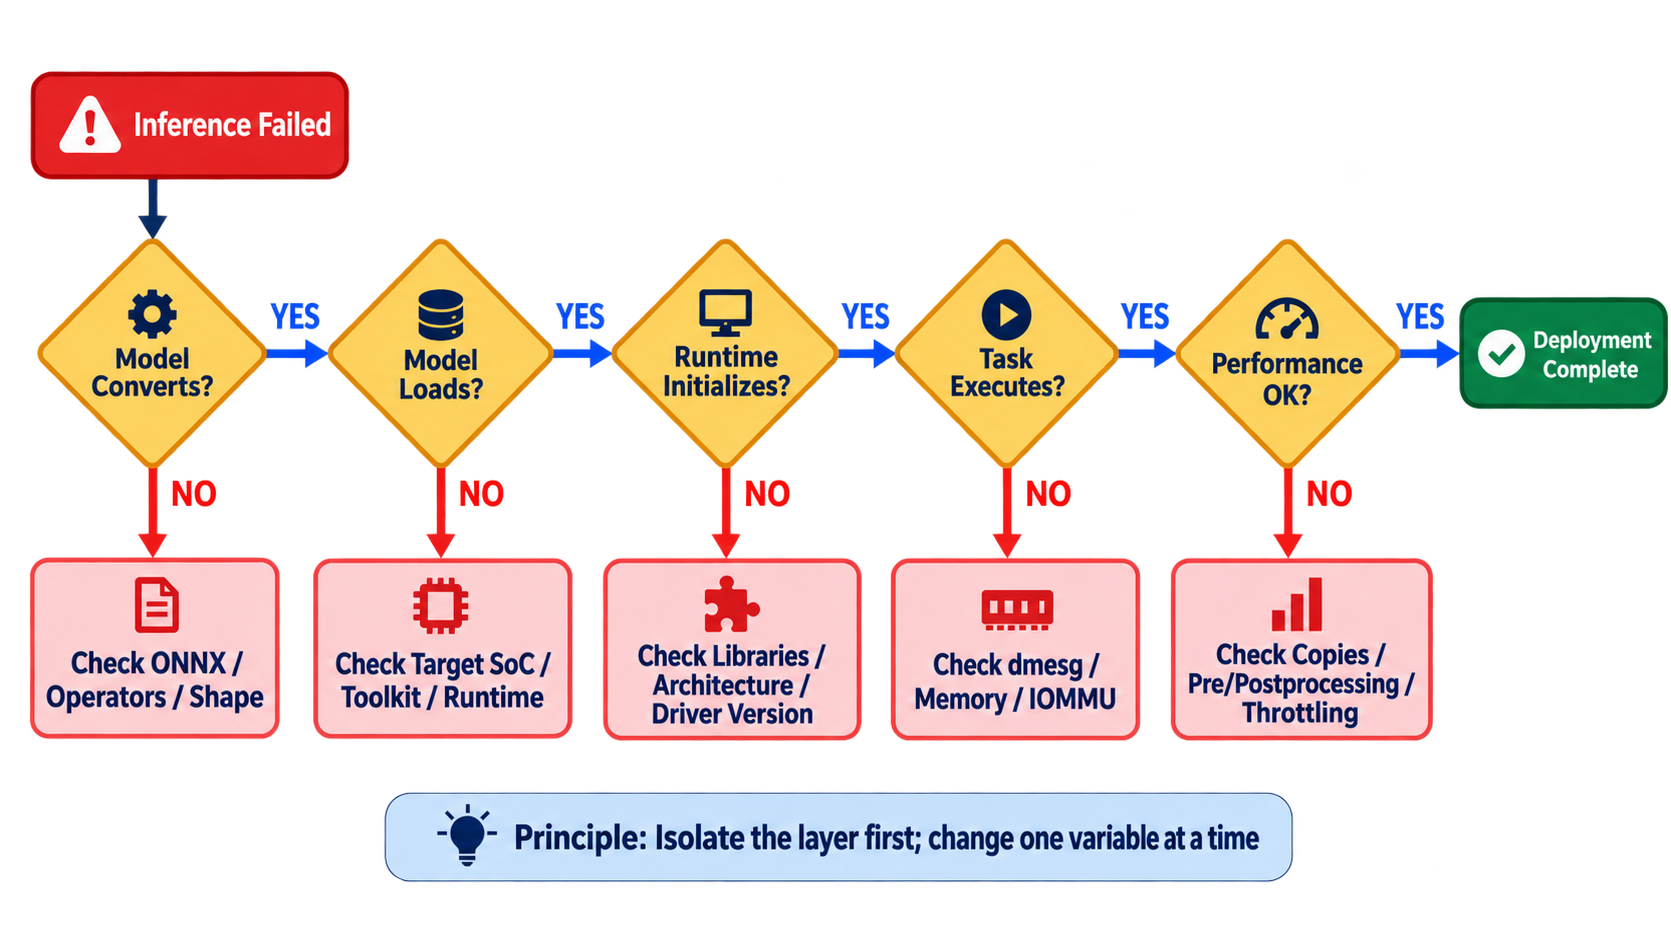
Capa 1: conversión
Síntomas típicos:
unsupported operator
shape inference failed
build model failed
Comprueba ONNX, Opset, Shape de entrada, dimensiones dinámicas, operadores y logs. En cuantización, valida los datos de calibración.
Capa 2: carga
Síntomas típicos:
invalid rknn model
unsupported target platform
load_rknn failed
Comprueba versión del Toolkit, target_platform, capacidad del Runtime para leer el formato e integridad del archivo.
Capa 3: inicialización de Runtime
Síntomas típicos:
failed to initialize rknn runtime
driver version is too low
cannot open shared object file
undefined symbol
Comprueba rutas de bibliotecas, arquitectura, 32/64 bits, Runtime cargado, controlador y nodos de dispositivo.
Capa 4: ejecución
Síntomas típicos:
failed to submit task
IOMMU fault
allocate memory failed
Revisa dmesg, memoria, CMA/DMA, IOMMU, atributos de Tensor y límites de concurrencia.
Capa 5: rendimiento
Que funcione no significa que aproveche la NPU. Un tiempo de rknn_run() suele excluir:
- Lectura y decodificación de imágenes;
- resize, letterbox y conversión de color;
- Copias CPU–NPU;
- Decodificación y NMS;
- Esperas innecesarias;
- Selección de núcleo NPU;
- Reducción de frecuencia CPU, NPU o memoria;
- Thermal throttling;
- Mal diseño multihilo.
Registra por separado al menos:
Tiempo de lectura de la entrada
Tiempo de preprocesamiento
Tiempo de inferencia pura del modelo
Tiempo de posprocesamiento
Tiempo total de extremo a extremo
Informar solo la inferencia NPU da una cifra atractiva que puede no representar el rendimiento real.
11. Datos que recopilar antes de preguntar
La información completa vale más que un único error. Proporciona al menos:
Modelo del SoC:
Modelo de la placa de desarrollo:
Sistema operativo y origen de la imagen:
Versión del kernel de Linux:
Versión del controlador RKNPU:
Versión de RKNN-Toolkit2:
Versión de RKNN-Toolkit-Lite2:
Versión de RKNN Runtime:
Versión de rknn_server (si se utiliza):
Origen del modelo y ONNX Opset:
Plataforma de destino:
Cuantizado:
Registro completo de la aplicación:
Registro de dmesg relevante:
¿Puede ejecutarse el ejemplo oficial?:
Es fundamental indicar si funciona el ejemplo oficial:
- Si también falla, apunta a sistema, Runtime o controlador;
- Si funciona pero tu modelo no, apunta a conversión o E/S;
- Si C funciona y Python no, revisa paquete Python y bibliotecas;
- Si el host funciona y el contenedor no, revisa dispositivos, permisos y Runtime del contenedor.
12. Confusiones habituales
Resumen de afirmaciones que inducen a error:
- Tener NPU no permite ejecutar cualquier red;
- Funcionar en ONNX no garantiza conversión RKNN;
- Convertir con RKNN no garantiza compatibilidad en placa;
- Actualizar
librknnrt.sono actualiza el controlador; - Copiar
rknpu.kono significa que se haya cargado; - Un controlador nuevo puede no adaptarse al kernel y BSP;
- Usar NPU no coloca todo el pre/postprocesado y operadores en ella;
- Más núcleos NPU no multiplican automáticamente un modelo;
- Un contenedor lleva Runtime de usuario, no sustituye el controlador del host;
- Tiempo de inferencia NPU no es tiempo extremo a extremo;
- Igual TOPS nominal no implica igual rendimiento entre chips, modelos y precisiones.