Après avoir démarré une carte RK3588 dotée d’un NPU de 6 TOPS, vous trouvez un exemple YOLO pour RK3588. Son exécution affiche :
rknpu driver version is too low
failed to initialize rknn runtime
invalid rknn model
unsupported target platform
failed to submit task
Que s’est-il passé ?
Cette situation est fréquente lors d’un premier déploiement IA sur une plateforme edge spécialisée. Pourquoi un programme fonctionnant sur mon PC échoue-t-il sur la carte ? Pourquoi la conversion réussit-elle alors que l’exécution échoue ? Pourquoi le même modèle fonctionne-t-il sur une carte mais pas une autre ?
Cet article explique clairement et en profondeur l’utilisation du NPU Rockchip.
Il répond notamment aux questions suivantes :
- Que sont RKNN-Toolkit2, RKNN Runtime et le pilote RKNPU ?
- Pourquoi la mise à jour de
librknnrt.sopeut-elle ne pas suffire ? - Pourquoi ne faut-il pas remplacer
rknpu.koarbitrairement ? - Comment diffèrent les déploiements CNN, Transformer et LLM ?
- Comment localiser le problème : modèle, Runtime, pilote ou image système ?
- Quand faut-il éviter le NPU ?
1. Vue d’ensemble : le NPU RK n’est pas un paquet unique
« Appeler le NPU » semble simple, mais entre PyTorch et l’exécution interviennent au moins l’outil de conversion, le fichier modèle, le Runtime embarqué, le pilote Linux et le matériel NPU.
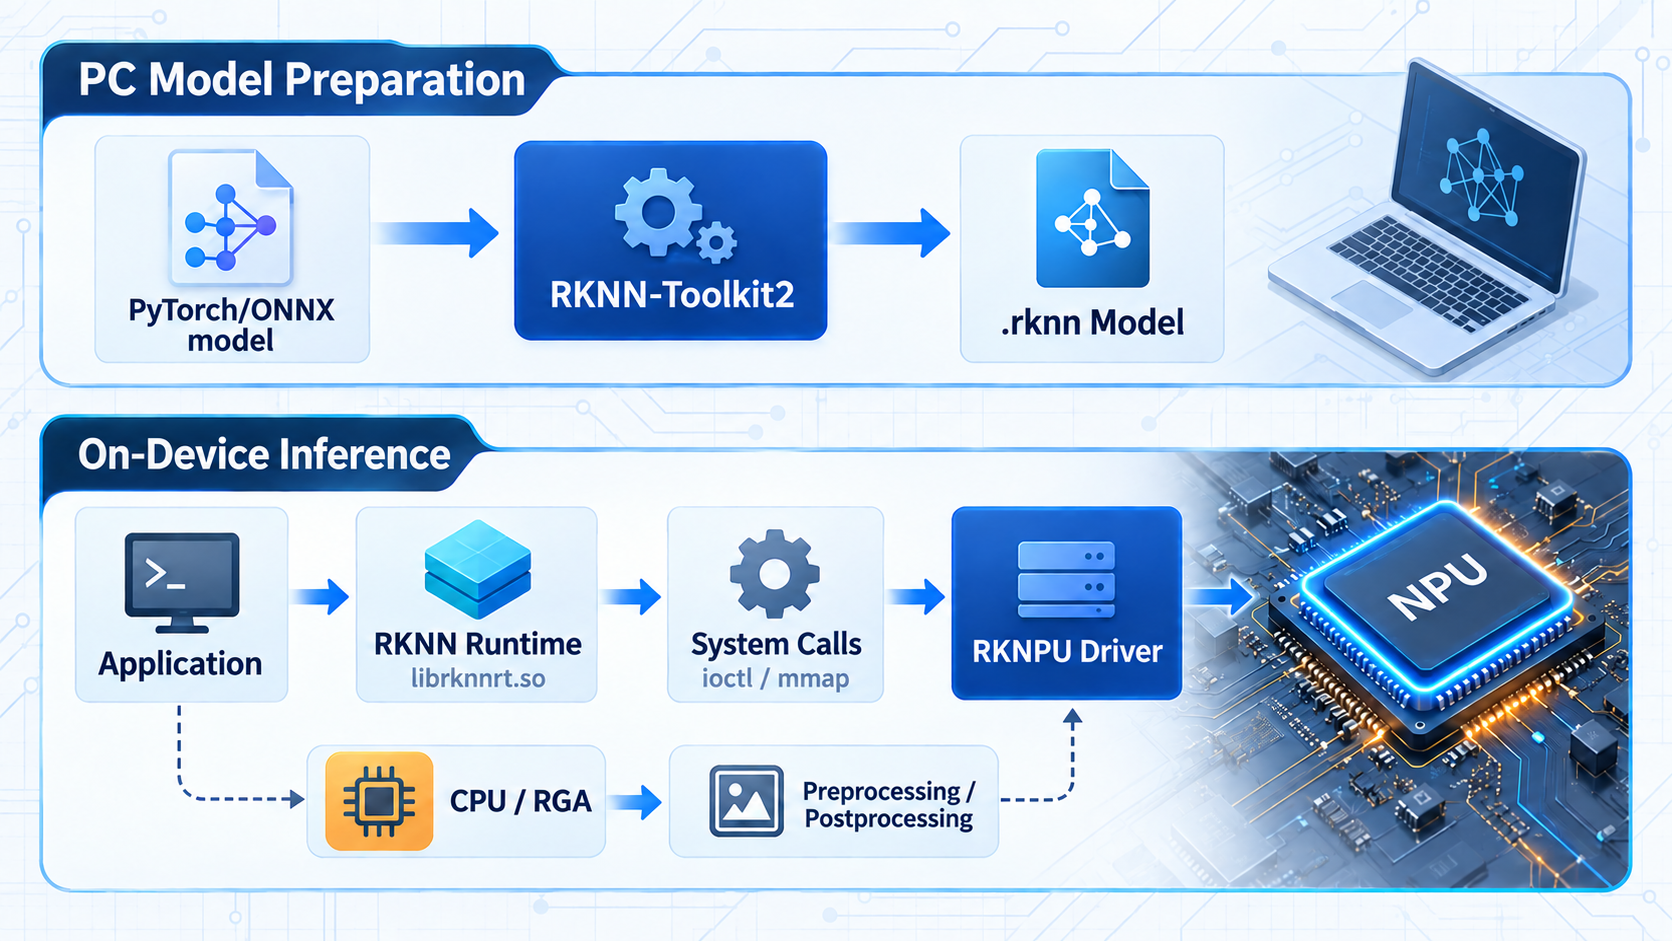
Cette chaîne comporte deux étapes.
Préparation du modèle sur le PC :
PyTorch / TensorFlow
        ↓
       ONNX
        ↓
RKNN-Toolkit2
        ↓
Modèle .rknn compilé pour RK3588 ou RK3576
Exécution du modèle sur la carte :
Application
   ↓
RKNNLite / RKNN C API
   ↓
librknnrt.so
   ↓
Appels système Linux
   ↓
Pilote RKNPU du noyau
   ↓
Matériel NPU
Chaque composant a un rôle distinct :
| Composant | Emplacement | Rôle principal |
|---|---|---|
| RKNN-Toolkit2 | PC | Analyser, optimiser, quantifier et compiler |
.rknn | Généré sur PC, chargé sur carte | Stocker modèle et informations pour un NPU Rockchip donné |
| RKNN-Toolkit-Lite2 | Python embarqué | Fournir l’API d’inférence Python |
librknnrt.so | Espace utilisateur | Charger, gérer la mémoire et soumettre les tâches |
| Pilote RKNPU | Noyau Linux | Gérer NPU, mémoire, interruptions et planification |
| NPU | Dans le SoC | Exécuter convolutions, multiplications matricielles, etc. |
L’architecture officielle est identique ; consultez le dépôt RKNN-Toolkit2.
En cas d’erreur, identifiez d’abord la couche fautive au lieu de conclure que « le NPU est cassé ».
2. Génération d’un modèle .rknn
Le NPU n’exécute pas directement PyTorch ni, généralement, ONNX. ONNX échange des graphes ; .rknn est optimisé et compilé par Rockchip pour le déploiement.
La conversion ONNX minimale ressemble à ceci :
from rknn.api import RKNN

rknn = RKNN(verbose=True)

rknn.config(
    target_platform="rk3576",
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
)

rknn.load_onnx(model="model.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("model_rk3576.rknn")
rknn.release()
target_platform est crucial : le modèle vise une puce précise. .rknn n’est pas universel ; un modèle RK3588 ne fonctionne pas nécessairement sur RK3576 ou RK3568.
RKNN-Toolkit2 effectue aussi :
- Analyse du graphe et des Shapes de Tensor ;
- Repliement des constantes et suppression des nœuds inutiles ;
- Fusion d’opérations adaptées au NPU ;
- Conversion NCHW, NHWC, etc. ;
- Vérification des opérateurs, types et Shapes ;
- Quantification FP16, INT8 ou autre ;
- Génération du graphe d’exécution et des poids.
Idée fausse : un modèle fonctionnant avec ONNX Runtime n’est pas forcément convertible en RKNN ; une conversion réussie ne garantit pas son chargement sur la carte.
La conversion dépend du modèle et du compilateur ; le chargement dépend aussi du Runtime, du pilote, de la mémoire et de la puce.
3. Qu’est-ce que le Runtime ?
Sous Linux RK3588/RK3576, son élément central est généralement :
librknnrt.soC’est une bibliothèque partagée en espace utilisateur, pas un pilote noyau ni un environnement complet. Les API applicatives y aboutissent.
Chemin d’appel Python :
Application Python
   ↓
RKNNLite
   ↓
librknnrt.so
   ↓
Pilote RKNPU
Chemin C/C++ :
Application C/C++
   ↓
RKNN C API
   ↓
librknnrt.so
   ↓
Pilote RKNPU
Programme Python minimal sur la carte :
from rknnlite.api import RKNNLite

runtime = RKNNLite()

ret = runtime.load_rknn("model_rk3576.rknn")
if ret != 0:
    raise RuntimeError("load_rknn failed")

ret = runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)
if ret != 0:
    raise RuntimeError("init_runtime failed")

outputs = runtime.inference(inputs=[input_tensor])
runtime.release()
init_runtime() instancie un contexte d’inférence ; il peut :
- Vérifier puce et pilote ;
- Analyser le modèle RKNN ;
- Vérifier la compatibilité modèle–Runtime ;
- Sélectionner les cœurs NPU ;
- Préparer la mémoire des poids et Tensors ;
- Créer les ressources de soumission au pilote.
Le Runtime traduit et planifie les demandes ; le pilote contrôle ensuite le NPU.
rknn_server est-il obligatoire ?
Non. Il relie RKNN-Toolkit2 du PC à la carte via USB/ADB pour le débogage, l’analyse et l’inférence distante.
Une application autonome appelle généralement librknnrt.so directement.
4. Place du pilote RKNPU dans Linux
Linux isole applications et matériel. Seul le pilote noyau accède aux registres NPU, interruptions et mémoire physique.
Espace utilisateur : Application → RKNNLite / RKNN API → librknnrt.so
                         │
                    Limite des appels système
                         │
Espace noyau :        Pilote RKNPU
                         │
Matériel :           NPU
Le pilote assure :
- L’initialisation du NPU ;
- Les horloges, domaines d’alimentation et réinitialisations ;
- La mémoire accessible au NPU ;
- La réception des tâches du Runtime ;
- La planification des cœurs ;
- Les interruptions et fins de tâche ;
- Le mappage d’adresses via IOMMU ;
- L’exposition de sa version et des capacités.
Que sont ioctl et mmap ?
Runtime et pilote communiquent entre espaces utilisateur et noyau via ioctl, mmap, poll et DMA.
ioctlenvoie des commandes propres au périphérique ;mmapprojette un tampon du pilote dans l’espace virtuel ;DMAlaisse leNPUaccéder à la mémoire sans copie octet par octet duCPU;pollpeut attendre la fin d’une tâche.
En termes simples :
mmap : détermine où placer les données et comment les deux parties y accèdent
ioctl : indique au périphérique l'opération à effectuer
librknnrt.so encapsule ces opérations ; inference() peut synchroniser, soumettre puis attendre.
Comme les cartes réseau ou USB, RKNN atteint le NPU via une pile logicielle : Runtime puis pilote RKNPU.
5. Importance de la compatibilité des versions
RKNN ne possède pas un numéro unique ; un déploiement implique au moins :
Version de RKNN-Toolkit2
        ↓
Format du modèle .rknn et puce cible
        ↓
Version de RKNN-Toolkit-Lite2 / librknnrt.so
        ↓
Version du pilote RKNPU
        ↓
Noyau Linux et BSP
Le débogage ajoute rknn_server ; en C/C++, en-têtes et bibliothèques doivent venir du même SDK.
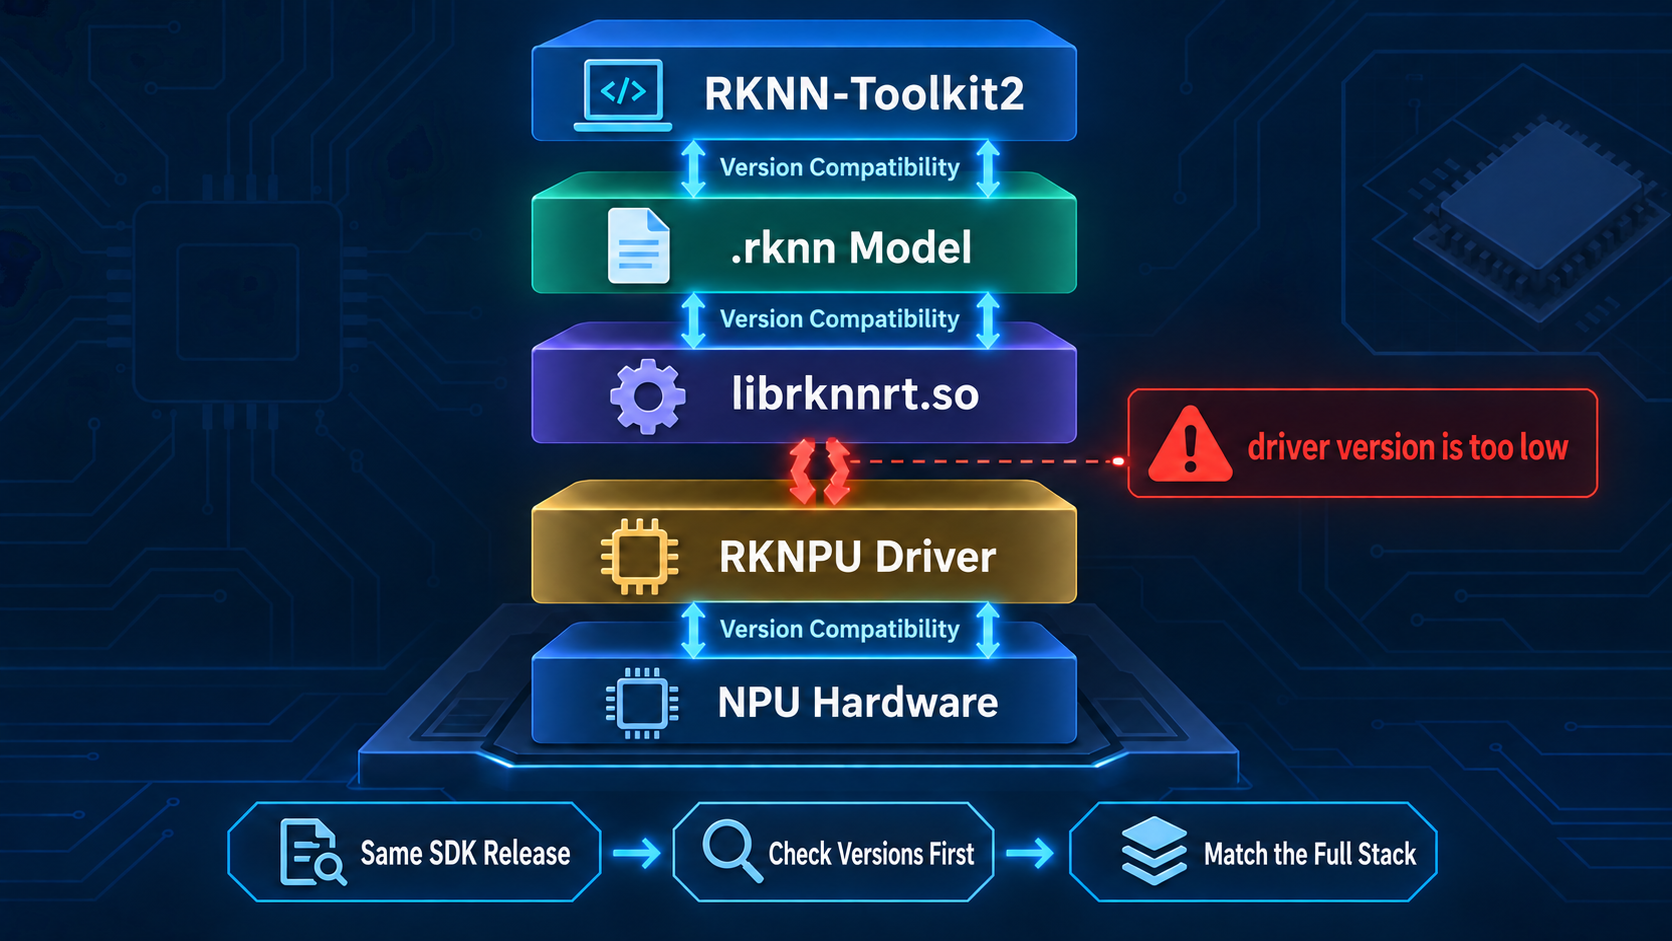
Incompatibilités typiques :
- Modèle produit par un Toolkit récent, illisible par un ancien Runtime ;
- Seul
librknnrt.soest mis à jour, sans fonctions pilote requises ; - Paquet Python récent, mais ancien Runtime réellement chargé ;
rknn_serveret Runtime issus de versions différentes ;- Modèle RK3588 exécuté sur RK3576 ;
- Runtime récent dans le conteneur, ancien pilote sur l’hôte.
Consultez toujours la documentation officielle de la carte ; des ressources anciennes avec des modèles récents provoquent ces problèmes.
reComputer AI Lab de Seeed Studio regroupe des ressources actuelles pour RK3588, RK3576 et d’autres appareils RK. Il propose le déploiement de CV, LLM et VLM, des outils détaillés et des projets open source pratiques.
Pour un produit mature, la règle sûre n’est pas « tout au plus récent », mais :
Utiliser un ensemble Toolkit, modèle, Runtime, Server et pilote validé comme compatible.
6. Origine de rknpu driver version is too low
Ne remplacez pas immédiatement rknpu.ko ; comprenez d’abord l’origine du message.
À l’initialisation, librknnrt.so interroge version et capacités du pilote. Si le Runtime exige davantage, il affiche :
rknpu driver version is too lowCela arrive souvent avec une carte ancienne dont l’image et le wiki n’ont pas été actualisés, après mise à jour du seul Runtime. Certains fournisseurs maintiennent peu leur documentation. Le prix seul ne doit pas guider le choix.
Il s’agit généralement d’une incompatibilité Runtime–pilote, pas d’une preuve de fichier corrompu.
Causes courantes :
librknnrt.somis à jour sans BSP ni pilote ;- Plusieurs copies, mauvaise version chargée ;
- Nouveau module sur disque, ancien pilote encore actif ;
- Pilote intégré au noyau, remplacement de
.kosans effet ; vermagic, symboles ou configuration incompatibles ;- Bibliothèque récente dans le conteneur, pilote hôte ancien ;
- BSP fournisseur et Runtime issus d’ensembles différents.
Collectez d’abord :
# Vérifier la version du noyau
uname -a

# Vérifier l'initialisation et les erreurs du pilote RKNPU
dmesg | grep -i rknpu

# Si le pilote est chargé comme module, lister les modules actuels
lsmod | grep rknpu

# Inspecter le module sur le disque ; adapter le chemin au système utilisé
modinfo rknpu

# Rechercher toutes les copies du Runtime sur le système
find / -name 'librknnrt.so*' 2>/dev/null

# Vérifier les bibliothèques partagées liées à l'application
ldd ./your_application
Pour un processus actif, vérifiez aussi :
grep librknnrt /proc/$(pidof your_application)/mapsVous saurez quel librknnrt.so est réellement chargé, et non celui supposé.
Procédez dans cet ordre :
Confirmer les versions actuelles du noyau et du pilote
        ↓
Confirmer le Runtime effectivement chargé par l'application
        ↓
Confirmer la puce cible du modèle et la version de l'outil de conversion
        ↓
Rechercher un SDK ou une image système compatible fourni par le fabricant de la carte
        ↓
Si nécessaire, mettre à niveau l'ensemble du BSP ou recompiler le pilote avec les sources du noyau actuel
7. Pourquoi ne pas remplacer rknpu.ko arbitrairement
Un .ko est un module noyau, pas une bibliothèque utilisateur ; il doit correspondre étroitement au noyau actif.
Déterminez d’abord son mode de compilation :
CONFIG_ROCKCHIP_RKNPU=y   Pilote intégré au noyau
CONFIG_ROCKCHIP_RKNPU=m   Pilote compilé comme module séparé
S’il est intégré au noyau, copier rknpu.ko ne le remplace pas ; mettez à jour le noyau ou l’image complète.
S’il est modulaire, vérifiez :
- Compilation depuis les sources correspondantes ;
- Configuration et toolchain compatibles ;
vermagicidentique ;- Symboles noyau disponibles ;
- Device Tree, alimentation, horloges, IOMMU et mémoire cohérents ;
- Aucun processus n’utilise le NPU ;
- Signature et démarrage sécurisé autorisent le chargement.
Comparez noyau et module :
uname -r
modinfo ./rknpu.ko | grep vermagic
Un module chargé ne garantit pas le système complet. Le BSP peut contenir des correctifs spécifiques. Priorité :
- Image ou mise à jour complète du fournisseur ;
- Reconstruction depuis son BSP correspondant ;
- Module seul uniquement si tout correspond ;
- Conserver une image amorçable et une méthode de récupération.
« Passer à RKNPU 0.9.8 » signifie vérifier que le noyau actif charge ce pilote et qu’il est compatible avec Runtime et BSP, pas seulement trouver un .ko étiqueté 0.9.8.
8. Déploiement des CNN, Transformer et LLM
Ces modèles IA n’emploient pas nécessairement la même voie.
CNN : voie RKNN typique
Classification, YOLO, segmentation et pose suivent généralement :
PyTorch → ONNX → RKNN-Toolkit2 → .rknn → RKNN Runtime → NPUConvolution, activation et pooling se mappent bien au NPU. Vérifiez :
- Dimensions et disposition d’entrée ;
- Ordre RGB/BGR ;
- Doublon de mean/std avec le prétraitement ;
- Jeu de quantification INT8 ;
- Décodage de tête et NMS ;
- Copies entre caméra, RGA et NPU.
Transformer classique : opérateurs et Shapes dynamiques
Vision Transformer et encodeurs légers peuvent employer RKNN-Toolkit2, avec attention à :
- MatMul;
- Softmax;
- LayerNorm ou RMSNorm ;
- reshape et transpose ;
- Longueurs de séquence dynamiques ;
- Mémoire des Tensors intermédiaires ;
- Opérateurs aidés par CPU ou GPU.
Le nom Transformer ne garantit pas l’exécution intégrale sur NPU ; opérateurs, Shapes et types doivent être pris en charge.
LLM : généralement la chaîne RKLLM
Les LLM ajoutent KV Cache, Prefill, Decode par token, contextes longs et échantillonnage. Rockchip fournit RKNN-LLM :
Modèle Hugging Face
        ↓
Conversion et quantification avec RKLLM-Toolkit
        ↓
Modèle .rkllm
        ↓
RKLLM Runtime
        ↓
Pilote RKNPU et NPU
RKLLM dépend de RKNPU mais diffère des CNN par modèle, interfaces et exécution. Consultez la liste officielle de la version.
9. Deux voies pour les grands modèles sur RK3588
Les choix courants sont :
Voie 1 : GGUF + llama.cpp + CPU
Simple, riche en modèles et facile à déboguer. Un GGUF adapté à la mémoire évite conversion RKNN et problèmes de pilote.
Convient pour :
- Validation rapide ;
- Changements fréquents de modèle ;
- Priorité à la compatibilité ;
- Équipe sans expérience NPU ;
- Modèle non pris en charge par RKLLM.
En contrepartie, CPU, débit par token, énergie et multitâche peuvent être moins favorables.
Voie 2 : RKLLM + NPU
Peut augmenter le débit et réduire le CPU, avec davantage d’ingénierie :
- Vérifier l’architecture ;
- Quantifier et convertir avec la chaîne indiquée ;
- Faire correspondre RKLLM Runtime et RKNPU ;
- Évaluer la précision quantifiée ;
- Planifier poids, KV Cache et mémoire ;
- Distinguer Prefill et Decode ;
- Tester différentes longueurs de contexte.
La voie NPU n’exécute pas directement un GGUF : elle utilise un autre format et Runtime adaptés au modèle.
Repères de choix :
| Besoin | Point de départ conseillé |
|---|---|
| Démarrer vite | GGUF + CPU |
| Changer souvent de modèle | GGUF + CPU |
| Modèle fixe, meilleures performances | Évaluer RKLLM + NPU |
| Modèle hors liste officielle | CPU ou autre backend |
| Préparer la production | Figer et valider toute la pile NPU |
Mesurez les performances de bout en bout, pas seulement les TOPS. Mémoire, bande passante, KV Cache et logique CPU influencent aussi les LLM.
10. Diagnostic générique par couches
Face à une erreur, localisez d’abord sa couche au lieu de copier immédiatement une commande.
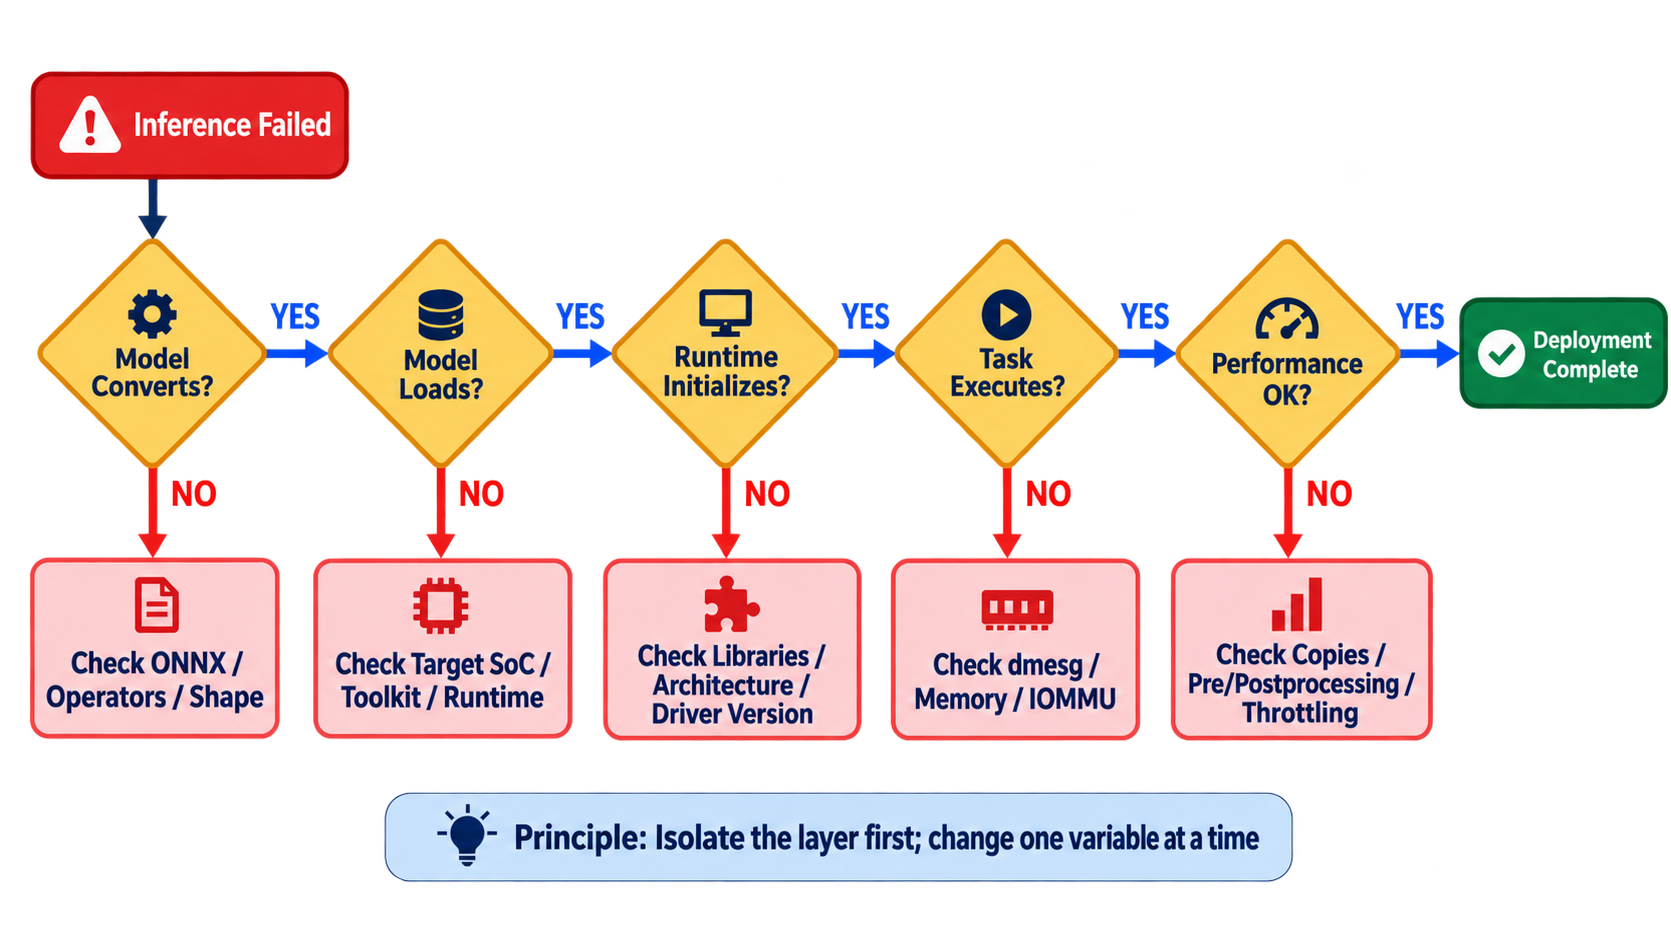
Couche 1 : conversion
Symptômes typiques :
unsupported operator
shape inference failed
build model failed
Vérifiez ONNX, Opset, Shape d’entrée, dimensions dynamiques, opérateurs, journaux et données de calibration.
Couche 2 : chargement
Symptômes typiques :
invalid rknn model
unsupported target platform
load_rknn failed
Vérifiez version du Toolkit, target_platform, lecture par le Runtime et intégrité du fichier.
Couche 3 : initialisation Runtime
Symptômes typiques :
failed to initialize rknn runtime
driver version is too low
cannot open shared object file
undefined symbol
Vérifiez chemins, architecture CPU, 32/64 bits, Runtime chargé, pilote et nœuds de périphérique.
Couche 4 : exécution
Symptômes typiques :
failed to submit task
IOMMU fault
allocate memory failed
Consultez dmesg, mémoire, CMA/DMA, IOMMU, attributs Tensor et concurrence.
Couche 5 : performances
Un modèle fonctionnel n’exploite pas forcément bien le NPU. rknn_run() exclut souvent :
- Lecture et décodage d’image ;
- resize, letterbox et couleurs ;
- Copies CPU–NPU ;
- Décodage et NMS ;
- Attentes inutiles ;
- Choix du cœur NPU ;
- Baisse de fréquence CPU/NPU/mémoire ;
- Thermal throttling ;
- Mauvais pipeline multithread.
Mesurez séparément au minimum :
Temps de lecture des entrées
Temps de prétraitement
Temps d'inférence pure du modèle
Temps de post-traitement
Temps total de bout en bout
Le seul temps NPU peut être flatteur sans représenter l’application réelle.
11. Informations à réunir avant de demander de l’aide
Une information complète vaut mieux qu’un seul message d’erreur. Fournissez au moins :
Modèle du SoC :
Modèle de la carte de développement :
Système d'exploitation et source de l'image :
Version du noyau Linux :
Version du pilote RKNPU :
Version de RKNN-Toolkit2 :
Version de RKNN-Toolkit-Lite2 :
Version de RKNN Runtime :
Version de rknn_server (si utilisé) :
Source du modèle et ONNX Opset :
Plateforme cible :
Quantifié :
Journal complet de l'application :
Journal dmesg pertinent :
L'exemple officiel peut-il s'exécuter :
Le fonctionnement de l’exemple officiel est crucial :
- S’il échoue aussi : système, Runtime ou pilote ;
- S’il réussit mais pas votre modèle : conversion ou E/S ;
- Si C réussit mais Python échoue : paquet Python et bibliothèques ;
- Si l’hôte réussit mais pas le conteneur : périphériques, droits et Runtime.
12. Confusions fréquentes
À retenir :
- Un NPU n’exécute pas tout réseau neuronal ;
- ONNX fonctionnel ne garantit pas la conversion RKNN ;
- Conversion RKNN réussie ne garantit pas la compatibilité embarquée ;
- Mettre à jour
librknnrt.sone met pas à jour le pilote ; - Copier
rknpu.kone signifie pas qu’il est chargé ; - Un pilote récent peut être incompatible avec noyau et BSP ;
- NPU ne signifie pas que tout pré/post-traitement y tourne ;
- Plusieurs cœurs ne multiplient pas automatiquement les performances ;
- Un conteneur ne remplace pas le pilote noyau de l’hôte ;
- Temps NPU et temps de bout en bout diffèrent ;
- Des TOPS égaux n’impliquent pas des performances égales.