Nach dem Start eines RK3588-Boards mit 6-TOPS-NPU führen Sie ein YOLO-Beispiel aus. Es meldet:
rknpu driver version is too low
failed to initialize rknn runtime
invalid rknn model
unsupported target platform
failed to submit task
Was ist passiert?
Solche Probleme sind beim ersten Edge-AI-Deployment häufig. Warum läuft das PC-Programm nicht auf dem Board? Warum gelingt die Konvertierung, aber nicht die Ausführung? Warum läuft dasselbe Modell nur auf einem Board?
Dieser Artikel erklärt die Rockchip-NPU verständlich und gründlich.
Er beantwortet diese Kernfragen:
- Was sind RKNN-Toolkit2, RKNN Runtime und RKNPU-Treiber?
- Warum reicht ein neues
librknnrt.sonicht? - Warum
rknpu.konicht beliebig ersetzen? - Wie unterscheiden sich CNN, Transformer und LLM?
- Liegt der Fehler in Modell, Runtime, Treiber oder Image?
- Wann sollte man keine NPU nutzen?
1. Gesamtbild: RK NPU ist kein Einzelpaket
Zwischen PyTorch und NPU-Ausführung liegen Konverter, Modelldatei, Board-Runtime, Linux-Treiber und NPU-Hardware.
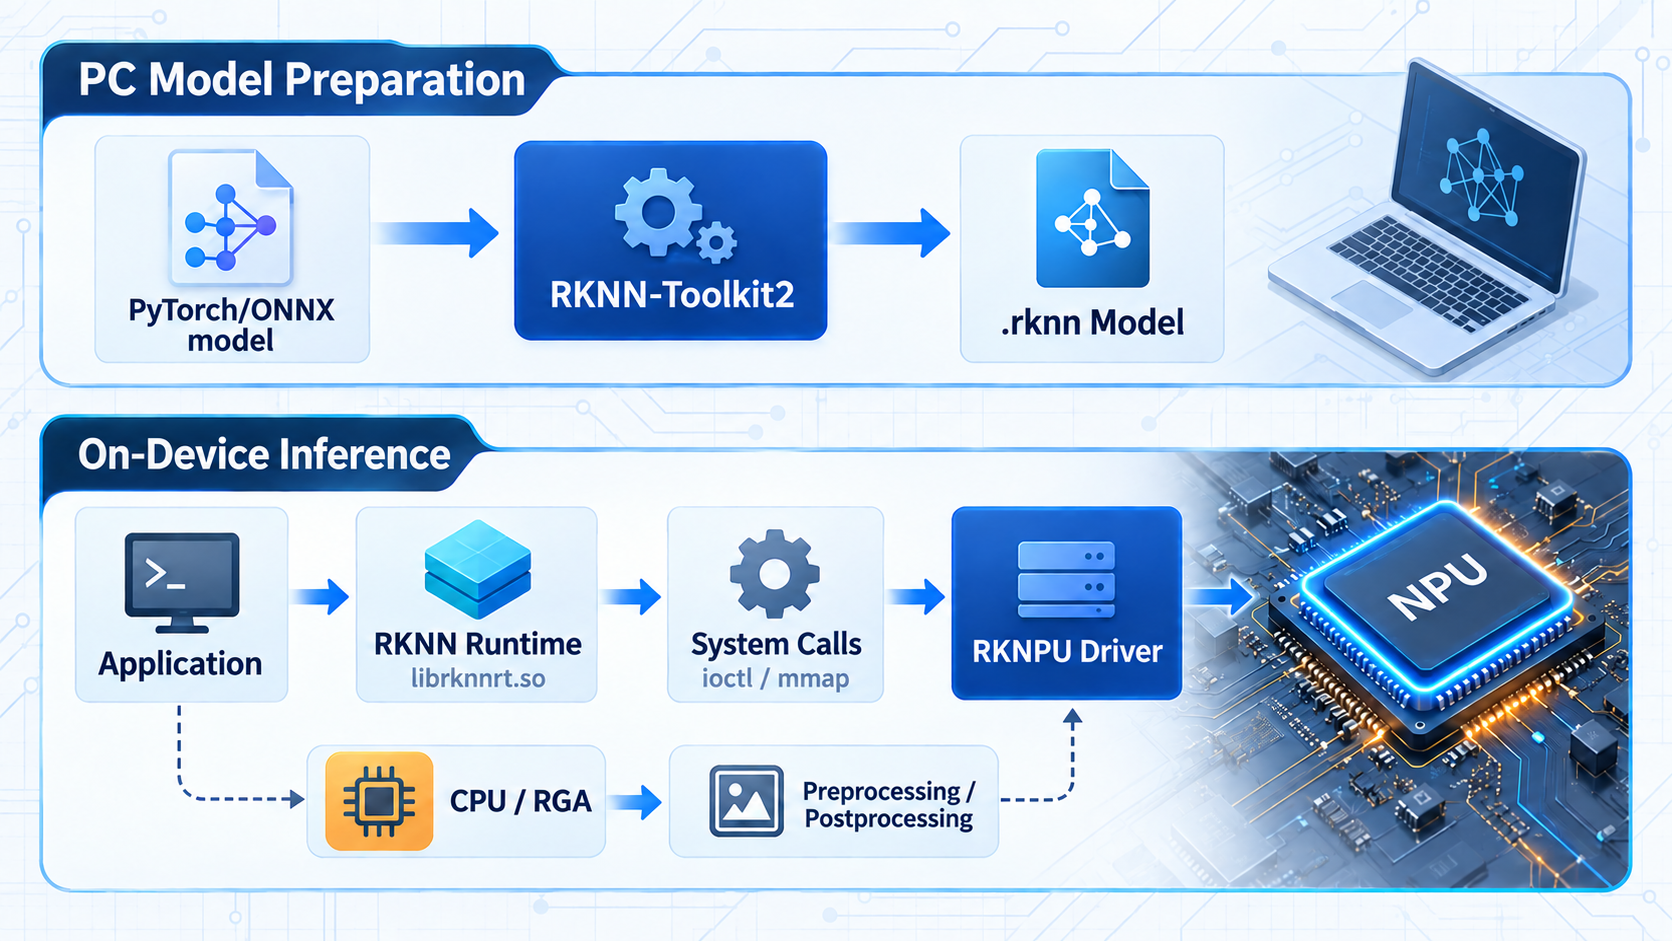
Die Kette hat zwei Phasen.
Modellvorbereitung am PC:
PyTorch / TensorFlow
        ↓
       ONNX
        ↓
RKNN-Toolkit2
        ↓
Für RK3588 oder RK3576 kompiliertes .rknn-Modell
Modellausführung auf dem Board:
Anwendung
   ↓
RKNNLite / RKNN C API
   ↓
librknnrt.so
   ↓
Linux-Systemaufrufe
   ↓
RKNPU-Kerneltreiber
   ↓
NPU-Hardware
Die Komponenten haben verschiedene Aufgaben:
| Komponente | Ort | Hauptaufgabe |
|---|---|---|
| RKNN-Toolkit2 | PC | Analysieren, optimieren, quantisieren, kompilieren |
.rknn | PC/Board | Modell und Ausführungsdaten für eine Rockchip-NPU speichern |
| RKNN-Toolkit-Lite2 | Python auf Board | Python-Inferenz-API bereitstellen |
librknnrt.so | Userspace | Laden, Speicher verwalten, Tasks senden |
| RKNPU-Treiber | Kernel | Hardware, Speicher, Interrupts und Scheduling verwalten |
| NPU | SoC | Faltung, Matrixmultiplikation usw. ausführen |
Siehe das offizielle RKNN-Toolkit2-Repository.
Bestimmen Sie bei Fehlern zuerst die betroffene Schicht.
2. Erzeugung eines .rknn-Modells
Die NPU führt PyTorch oder ONNX nicht direkt aus. ONNX tauscht Graphen aus; .rknn ist für Rockchip optimiert und kompiliert.
Minimale ONNX-Konvertierung:
from rknn.api import RKNN

rknn = RKNN(verbose=True)

rknn.config(
    target_platform="rk3576",
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
)

rknn.load_onnx(model="model.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("model_rk3576.rknn")
rknn.release()
target_platform bindet das Modell an einen Chip. Ein RK3588-Modell läuft nicht automatisch auf RK3576 oder RK3568.
RKNN-Toolkit2 erledigt außerdem:
- Graph- und Tensor-Shape-Analyse;
- Konstantenfaltung und Knotenentfernung;
- NPU-gerechte Operatorfusion;
- NCHW/NHWC-Konvertierung;
- Prüfung von Operatoren, Typen und Shapes;
- FP16-, INT8- oder andere Quantisierung;
- Erzeugung von Graph und Gewichten.
ONNX Runtime-Erfolg garantiert weder RKNN-Konvertierung noch Board-Laden.
Das Laden hängt auch von Runtime, Treiber, Speicher und Chip ab.
3. Was ist die Runtime?
Auf RK3588/RK3576-Linux ist ihr Kern meist:
librknnrt.soSie ist eine Userspace-Bibliothek, kein Kernel-Treiber oder Komplettsystem.
Python-Aufrufpfad:
Python-Anwendung
   ↓
RKNNLite
   ↓
librknnrt.so
   ↓
RKNPU-Treiber
C/C++-Aufrufpfad:
C/C++-Anwendung
   ↓
RKNN C API
   ↓
librknnrt.so
   ↓
RKNPU-Treiber
Minimales Python-Beispiel:
from rknnlite.api import RKNNLite

runtime = RKNNLite()

ret = runtime.load_rknn("model_rk3576.rknn")
if ret != 0:
    raise RuntimeError("load_rknn failed")

ret = runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)
if ret != 0:
    raise RuntimeError("init_runtime failed")

outputs = runtime.inference(inputs=[input_tensor])
runtime.release()
init_runtime() erstellt einen Inferenzkontext und kann:
- Chip und Treiber prüfen;
- RKNN-Modell parsen;
- Kompatibilität prüfen;
- NPU-Kerne wählen;
- Gewicht- und Tensor-Speicher vorbereiten;
- Treiberressourcen anlegen.
Die Runtime übersetzt und plant; der Treiber steuert die NPU.
Ist rknn_server erforderlich?
Nein. Er verbindet PC und Board per USB/ADB für Debugging, Analyse und Remote-Inferenz.
Lokale Anwendungen rufen meist librknnrt.so direkt auf.
4. Position des RKNPU-Treibers
Nur der Kernel-Treiber darf Register, Interrupts und physischen Speicher bedienen.
Benutzerraum: Anwendung → RKNNLite / RKNN API → librknnrt.so
                         │
                    Systemaufrufgrenze
                         │
Kernelraum:           RKNPU-Treiber
                         │
Hardware:             NPU
Er übernimmt:
- NPU-Initialisierung;
- Takt, Stromdomänen und Reset;
- NPU-Speicher;
- Runtime-Tasks;
- Kern-Scheduling;
- Interrupts und Abschlussmeldungen;
- IOMMU-Adressabbildung;
- Versions- und Fähigkeitsangaben.
Was sind ioctl und mmap?
Runtime und Treiber kommunizieren über ioctl, mmap, poll und DMA.
ioctlsendet Gerätebefehle;mmapbildet Treiberpuffer in den Prozess ab;DMAerlaubt derNPUSpeicherzugriff ohne Bytekopie durch dieCPU;pollwartet auf Abschluss.
Vereinfacht:
mmap: bestimmt, wo Daten abgelegt werden und wie beide Seiten darauf zugreifen
ioctl: teilt dem Gerät mit, welche Operation es ausführen soll
librknnrt.so kapselt Synchronisation, Task-Übergabe und Warten.
Wie Netzwerk oder USB erreicht RKNN die Hardware über Runtime und Treiber.
5. Warum Versionskompatibilität wichtig ist
Ein Deployment umfasst mehrere Versionen:
RKNN-Toolkit2-Version
        ↓
.rknn-Modellformat und Zielchip
        ↓
RKNN-Toolkit-Lite2- / librknnrt.so-Version
        ↓
RKNPU-Treiberversion
        ↓
Linux-Kernel und BSP
Auch rknn_server, Header und Bibliotheken müssen zum SDK passen.
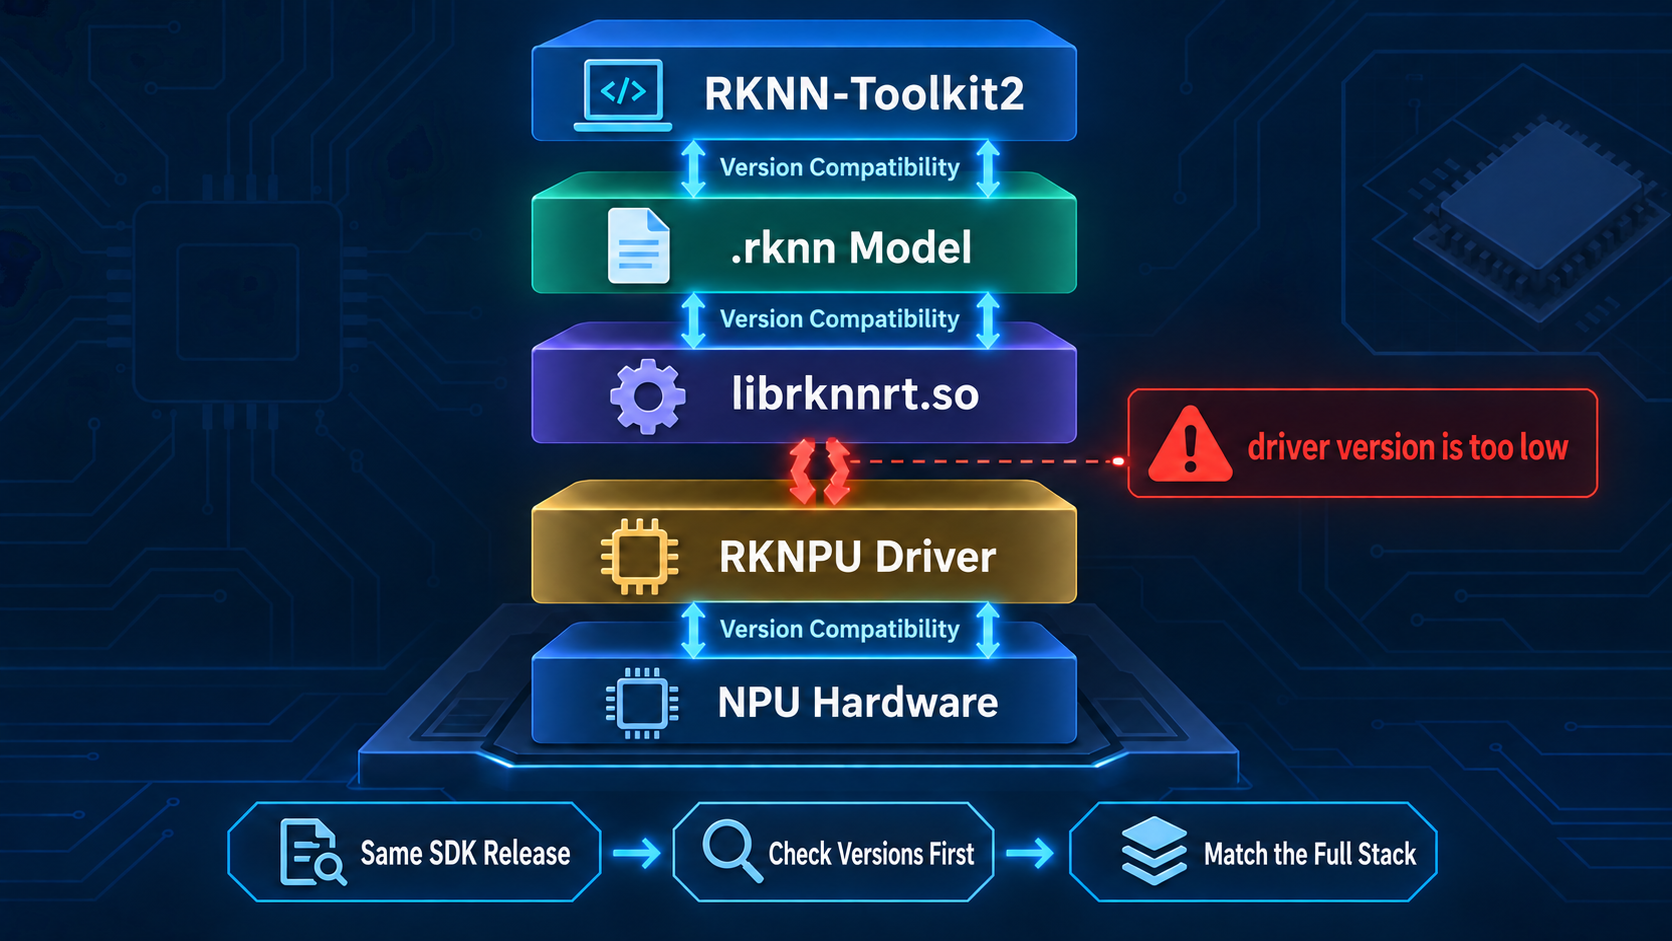
Typische Konflikte:
- Neues Toolkit, zu alte Runtime;
- Neues
librknnrt.so, zu alter Treiber; - Neues Python-Paket lädt alte Runtime;
- Server und Runtime aus verschiedenen Releases;
- RK3588-Modell auf RK3576;
- Neue Container-Runtime, alter Host-Treiber.
Nutzen Sie die offizielle Board-Dokumentation; veraltete Unterlagen verursachen solche Konflikte.
reComputer AI Lab bündelt aktuelle RK3588/RK3576-Ressourcen. Es bietet CV-, LLM-, VLM-Deployments, Werkzeuge und offene Praxisprojekte.
Für Produkte gilt nicht „alles neu“, sondern:
Toolkit, Modell, Runtime, Server und Treiber als geprüfte Kombination verwenden.
6. Entstehung von rknpu driver version is too low
Ersetzen Sie rknpu.ko nicht sofort, sondern klären Sie die Ursache.
librknnrt.so fragt Treiberversion und Fähigkeiten ab; fehlen benötigte Funktionen, erscheint:
rknpu driver version is too lowOft wurde auf einem alten Board nur die Runtime aktualisiert, nicht Image und Wiki. Fehlende Herstellerdokumentation führt später zu Problemen; Preis allein genügt nicht.
Meist ist es eine Runtime-Treiber-Inkompatibilität, kein Dateischaden.
Häufige Ursachen:
- Nur
librknnrt.soaktualisiert; - Falsche von mehreren Kopien geladen;
- Neues Modul liegt nur auf Disk;
- Treiber ist fest im Kernel;
vermagic, Symbole oder Konfiguration passen nicht;- Container neu, Host-Treiber alt;
- BSP und Runtime gehören nicht zusammen.
Sammeln Sie zunächst:
# Kernelversion prüfen
uname -a

# Initialisierung und Fehlermeldungen des RKNPU-Treibers prüfen
dmesg | grep -i rknpu

# Wenn der Treiber als Modul geladen wird, aktuelle Module auflisten
lsmod | grep rknpu

# Modul auf dem Datenträger prüfen; Pfad an das tatsächliche System anpassen
modinfo rknpu

# Alle Runtime-Kopien im System suchen
find / -name 'librknnrt.so*' 2>/dev/null

# Von der Anwendung eingebundene Shared Libraries prüfen
ldd ./your_application
Bei laufendem Prozess zusätzlich:
grep librknnrt /proc/$(pidof your_application)/mapsDamit sehen Sie, welches librknnrt.so tatsächlich geladen ist.
Empfohlene Reihenfolge:
Aktuelle Kernel- und Treiberversionen bestätigen
        ↓
Die tatsächlich von der Anwendung geladene Runtime bestätigen
        ↓
Zielchip des Modells und Version des Konvertierungswerkzeugs bestätigen
        ↓
Kompatibles SDK oder System-Image des Board-Herstellers suchen
        ↓
Falls erforderlich, das gesamte BSP aktualisieren oder den Treiber gegen den aktuellen Kernel-Quellcode neu kompilieren
7. Warum rknpu.ko nicht beliebig ersetzen?
.ko ist ein Kernelmodul und muss exakt zum laufenden Kernel passen.
Prüfen Sie die Bauweise:
CONFIG_ROCKCHIP_RKNPU=y   Treiber in den Kernel integriert
CONFIG_ROCKCHIP_RKNPU=m   Treiber als separates Modul kompiliert
Bei fest eingebautem Treiber hilft Kopieren nicht; Kernel oder Image müssen aktualisiert werden.
Bei Modulen muss gelten:
- Passende Kernelquellen;
- Kompatible Konfiguration und Toolchain;
- Passendes
vermagic; - Vorhandene Kernelsymbole;
- Passender Device Tree, Strom, Takt, IOMMU und Speicher;
- Keine NPU-Nutzung;
- Signatur und Secure Boot erlauben das Laden.
Vergleichen Sie Kernel und Modul:
uname -r
modinfo ./rknpu.ko | grep vermagic
Erfolgreiches Laden garantiert nicht das BSP. Priorität:
- Komplettes Hersteller-Image;
- Neuaufbau aus passendem BSP;
- Einzelmodul nur bei vollständiger Übereinstimmung;
- Bootfähige Sicherung behalten.
RKNPU 0.9.8 ist erst aktiv, wenn der laufende Kernel den kompatiblen 0.9.8-Treiber lädt, nicht wenn nur eine .ko-Datei existiert.
8. Deployment von CNN, Transformer und LLM
Die Modelltypen nutzen nicht zwingend denselben Weg.
CNN: typischer RKNN-Weg
Klassifikation, YOLO, Segmentierung und Pose verwenden meist:
PyTorch → ONNX → RKNN-Toolkit2 → .rknn → RKNN Runtime → NPUFaltung, Aktivierung und Pooling passen gut; wichtig sind:
- Eingabegröße und Layout;
- RGB/BGR-Reihenfolge;
- mean/std gegenüber Vorverarbeitung;
- INT8-Datensatz;
- Head-Decoding und NMS;
- Kopien zwischen Kamera, RGA und NPU.
Transformer: Operatoren und dynamische Shapes
Bei RKNN-Toolkit2 beachten:
- MatMul;
- Softmax;
- LayerNorm/RMSNorm;
- reshape/transpose;
- Dynamische Sequenzlängen;
- Tensor-Speicher;
- CPU-/GPU-Hilfsoperatoren.
Der Name Transformer garantiert keine vollständige NPU-Ausführung; entscheidend sind Operatoren, Shapes und Typen.
LLM: meist RKLLM
LLMs nutzen KV Cache, Prefill, Token-Decode, lange Kontexte und Sampling; siehe RKNN-LLM:
Hugging-Face-Modell
        ↓
Konvertierung und Quantisierung mit RKLLM-Toolkit
        ↓
.rkllm-Modell
        ↓
RKLLM Runtime
        ↓
RKNPU-Treiber und NPU
RKLLM nutzt RKNPU, unterscheidet sich aber bei Modell, API und Ausführung. Prüfen Sie die offizielle Liste.
9. Zwei Wege für große Modelle auf RK3588
Üblich sind zwei Wege.
Weg 1: GGUF + llama.cpp + CPU
Einfach, große Modellauswahl, gut debuggbar; vermeidet RKNN-Konvertierung und Treiberkonflikte.
Geeignet für:
- Schnelle Validierung;
- Häufigen Modellwechsel;
- Maximale Kompatibilität;
- Teams ohne NPU-Erfahrung;
- Nicht unterstützte RKLLM-Modelle.
Nachteile sind höhere CPU-Last, Energieverbrauch und eventuell geringerer Token-Durchsatz.
Weg 2: RKLLM + NPU
Mehr Durchsatz, aber mehr Engineering:
- Architektur prüfen;
- Mit vorgegebener Toolchain konvertieren;
- Runtime und Treiber abstimmen;
- Quantisierungsgenauigkeit prüfen;
- Gewichte, KV Cache und Speicher planen;
- Prefill und Decode trennen;
- Kontextlängen testen.
Die NPU führt GGUF nicht direkt aus, sondern nutzt eigenes Format und Runtime.
Entscheidungshilfe:
| Bedarf | Startpunkt |
|---|---|
| Schnell starten | GGUF + CPU |
| Oft wechseln | GGUF + CPU |
| Festes Modell, hohe Leistung | RKLLM + NPU prüfen |
| Nicht offiziell unterstützt | CPU/anderes Backend |
| Produktion | Gesamten NPU-Stack fixieren und prüfen |
Messen Sie Ende-zu-Ende statt nur TOPS; Speicher, Bandbreite, KV Cache und CPU beeinflussen LLMs.
10. Schichtweise Fehlersuche
Bestimmen Sie zuerst die fehlerhafte Schicht.
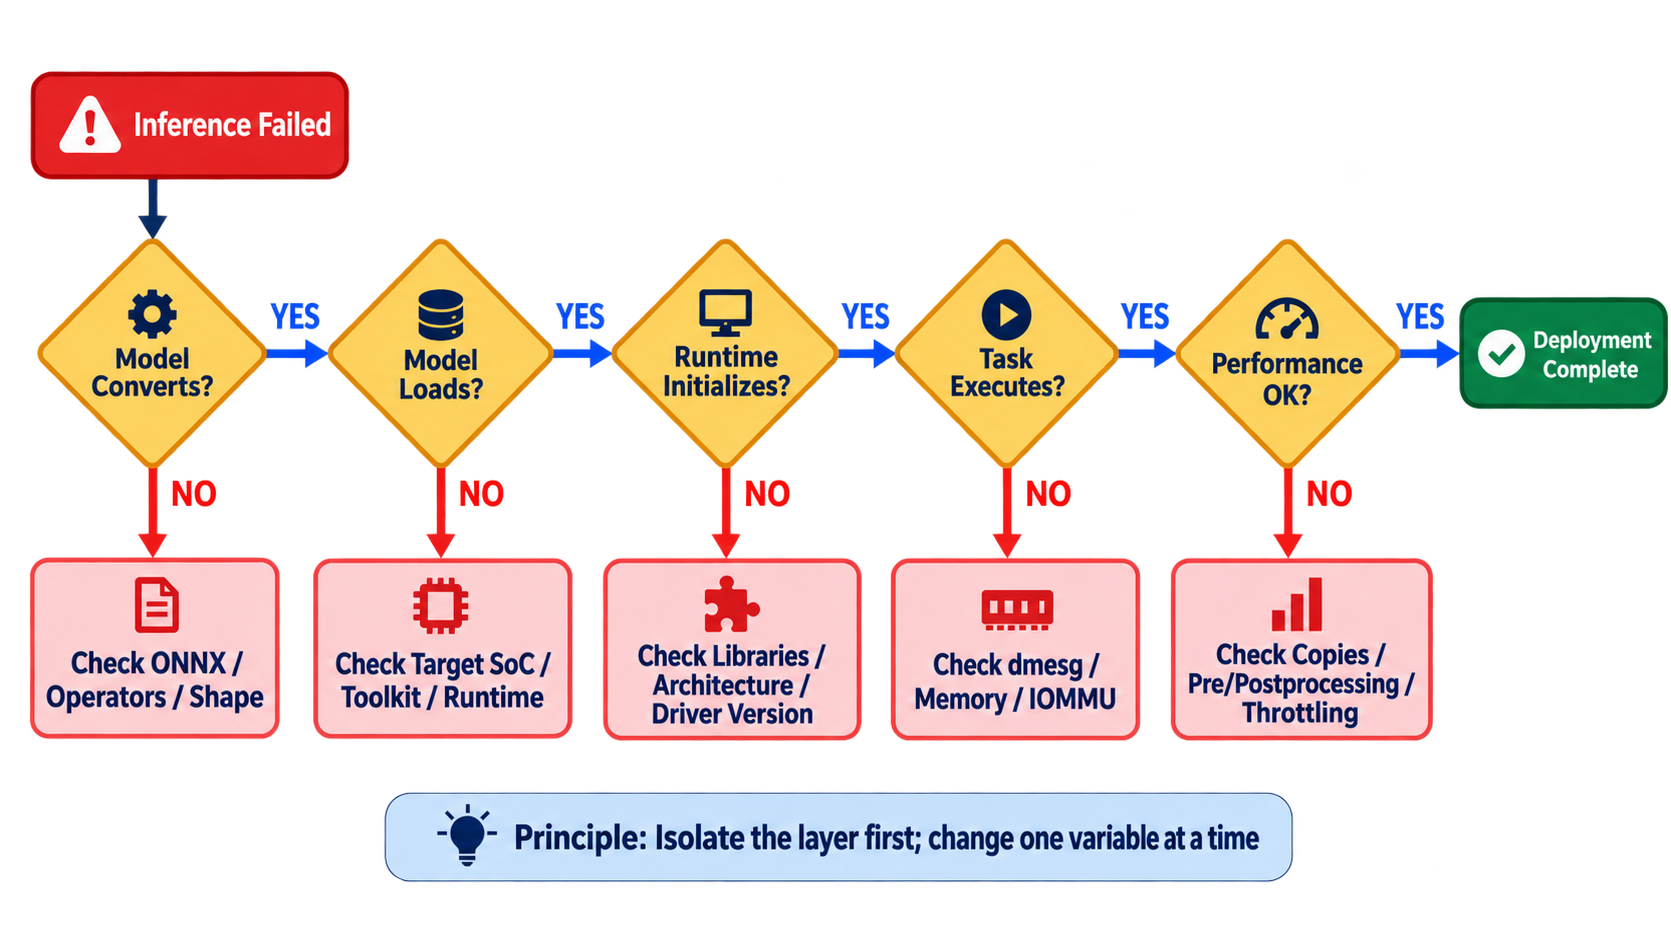
Schicht 1: Konvertierung
Typische Symptome:
unsupported operator
shape inference failed
build model failed
Prüfen Sie ONNX, Opset, Shape, Dynamik, Operatoren, Logs und Kalibrierdaten.
Schicht 2: Laden
Typische Symptome:
invalid rknn model
unsupported target platform
load_rknn failed
Prüfen Sie Toolkit, target_platform, Runtime-Unterstützung und Datei.
Schicht 3: Runtime-Initialisierung
Typische Symptome:
failed to initialize rknn runtime
driver version is too low
cannot open shared object file
undefined symbol
Prüfen Sie Bibliothekspfad, Architektur, 32/64 Bit, Runtime, Treiber und Device Nodes.
Schicht 4: Ausführung
Typische Symptome:
failed to submit task
IOMMU fault
allocate memory failed
Prüfen Sie dmesg, Speicher, CMA/DMA, IOMMU, Tensoren und Parallelität.
Schicht 5: Leistung
rknn_run() enthält oft nicht:
- Bildlesen und Decodieren;
- resize, letterbox und Farbkonvertierung;
- CPU-NPU-Kopien;
- Decoding und NMS;
- Unnötiges Warten;
- NPU-Kernauswahl;
- Taktabsenkung;
- Thermal Throttling;
- Schlechte Thread-Pipeline.
Messen Sie mindestens getrennt:
Zeit zum Einlesen der Eingabe
Vorverarbeitungszeit
Reine Modellinferenzzeit
Nachverarbeitungszeit
Gesamte End-to-End-Zeit
Reine NPU-Zeit bildet reale Anwendungsleistung nicht ab.
11. Angaben vor einer Supportfrage
Vollständige Daten sind wichtiger als eine Fehlermeldung:
SoC-Modell:
Entwicklungsboard-Modell:
Betriebssystem und Image-Quelle:
Linux-Kernelversion:
RKNPU-Treiberversion:
RKNN-Toolkit2-Version:
RKNN-Toolkit-Lite2-Version:
RKNN-Runtime-Version:
rknn_server-Version (falls verwendet):
Modellquelle und ONNX Opset:
Zielplattform:
Quantisiert:
Vollständiges Anwendungsprotokoll:
Relevantes dmesg-Protokoll:
Kann das offizielle Beispiel ausgeführt werden:
Entscheidend ist der offizielle Test:
- Scheitert er: System, Runtime oder Treiber;
- Gelingt er: eigenes Modell oder E/A;
- C gelingt, Python nicht: Paket und Bibliothekspfad;
- Host gelingt, Container nicht: Mapping, Rechte und Runtime.
12. Häufige Irrtümer
Merksätze:
- Eine NPU führt nicht jedes Netz aus;
- ONNX-Erfolg garantiert RKNN nicht;
- RKNN-Konvertierung garantiert Board-Kompatibilität nicht;
librknnrt.soaktualisiert keinen Kernel-Treiber;- Kopieren von
rknpu.kolädt ihn nicht; - Neuer Treiber passt nicht zwingend zu Kernel/BSP;
- Vor-/Nachverarbeitung läuft nicht zwingend auf NPU;
- Mehr Kerne skalieren ein Modell nicht automatisch;
- Container ersetzen keinen Host-Treiber;
- NPU-Zeit ist nicht Ende-zu-Ende;
- Gleiche TOPS bedeuten nicht gleiche Praxisleistung.