このプロジェクトは、RK1828 アクセラレーターを 1 基搭載した reComputer RK3576 上で Qwen3-4B をローカル実行します。ブラウザー画面には、初回応答、長文中の情報検索(Needle-in-a-Haystack)、複数ターンの会話記憶という 3 種類のテストが用意されています。モデルサーバーとテスト画面はボード上で動作し、テスト中にクラウドのモデル API を使用しません。
テスト内容
| テスト | 確認すること |
|---|---|
| 初回応答 | 新しい KV キャッシュで質問を処理したときの応答時間。 |
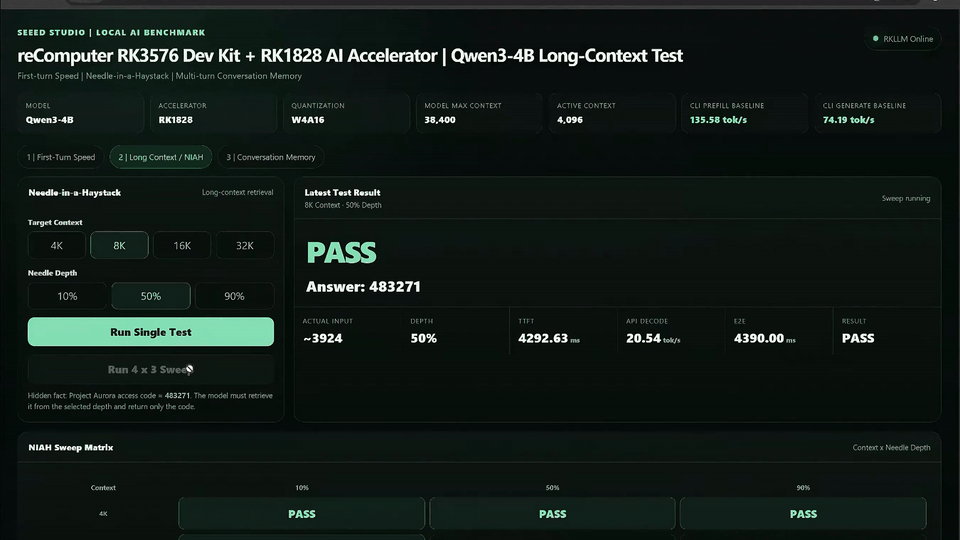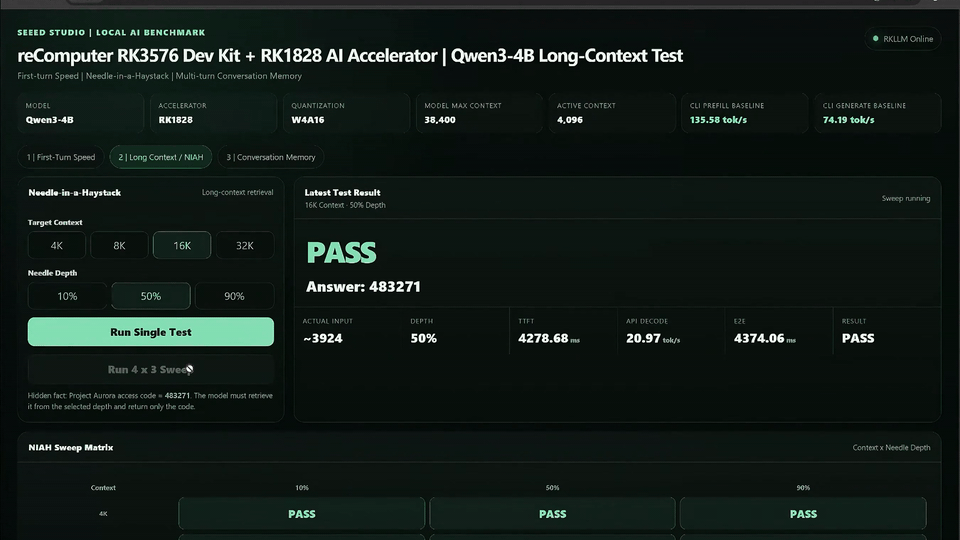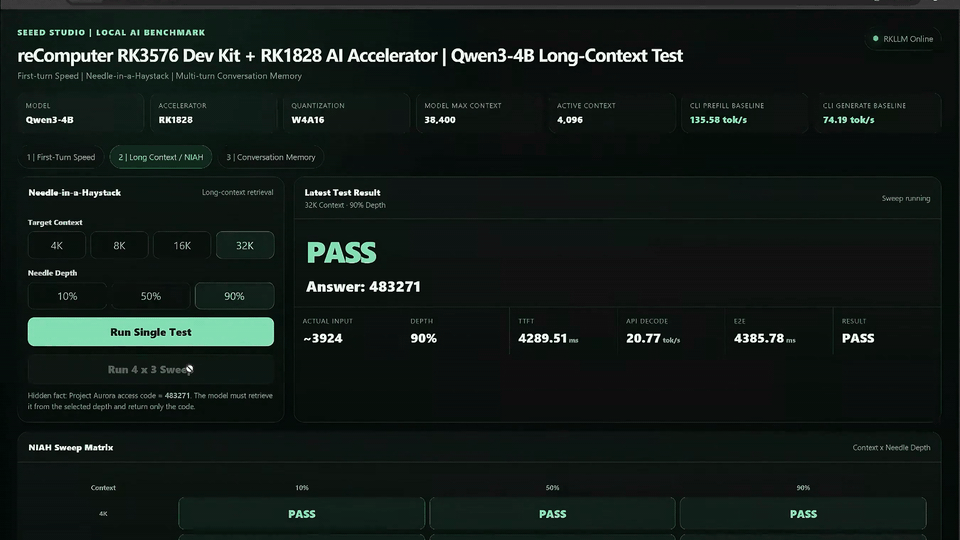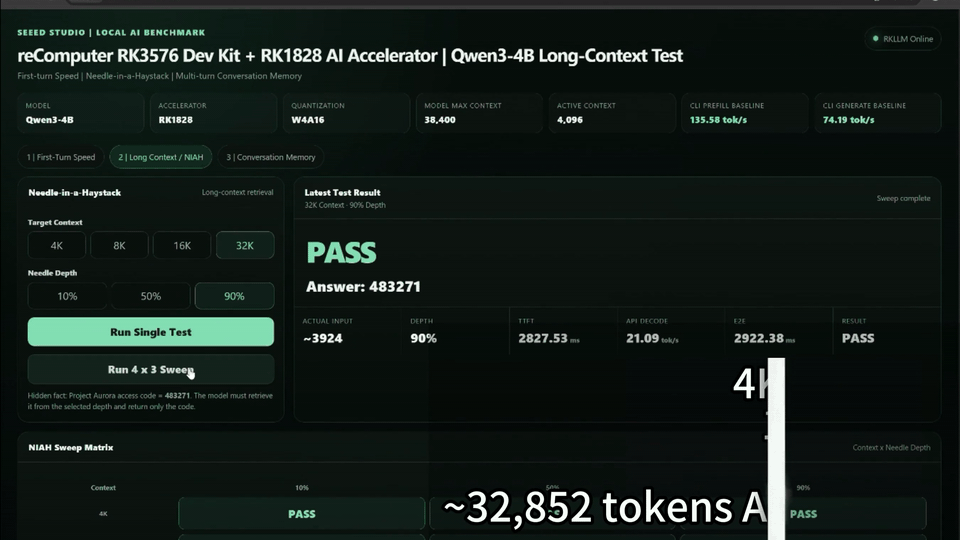
| Needle-in-a-Haystack | 長文中の異なる位置に隠した情報を正しく取り出せるか。 |
| 会話記憶 | 無関係な会話を何ターンも挟んだ後、先に与えた情報を思い出せるか。 |
画面に表示されるのはアプリケーション層のストリーミング測定値です。コマンドラインの RKNN3 または RKLLM ベンチマーク結果とは測定条件が異なります。
ハードウェアと環境
- RK1828 モジュールを装着し、ボードが認識している reComputer RK3576。
- ボード上で
rkllm3-serverを実行できる、互換性のある RKNN3/RKLLM ランタイム。 - FastAPI テスト画面用の Python 3 と
venv。依存関係はプロジェクト内のrequirements.txtを参照してください。 - 別途入手した RK1828 対応 Qwen3-4B モデルパッケージ。独立配布のプロジェクトアーカイブにはモデルのバイナリは含まれません。
起動スクリプトは MODEL_DIR に Qwen3-4B.rknn、Qwen3-4B.weight、Qwen3-4B.tokenizer.gguf、Qwen3-4B.embed.bin があることを想定しています。起動前にモデルとインストール済みランタイムの互換性を確認してください。
実行方法
リポジトリを取得し、このプロジェクトのディレクトリに移動します。
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1828-4b-benchmark
chmod +x *.sh
./check_env.sh
最初のターミナルで MODEL_DIR を実際のモデルディレクトリに設定し、モデルサーバーを起動します。
MODEL_DIR=/path/to/Qwen3-4B ./start_model_server.shそのターミナルを実行したまま、2 つ目のターミナルで同じプロジェクトディレクトリから画面を起動します。
./start_ui.sh同じネットワークのブラウザーで http://<RK3576-IP>:7862 を開きます。画面は既定で http://127.0.0.1:8080 のローカルモデルサーバーに接続します。
カバー画像の 32K デモについて
カバー GIF は、録画された RK1828 / Qwen3-4B 長文コンテキスト・テストから切り出したものです。リポジトリの起動スクリプトが既定で使用する有効コンテキストは 4,096 token であり、映像の 32K 設定とは異なります。より長いコンテキストを試すには、対応するモデルを用意し、サーバーの CTX_SIZE と画面の SERVER_CONTEXT を同じ対応値に設定してください。start_model_server.sh が参照するモデルファイル名も、実際のモデルパッケージに合わせる必要があります。
映像中の処理時間や検索結果はその実行例の記録です。別のボードやモデルビルドで同じ結果が得られる保証はなく、モデル、ランタイム、コンテキスト長、入力によって結果は変わります。
ソースと制約
モデルファイルと互換性のあるボード側ランタイムは別途準備が必要です。Web UI は信頼できるローカルネットワーク向けです。ネットワーク外へ公開する前にアクセス制御を確認してください。