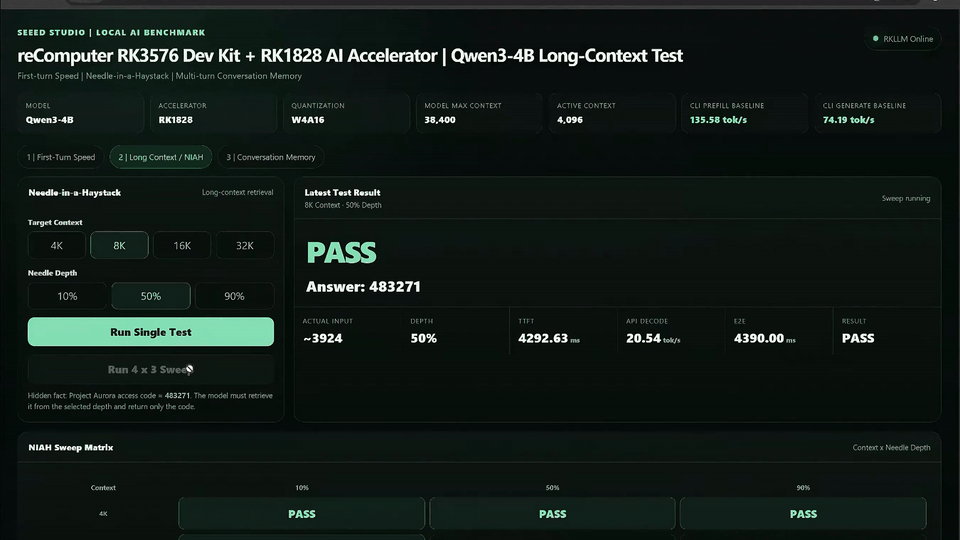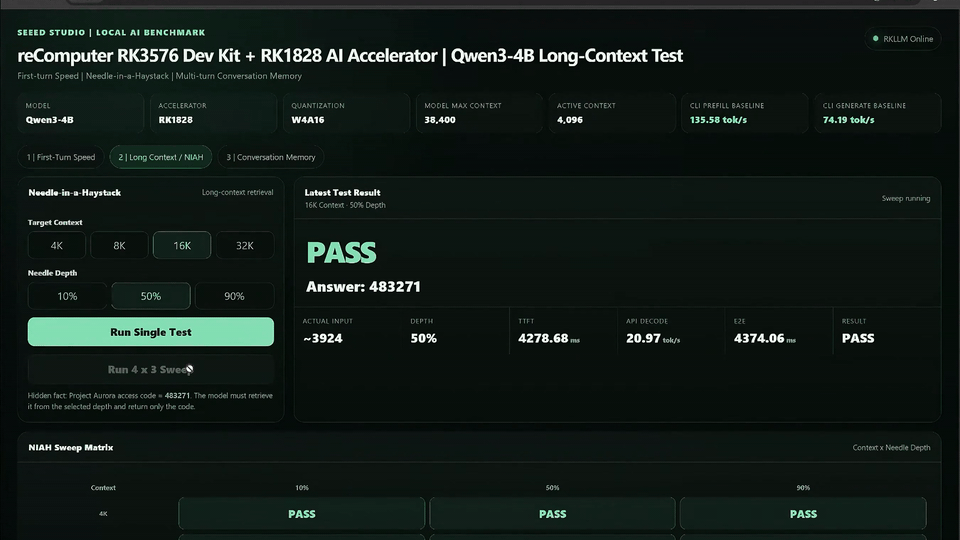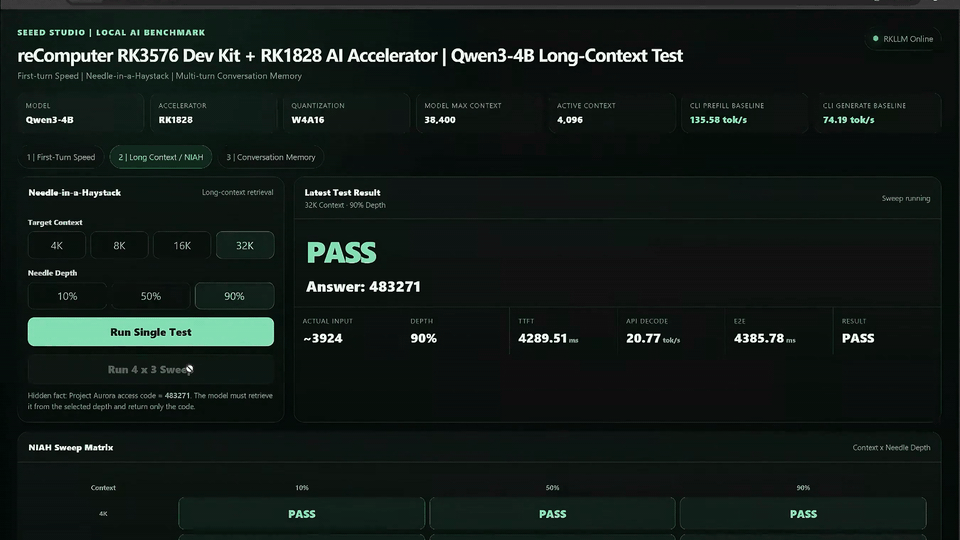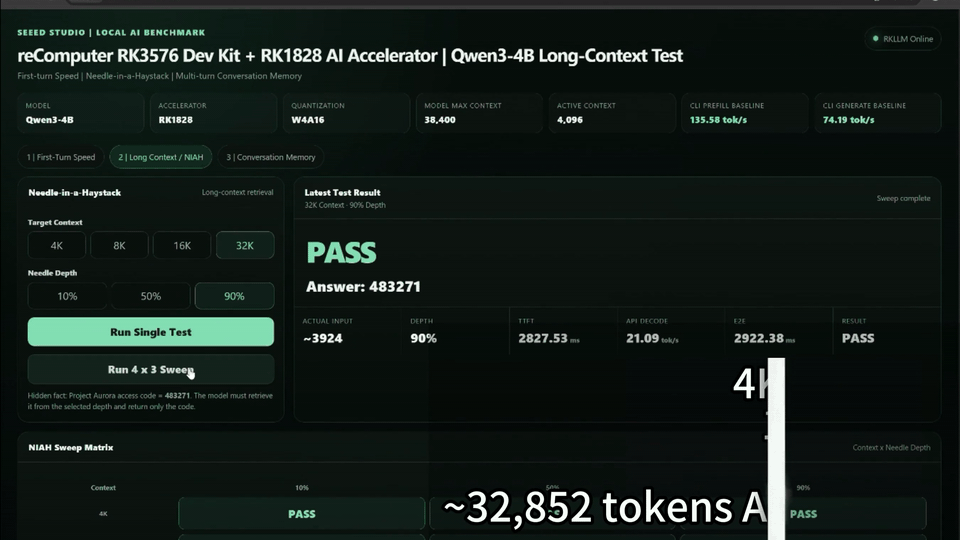
Ce projet exécute Qwen3-4B localement sur un reComputer RK3576 équipé d'un accélérateur RK1828. Son interface Web regroupe trois tests : la première réponse, la recherche d'une information cachée dans un long texte (needle-in-a-haystack) et la mémoire sur plusieurs tours de conversation. Le serveur de modèle et l'interface fonctionnent sur la carte, sans API de modèle dans le cloud pendant les tests.
Ce que mesurent les tests
| Test | Objectif |
|---|---|
| Première réponse | Observer le délai pour une nouvelle requête avec un cache KV vierge. |
| Needle-in-a-haystack | Vérifier la récupération d'une information placée à différentes positions d'un long texte. |
| Mémoire conversationnelle | Vérifier le rappel d'une information après de nombreux échanges sans rapport. |
L'interface affiche des mesures de streaming au niveau de l'application. Elles ne correspondent pas directement aux résultats d'un benchmark RKNN3 ou RKLLM en ligne de commande.
Matériel et environnement
- reComputer RK3576 avec un module RK1828 installé et reconnu.
- Runtime RKNN3/RKLLM compatible et commande
rkllm3-serverdisponible sur la carte. - Python 3 et
venvpour l'interface FastAPI ; les dépendances sont définies dans lerequirements.txtdu projet. - Paquet du modèle Qwen3-4B pour RK1828 obtenu séparément. L'archive autonome du projet ne contient pas les binaires du modèle.
Le script de lancement attend Qwen3-4B.rknn, Qwen3-4B.weight, Qwen3-4B.tokenizer.gguf et Qwen3-4B.embed.bin dans MODEL_DIR. Vérifiez leur compatibilité avec le runtime installé.
Exécution
Clonez le dépôt et ouvrez le dossier du projet :
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1828-4b-benchmark
chmod +x *.sh
./check_env.sh
Dans un premier terminal, pointez vers le modèle et lancez son serveur :
MODEL_DIR=/path/to/Qwen3-4B ./start_model_server.shLaissez ce terminal ouvert. Dans un second terminal, depuis le même dossier, lancez l'interface :
./start_ui.shOuvrez http://<RK3576-IP>:7862 depuis un navigateur du même réseau. L'interface se connecte par défaut au serveur local http://127.0.0.1:8080.
À propos de la démonstration 32K
Le GIF de couverture provient d'un test de contexte long RK1828 / Qwen3-4B enregistré. Les scripts du dépôt démarrent avec un contexte actif de 4 096 tokens par défaut, différent de la configuration 32K montrée dans la vidéo. Pour tester un contexte plus long, utilisez un modèle adapté et donnez à CTX_SIZE côté serveur et à SERVER_CONTEXT côté interface la même valeur prise en charge. Le nom du modèle attendu par start_model_server.sh doit également correspondre aux fichiers fournis.
Les délais et résultats de récupération visibles dans la vidéo décrivent cette exécution précise. Ils peuvent varier selon la carte, le modèle, le runtime, la longueur de contexte et l'entrée.
Sources et limites
Les fichiers du modèle et un runtime compatible doivent être préparés séparément. L'interface Web est destinée à un réseau local de confiance ; vérifiez les contrôles d'accès avant de l'exposer au-delà de ce réseau.