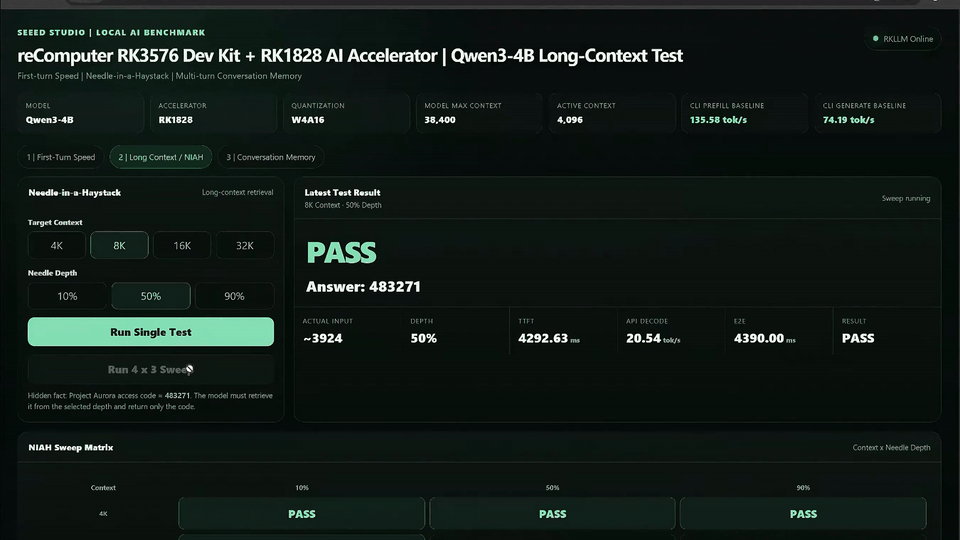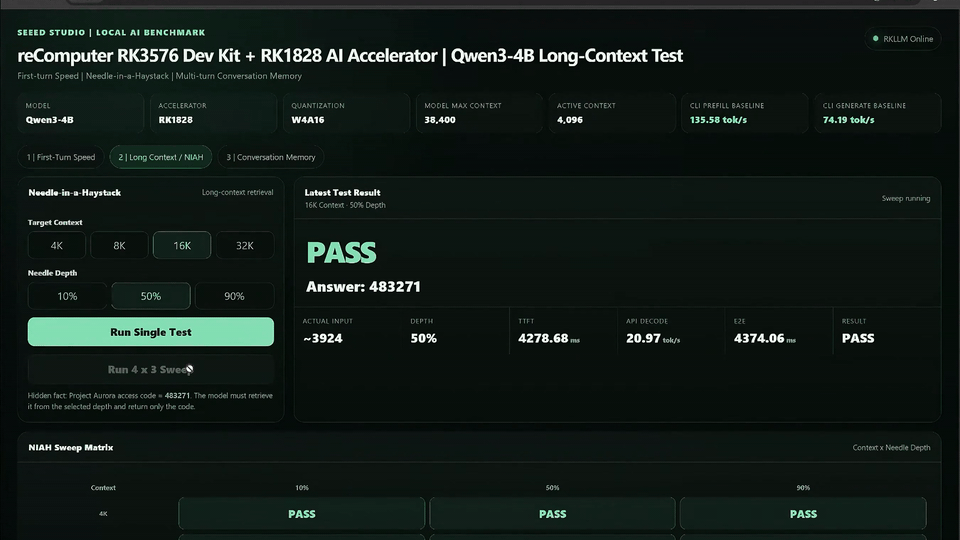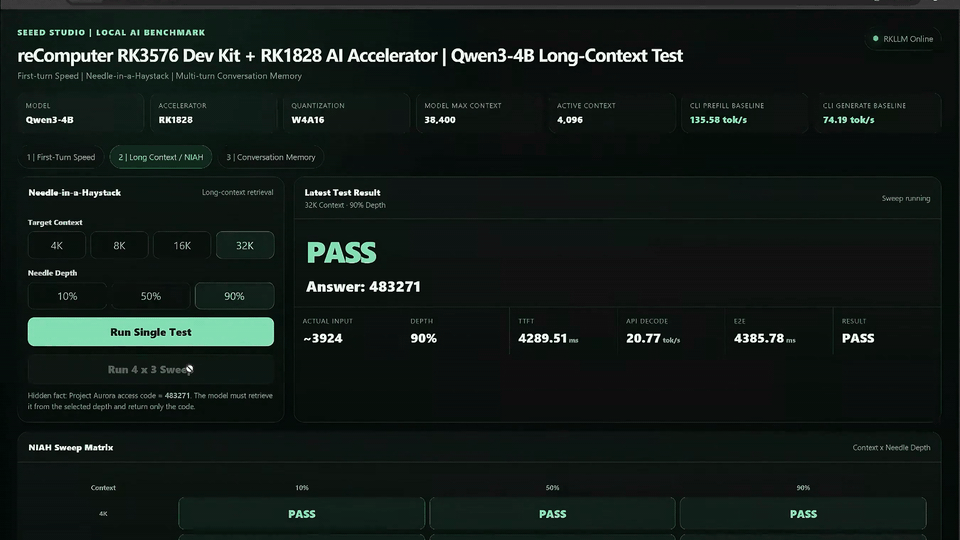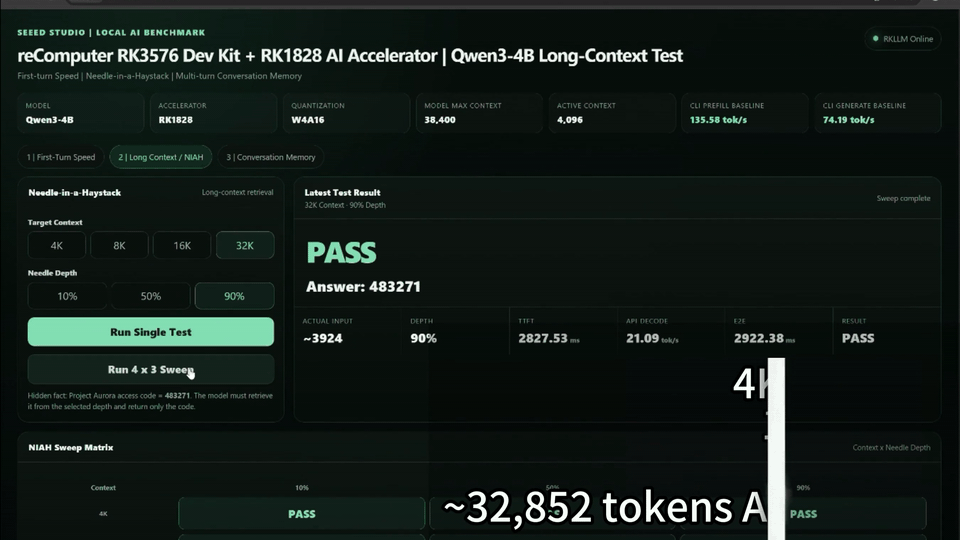
Dieses Projekt führt Qwen3-4B lokal auf einem reComputer RK3576 mit einem RK1828-Beschleuniger aus. Die Browseroberfläche vereint drei Tests: Erstantwort, Suche nach versteckten Informationen in langen Texten (Needle-in-a-Haystack) und Gedächtnis über viele Gesprächsrunden. Modellserver und Testoberfläche laufen auf dem Board; während der Tests ist keine Cloud-Modell-API nötig.
Was die Tests zeigen
| Test | Ziel |
|---|---|
| Erstantwort | Antwortzeit für eine neue Anfrage mit leerem KV-Cache. |
| Needle-in-a-Haystack | Wiederfinden einer versteckten Information an verschiedenen Stellen eines langen Textes. |
| Gesprächsgedächtnis | Erinnern an frühere Informationen nach vielen thematisch unabhängigen Gesprächsrunden. |
Die Oberfläche zeigt Streaming-Messungen auf Anwendungsebene. Diese sind nicht direkt mit Befunden aus einem RKNN3- oder RKLLM-Kommandozeilenbenchmark vergleichbar.
Hardware und Umgebung
- reComputer RK3576 mit installiertem und erkanntem RK1828-Modul.
- Kompatible RKNN3/RKLLM-Laufzeit und
rkllm3-serverauf dem Board. - Python 3 und
venvfür die FastAPI-Testoberfläche; Abhängigkeiten stehen in derrequirements.txtdes Projekts. - Ein separat bezogenes Qwen3-4B-Modellpaket für RK1828. Das eigenständige Projektarchiv enthält keine Modellbinärdateien.
Das Startskript erwartet Qwen3-4B.rknn, Qwen3-4B.weight, Qwen3-4B.tokenizer.gguf und Qwen3-4B.embed.bin in MODEL_DIR. Prüfen Sie vor dem Start die Kompatibilität mit der installierten Laufzeit.
Projekt ausführen
Klonen Sie das Repository und wechseln Sie in den Projektordner:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1828-4b-benchmark
chmod +x *.sh
./check_env.sh
Starten Sie den Modellserver im ersten Terminal mit dem tatsächlichen Modellverzeichnis:
MODEL_DIR=/path/to/Qwen3-4B ./start_model_server.shLassen Sie das Terminal geöffnet. Starten Sie in einem zweiten Terminal aus demselben Projektordner die Browseroberfläche:
./start_ui.shÖffnen Sie http://<RK3576-IP>:7862 in einem Browser desselben Netzwerks. Standardmäßig verbindet sich die Oberfläche mit dem lokalen Modellserver unter http://127.0.0.1:8080.
Zum 32K-Demo auf dem Cover
Das Cover-GIF stammt aus einem aufgezeichneten RK1828 / Qwen3-4B Langkontext-Test. Die Startskripte des Repositorys verwenden standardmäßig einen aktiven Kontext von 4.096 Tokens; dies ist nicht die im Video gezeigte 32K-Konfiguration. Für längere Kontexte benötigen Sie ein dafür gebautes Modell. Setzen Sie CTX_SIZE für den Server und SERVER_CONTEXT für die Oberfläche auf denselben unterstützten Wert. Auch der von start_model_server.sh erwartete Modellname muss zu Ihrem Modellpaket passen.
Zeiten und Suchergebnisse im Video sind Ergebnisse dieses einzelnen Durchlaufs. Sie hängen von Board, Modell, Laufzeit, Kontextlänge und Eingabe ab.
Quelle und Grenzen
Modelldateien und eine kompatible Laufzeit auf dem Board müssen separat vorbereitet werden. Die Weboberfläche ist für ein vertrauenswürdiges lokales Netzwerk vorgesehen. Prüfen Sie die Zugriffskontrolle vor einer Freigabe außerhalb dieses Netzwerks.