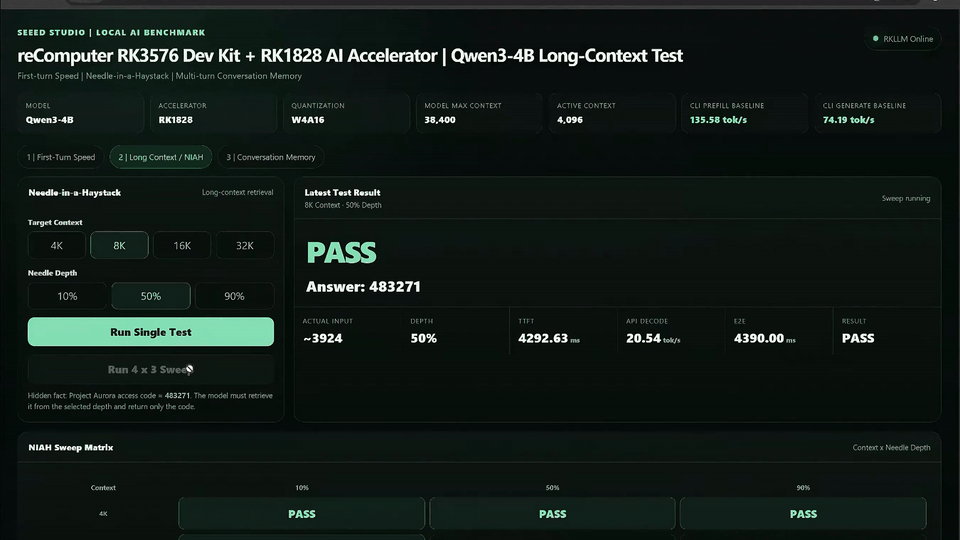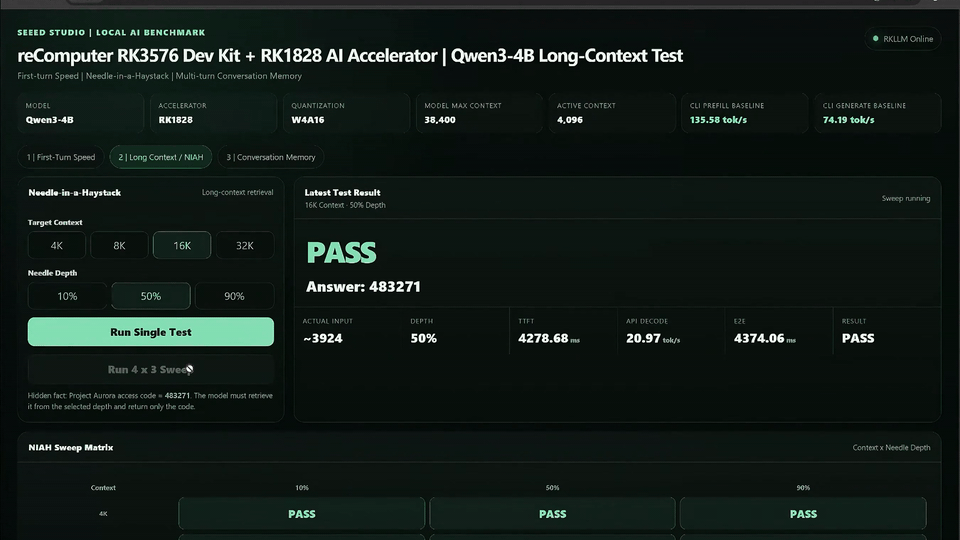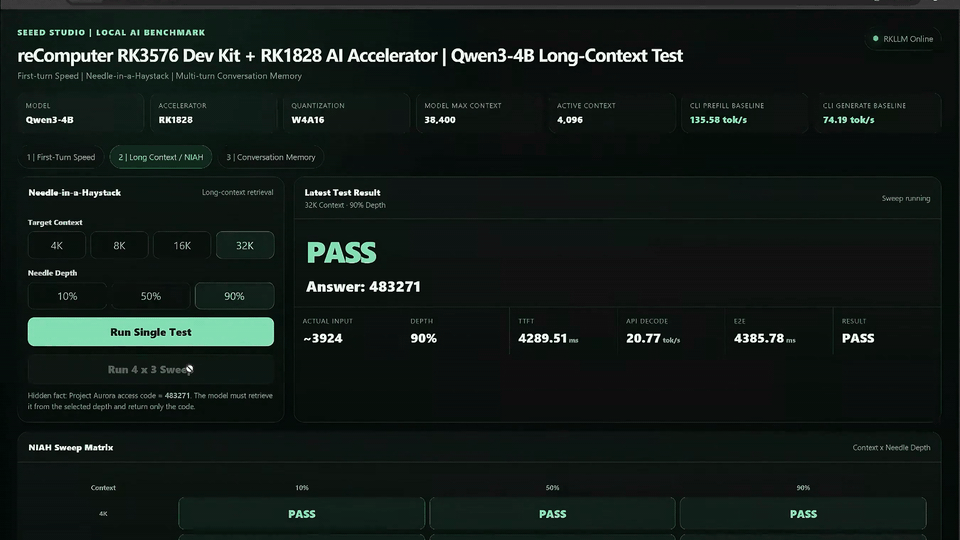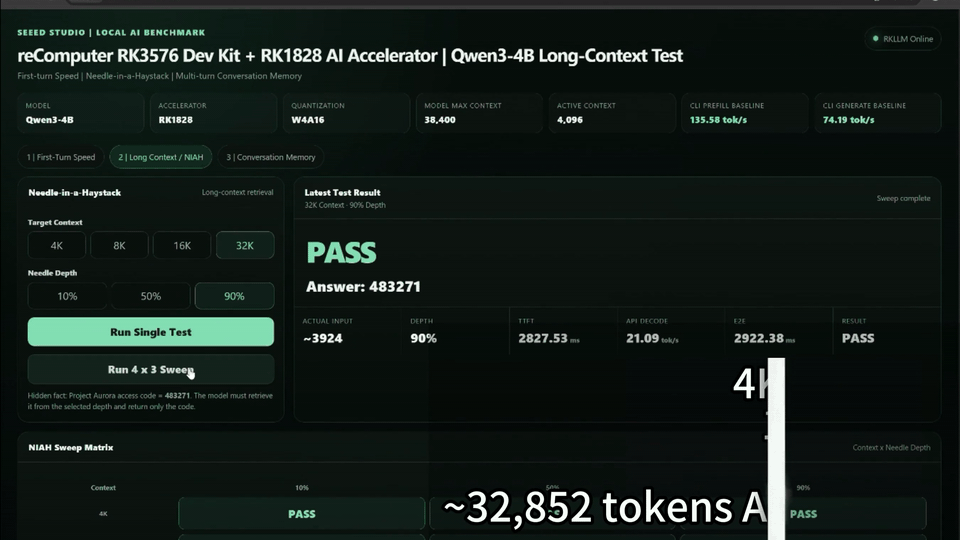
Dit project draait Qwen3-4B lokaal op een reComputer RK3576 met één RK1828-versneller. De browserinterface combineert drie tests: de eerste respons, het terugvinden van een verborgen gegeven in lange tekst (needle-in-a-haystack) en geheugen over meerdere gespreksbeurten. De modelserver en testinterface draaien op het apparaat; tijdens de tests is geen cloudmodel-API nodig.
Wat de tests laten zien
| Test | Doel |
|---|---|
| Eerste respons | De responstijd bij een nieuwe vraag met een lege KV-cache. |
| Needle-in-a-haystack | Of het model een verborgen gegeven op verschillende posities in een lange tekst terugvindt. |
| Gespreksgeheugen | Of het model eerder gegeven informatie onthoudt na veel niet-gerelateerde gespreksbeurten. |
De interface toont streamingmetingen op applicatieniveau. Die zijn niet direct vergelijkbaar met resultaten van een RKNN3- of RKLLM-benchmark op de opdrachtregel.
Hardware en omgeving
- reComputer RK3576 met een geïnstalleerde en herkende RK1828-module.
- Compatibele RKNN3/RKLLM-runtime met
rkllm3-serverbeschikbaar op het apparaat. - Python 3 en
venvvoor de FastAPI-testinterface; de afhankelijkheden staan in derequirements.txtvan het project. - Een apart verkregen Qwen3-4B-modelpakket voor RK1828. Het losse projectarchief bevat geen modelbinaries.
Het startscript verwacht Qwen3-4B.rknn, Qwen3-4B.weight, Qwen3-4B.tokenizer.gguf en Qwen3-4B.embed.bin in MODEL_DIR. Controleer vóór het starten of de bestanden bij de geïnstalleerde runtime passen.
Het project uitvoeren
Kloon de repository en ga naar de projectmap:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1828-4b-benchmark
chmod +x *.sh
./check_env.sh
Start de modelserver in de eerste terminal met de werkelijke locatie van het model:
MODEL_DIR=/path/to/Qwen3-4B ./start_model_server.shLaat die terminal draaien. Start in een tweede terminal vanuit dezelfde projectmap de browserinterface:
./start_ui.shOpen http://<RK3576-IP>:7862 in een browser op hetzelfde netwerk. De interface verbindt standaard met de lokale modelserver op http://127.0.0.1:8080.
Over de 32K-demo op de cover
De cover-GIF komt uit een opgenomen RK1828 / Qwen3-4B test met lange context. De startscripts van de repository gebruiken standaard een actieve context van 4.096 tokens; dat is niet de 32K-configuratie in de video. Voor een langere context is een daarvoor geschikt model nodig. Stel CTX_SIZE voor de server en SERVER_CONTEXT voor de interface in op dezelfde ondersteunde waarde. De modelbestandsnaam die start_model_server.sh verwacht, moet ook overeenkomen met uw modelpakket.
De tijden en zoekresultaten in de video horen bij die ene uitvoering. Ze kunnen verschillen per apparaat, model, runtime, contextlengte en invoer.
Bron en beperkingen
De modelbestanden en een compatibele runtime op het apparaat moeten apart worden voorbereid. De webinterface is bedoeld voor een vertrouwd lokaal netwerk. Controleer de toegangsbeveiliging voordat u deze buiten dat netwerk beschikbaar maakt.