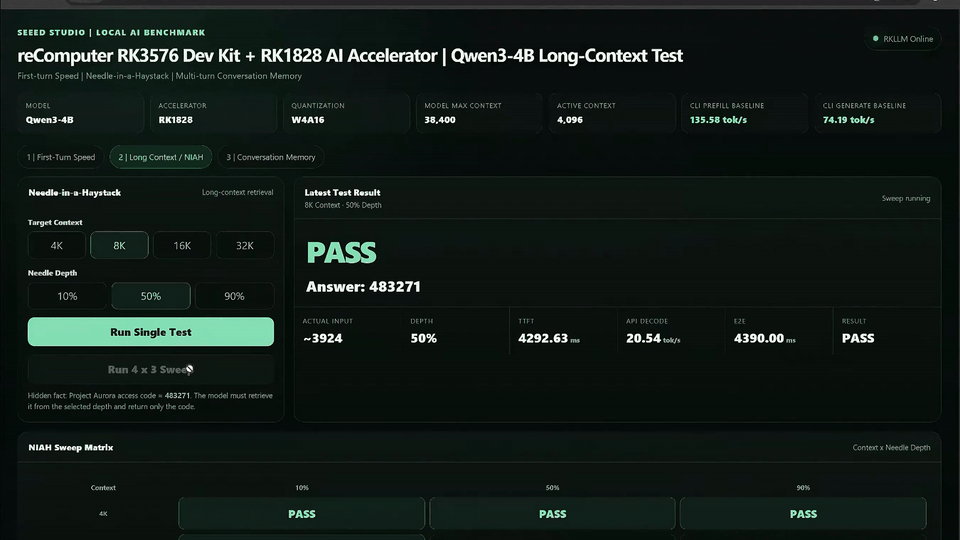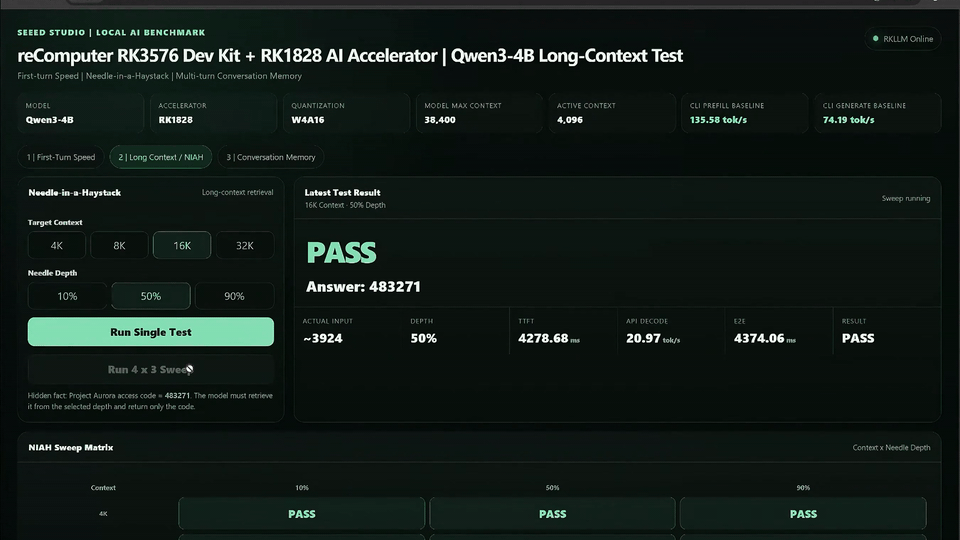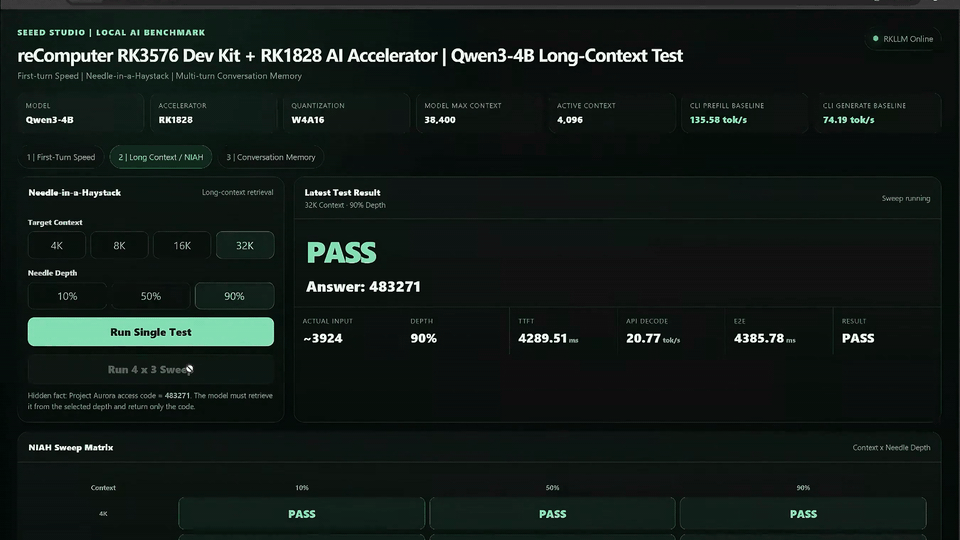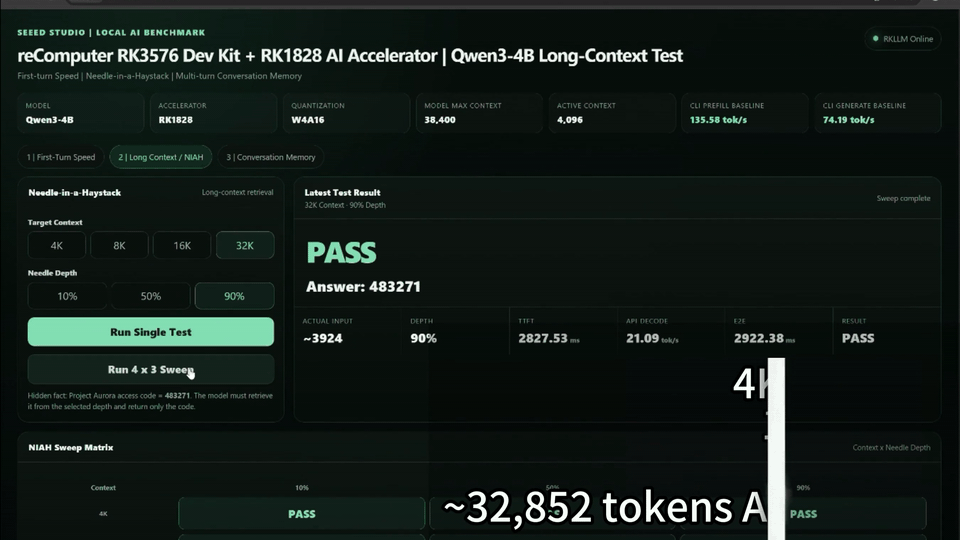
Este proyecto ejecuta Qwen3-4B localmente en un reComputer RK3576 con un acelerador RK1828. Su interfaz web reúne tres pruebas: primera respuesta, búsqueda de una información oculta en un texto largo (needle-in-a-haystack) y memoria en conversaciones de varios turnos. El servidor del modelo y la interfaz se ejecutan en la placa, sin recurrir a una API de modelos en la nube durante las pruebas.
Qué comprueba
| Prueba | Objetivo |
|---|---|
| Primera respuesta | Medir el tiempo de respuesta a una nueva pregunta con la caché KV vacía. |
| Needle-in-a-haystack | Comprobar si el modelo recupera un dato oculto en distintas posiciones de un texto largo. |
| Memoria conversacional | Comprobar si recuerda un dato anterior después de muchos turnos sobre otros temas. |
La interfaz muestra medidas de transmisión a nivel de aplicación. No son equivalentes a las cifras de una prueba de línea de comandos de RKNN3 o RKLLM.
Hardware y entorno
- reComputer RK3576 con un módulo RK1828 instalado y reconocido.
- Runtime RKNN3/RKLLM compatible y
rkllm3-serverdisponible en la placa. - Python 3 y
venvpara la interfaz FastAPI; las dependencias figuran enrequirements.txtdel proyecto. - Un paquete del modelo Qwen3-4B para RK1828 obtenido por separado. El archivo independiente del proyecto no incluye los binarios del modelo.
El script del servidor espera Qwen3-4B.rknn, Qwen3-4B.weight, Qwen3-4B.tokenizer.gguf y Qwen3-4B.embed.bin dentro de MODEL_DIR. Compruebe que sean compatibles con el runtime instalado.
Ejecución
Clone el repositorio y entre en el directorio del proyecto:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1828-4b-benchmark
chmod +x *.sh
./check_env.sh
En un primer terminal, indique la ruta real del modelo e inicie el servidor:
MODEL_DIR=/path/to/Qwen3-4B ./start_model_server.shDéjelo en ejecución. En un segundo terminal, desde el mismo directorio, inicie la interfaz:
./start_ui.shAbra http://<RK3576-IP>:7862 desde un navegador de la misma red. De forma predeterminada, la interfaz se conecta al servidor local en http://127.0.0.1:8080.
Sobre la demostración de 32K
El GIF de portada procede de una prueba grabada de contexto largo con RK1828 y Qwen3-4B. Los scripts del repositorio inician por defecto un contexto activo de 4.096 tokens, distinto de la configuración de 32K mostrada en el vídeo. Para probar un contexto mayor, se necesita un modelo compatible y los mismos valores admitidos en CTX_SIZE del servidor y SERVER_CONTEXT de la interfaz. El nombre de archivo esperado por start_model_server.sh también debe coincidir con el paquete utilizado.
Los tiempos y resultados de recuperación del vídeo corresponden a esa ejecución concreta. Pueden variar según la placa, el modelo, el runtime, la longitud de contexto y la entrada.
Código y límites
Hay que preparar por separado los archivos del modelo y un runtime compatible. La interfaz web está pensada para una red local de confianza; revise el control de acceso antes de exponerla a otras redes.