Un système d'estimation de pose humaine 3D basé sur RK3576 / RKNN / YOLO / Pose Estimation
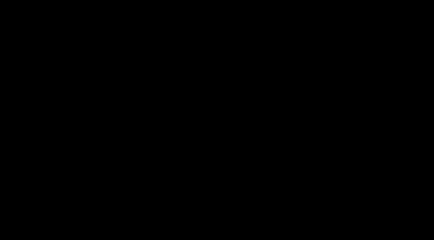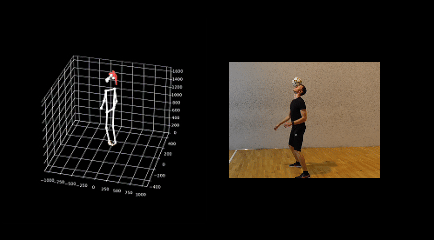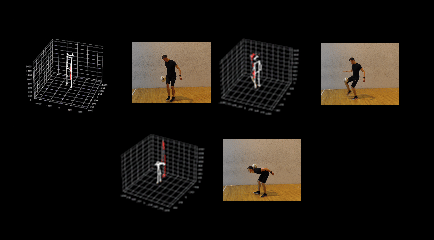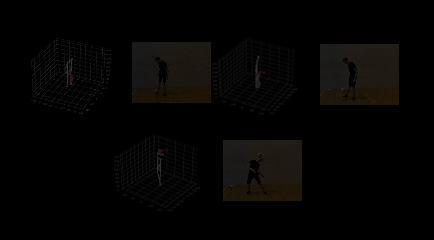
Vous pouvez consulter le projet sur GitHub : https://github.com/doublelf/3D-Human-Pose-Estimation/tree/main
Un pipeline de détection d'objets YOLOv8 + estimation de pose, optimisé pour le reComputer RK3576. Ce projet repose sur les algorithmes de base de la plateforme reComputer AI Lab, en remplaçant le backend d'inférence et la logique d'ordonnancement d'origine afin de distribuer les calculs sur les unités de calcul hétérogènes du RK3576 :
| Unité de calcul | Tâche |
|---|---|
| NPU 0+1 | Détection d'objets YOLOv8n à 80 classes (fichier de modèle yolov8n.rknn) |
| NPU 2 | Estimation de pose YOLOv8n-pose à 17 points clés (fichier de modèle yolov8n_pose.rknn) |
| VPU | Codec matériel H.264 via ffmpeg h264_rkmpp |
| CPU | Prétraitement Letterbox, post-traitement DFL/NMS et rendu des images |
Structure du dépôt
ceshi_rk3576/
├── README.md
├── pyproject.toml
├── requirements.txt
├── Dockerfile
├── configs/
│   └── default.yaml
├── data/
│   ├── inputs/                # Sources vidéo d'entrée
│   ├── outputs/               # Répertoire de sortie des résultats
│   └── weights/               # Poids des modèles : yolov8n.rknn, yolov8n_pose.rknn
├── src/poseball/
│   ├── __init__.py
│   ├── __main__.py
│   ├── cli.py                 # Point d'entrée en ligne de commande
│   ├── config.py              # Gestion de configuration basée sur YAML
│   ├── rknn_engine.py         # Wrapper d'inférence NPU
│   ├── vpu_codec.py           # Codec VPU via sous-processus ffmpeg
│   ├── models.py              # Chargeur de modèles pratique
│   ├── preprocess.py          # Traitement Letterbox + conversion BGR vers RGB
│   ├── postprocess.py         # DFL/NMS + restauration des coordonnées Letterbox
│   ├── video.py               # Module de lecture/écriture vidéo VPU / cv2
│   ├── hw_scheduler.py        # Ordonnanceur de pipeline multithread (CPU/NPU/VPU)
│   ├── pipeline.py            # Orchestration métier de haut niveau
│   ├── geometry.py            # Classes de données Point / Rect / Detection
│   ├── io_utils.py            # Utilitaires JSON et système de fichiers
│   └── _compat.py             # Couche d'adaptation de compatibilité NumPy
├── src/py_utils/
│   ├── __init__.py
│   ├── yolov8_utils.py        # Post-traitement de détection d'objets (issu du projet ballo)
│   └── pose_utils.py          # Post-traitement d'estimation de pose (issu du projet ball)
└── tests/
    ├── test_rknn_engine.py
    ├── test_vpu_codec.py
    ├── test_postprocess.py
    └── test_hw_scheduler.py
Installation sur le reComputer RK3576
Option 1 : Installation depuis GitHub
Obtenir le projet
git clone https://github.com/doublelf/3D-Human-Pose-Estimation.git && cd 3D-Human-Pose-EstimationConfigurer l'environnement
# 1. Créer un environnement virtuel
python3 -m venv venv
source venv/bin/activate

# 2. Installer le paquet et les dépendances requises
pip install -e .
pip install -r requirements.txt

# 3. Installer rknn-toolkit-lite2 pour la version de Python correspondante (aarch64 uniquement)
cd RKNN-Toolkit/
pip3 install rknn_toolkit_lite2-2.3.2-cp311-cp311-manylinux_2_17_aarch64.manylinux2014_aarch64.whl
Utilisation
# Exécuter un diagnostic matériel complet (recommandé lors de la première utilisation d'un nouvel appareil)
ceshi_rk3576 doctor

# Afficher les capacités matérielles détectées
ceshi_rk3576 info

# Smoke test sur une seule image
ceshi_rk3576 smoke --input data/inputs/sample.mp4

# Pipeline de bout en bout avec une seule caméra (détection d'objets + estimation de pose + détection de ballon)
ceshi_rk3576 infer \
    --config configs/default.yaml \
    --input  data/inputs/sample.mp4 \
    --output data/outputs/annotated.mp4 \
    --json   data/outputs/detections.json

# Pipeline à double caméra (commande de test principale)
ceshi_rk3576 dual-infer \
    --input-a  data/inputs/sample-a.mp4 \
    --input-b  data/inputs/sample-b.mp4 \
    --output-a data/outputs/annotated-a.mp4 \
    --output-b data/outputs/annotated-b.mp4 \
    --json-a   data/outputs/detections-a.json \
    --json-b   data/outputs/detections-b.json

# Générer un MP4 d'animation pseudo-3D avec matplotlib à partir des résultats JSON
ceshi_rk3576 render \
    --json-a     data/outputs/detections-a.json \
    --output     data/outputs/3d.mp4 \
    --depth-mode lr
Option 2 : Installation avec Docker
Obtenir le projet + exécution en une seule commande
Récupérer l'image
sudo docker pull ghcr.io/doublelf/3d_human_pose_estimation:v1.0Exécuter le pipeline à double caméra
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 dual-infer --input-a  data/inputs/sample-a.mp4 --input-b  data/inputs/sample-b.mp4 --output-a data/outputs/annotated-a.mp4 --output-b data/outputs/annotated-b.mp4 --json-a   data/outputs/detections-a.json --json-b   data/outputs/detections-b.json
Générer un MP4 d'animation pseudo-3D avec matplotlib à partir des résultats JSON
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 render --json-a data/outputs/detections-a.json --output data/outputs/3d.mp4 --depth-mode lr
Description des fichiers de sortie
| Fichier | Contenu |
|---|---|
annotated*.mp4 | Image originale + boîtes englobantes + squelette à 17 points-clés + cercle rouge pour le ballon de sport (classe COCO 32) |
detections*.json | Données par image : detections (les 80 classes COCO), poses (bbox + 17 points-clés avec confiance), ball_xy (centre de la meilleure bbox du ballon) |
3d.mp4 | Squelette pseudo-3D rendu avec matplotlib + trajectoire du ballon + trajectoires des chevilles gauche et droite, avec rotation à chaque image (depth_mode=lr) ; ne rend que les données de la caméra A |
La commande render lit les fichiers JSON produits par infer ou dual-infer — les deux étapes sont indépendantes. Vous pouvez relancer render pour ajuster la taille de sortie, la fréquence d'images ou le mode de profondeur sans avoir à retraiter la vidéo sur la NPU.
Répartition des tâches matérielles
Topologie NPU du RK3576
Le SoC RK3576 ne dispose que de deux cœurs NPU (cœur 0 et cœur 1). Nous épinglons chaque modèle sur un cœur distinct afin qu'ils puissent s'exécuter en parallèle sans se disputer les mêmes ressources matérielles :
| Modèle | core_mask par défaut | Cœur physique |
|---|---|---|
| Détecteur YOLOv8n | NPU_CORE_0 (0x01) | Cœur 0 |
| Modèle de pose YOLOv8n | NPU_CORE_1 (0x02) | Cœur 1 |
L'ancienne configuration par défaut (détecteur sur NPU_CORE_0_1 et modèle de pose sur NPU_CORE_2) était erronée : le pilote RKNN remappe silencieusement NPU_CORE_2 vers NPU_CORE_0 et émet un avertissement au chargement. Avec cette configuration, les deux modèles se disputeraient les ressources des cœurs 0+1.