基于 RK3576 / RKNN / YOLO / Pose Estimation 的三维人体姿态构建系统
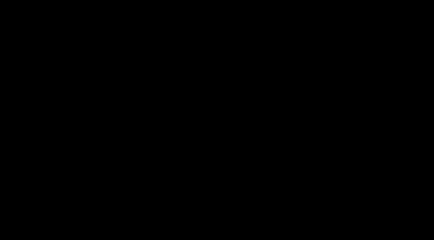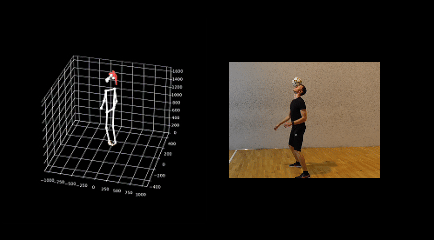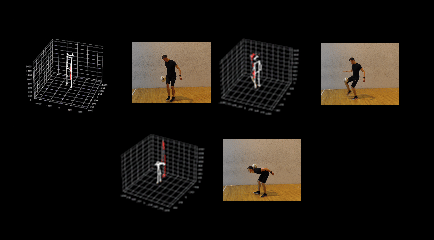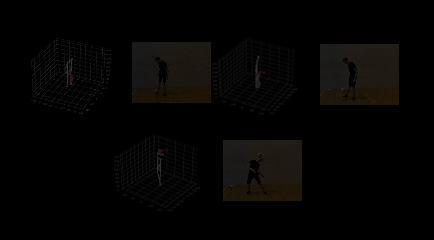
你可以从github上查看该项目: https://github.com/doublelf/3D-Human-Pose-Estimation/tree/main
针对 reComputer RK3576 优化的 YOLOv8 目标检测 + 姿态估计流水线。本项目基于reComputer AI Lab平台算法作为基础开发,替换了原有的推理后端与调度逻辑,将计算任务分配到 RK3576 的异构计算单元上:
| 计算单元 | 承担任务 |
|---|---|
| NPU 0+1 | YOLOv8n 80类目标检测(模型文件 yolov8n.rknn) |
| NPU 2 | YOLOv8n-pose 17关键点姿态估计(模型文件 yolov8n_pose.rknn) |
| VPU | 通过 ffmpeg h264_rkmpp 实现 H.264 硬件编解码 |
| CPU | Letterbox 预处理、DFL/NMS 后处理、画面渲染 |
仓库目录结构
Code
ceshi_rk3576/
├── README.md
├── pyproject.toml
├── requirements.txt
├── Dockerfile
├── configs/
│   └── default.yaml
├── data/
│   ├── inputs/                # 输入视频源
│   ├── outputs/                # 结果保存位置
│   └── weights/               # 存放 yolov8n.rknn、yolov8n_pose.rknn 模型权重
├── src/poseball/
│   ├── __init__.py
│   ├── __main__.py
│   ├── cli.py                 # 命令行入口
│   ├── config.py              # 基于 YAML 的配置管理
│   ├── rknn_engine.py         # NPU 推理封装
│   ├── vpu_codec.py           # 通过 ffmpeg 子进程实现 VPU 编解码
│   ├── models.py              # 便捷模型加载器
│   ├── preprocess.py          # Letterbox 处理 + BGR 转 RGB
│   ├── postprocess.py         # DFL/NMS + Letterbox 坐标还原
│   ├── video.py               # VPU / cv2 视频读写模块
│   ├── hw_scheduler.py        # 多线程流水线调度(CPU/NPU/VPU)
│   ├── pipeline.py            # 高层业务编排
│   ├── geometry.py            # Point / Rect / Detection 数据类定义
│   ├── io_utils.py            # JSON 与文件系统工具
│   └── _compat.py             # numpy 兼容性适配层
├── src/py_utils/
│   ├── __init__.py
│   ├── yolov8_utils.py        # 目标检测后处理(源自 `ballo` 项目)
│   └── pose_utils.py          # 姿态估计后处理(源自 `ball` 项目)
└── tests/
    ├── test_rknn_engine.py
    ├── test_vpu_codec.py
    ├── test_postprocess.py
    └── test_hw_scheduler.py
在 reComputer RK3576 上安装
方案一:从gihtub进行安装
获取项目
bash
git clone https://github.com/doublelf/3D-Human-Pose-Estimation.git && cd 3D-Human-Pose-Estimation进行环境配置
bash
# 1. 创建虚拟环境
python3 -m venv venv
source venv/bin/activate

# 2. 安装本项目包及所需环境
pip install -e .
pip install -r requirements.txt

# 3. 安装对应 Python 版本的 rknn-toolkit-lite2(仅支持 aarch64 架构)
cd RKNN-Toolkit/
pip3 install rknn_toolkit_lite2-2.3.2-cp311-cp311-manylinux_2_17_aarch64.manylinux2014_aarch64.whl
运行方式
bash
# 运行完整硬件诊断(新设备首次使用建议执行)
ceshi_rk3576 doctor

# 打印检测到的硬件能力信息
ceshi_rk3576 info

# 单帧功能冒烟测试
ceshi_rk3576 smoke --input data/inputs/sample.mp4

# 单摄像头端到端流水线(目标检测 + 姿态估计 + 球类检测)
ceshi_rk3576 infer \
    --config configs/default.yaml \
    --input  data/inputs/sample.mp4 \
    --output data/outputs/annotated.mp4 \
    --json   data/outputs/detections.json

# 双摄像头流水线(主测试使用指令)
ceshi_rk3576 dual-infer \
    --input-a  data/inputs/sample-a.mp4 \
    --input-b  data/inputs/sample-b.mp4 \
    --output-a data/outputs/annotated-a.mp4 \
    --output-b data/outputs/annotated-b.mp4 \
    --json-a   data/outputs/detections-a.json \
    --json-b   data/outputs/detections-b.json

# 基于 JSON 结果生成 matplotlib 伪3D 动画 MP4
ceshi_rk3576 render \
    --json-a     data/outputs/detections-a.json \
    --output     data/outputs/3d.mp4 \
    --depth-mode lr
方案二:使用docker安装
获取项目 + 一键运行
拉取镜像
bash
sudo docker pull ghcr.io/doublelf/3d_human_pose_estimation:v1.0运行双摄像头流水线
bash
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 dual-infer --input-a  data/inputs/sample-a.mp4 --input-b  data/inputs/sample-b.mp4 --output-a data/outputs/annotated-a.mp4 --output-b data/outputs/annotated-b.mp4 --json-a   data/outputs/detections-a.json --json-b   data/outputs/detections-b.json
基于 JSON 结果生成 matplotlib 伪3D 动画 MP4
bash
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 render --json-a data/outputs/detections-a.json --output data/outputs/3d.mp4 --depth-mode lr
输出文件说明
| 文件 | 内容说明 |
|---|---|
annotated*.mp4 | 原始画面 + 检测框 + 17关键点骨骼 + 运动球类标记红圈(对应 COCO 第32类) |
detections*.json | 逐帧数据:全部80类 COCO 检测结果 detections、带置信度的检测框+17关键点 poses、最优球类检测框中心点 ball_xy |
3d.mp4 | matplotlib 渲染的伪3D骨骼 + 球体轨迹 + 左右脚踝轨迹,逐帧旋转(depth_mode=lr);仅渲染摄像头 A 的数据 |
render 命令读取 infer 或 dual-infer 生成的 JSON 文件,两个阶段相互独立。你可以直接重新运行 render 来调整输出尺寸、帧率或深度模式,无需重新在 NPU 上处理视频。
硬件任务分配
RK3576 NPU 拓扑结构
RK3576 片上系统仅配备 2个 NPU 核心(核心 0 与核心 1)。我们将两个模型分别绑定到不同的核心上,使二者可以并行运行,避免硬件资源争抢:
| 模型 | 默认 core_mask 配置 | 物理核心 |
|---|---|---|
| YOLOv8n 检测器 | NPU_CORE_0 (0x01) | 核心 0 |
| YOLOv8n 姿态模型 | NPU_CORE_1 (0x02) | 核心 1 |
此前的默认配置(检测器使用 NPU_CORE_0_1、姿态模型使用 NPU_CORE_2)存在错误:RKNN 驱动会在加载时静默将 NPU_CORE_2 重映射为 NPU_CORE_0 并输出警告,该配置会导致两个模型争抢核心 0+1 的资源。