Ein 3D-Mensch-Pose-Schätzungssystem basierend auf RK3576 / RKNN / YOLO / Pose Estimation
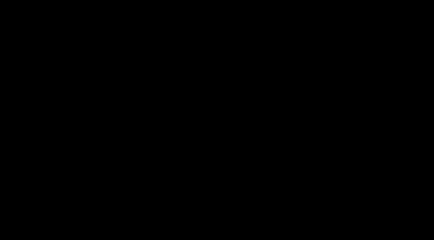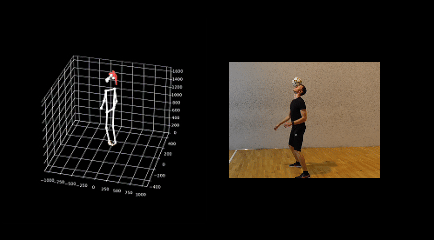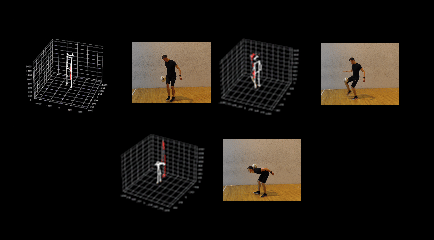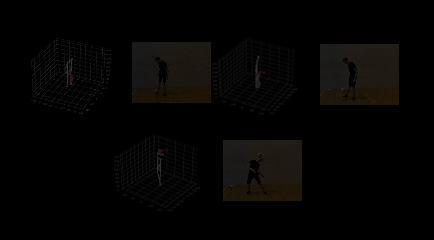
Sie können das Projekt auf GitHub einsehen: https://github.com/doublelf/3D-Human-Pose-Estimation/tree/main
Eine YOLOv8-Objekterkennung- + Pose-Schätzung-Pipeline, optimiert für den reComputer RK3576. Dieses Projekt basiert auf den Basis-Algorithmen der reComputer-AI-Lab-Plattform und ersetzt die ursprüngliche Inferenz-Backend- und Scheduling-Logik, um die Rechenaufgaben auf die heterogenen Recheneinheiten des RK3576 zu verteilen:
| Recheneinheit | Aufgabe |
|---|---|
| NPU 0+1 | YOLOv8n-Objekterkennung mit 80 Klassen (Modelldatei yolov8n.rknn) |
| NPU 2 | YOLOv8n-pose-Pose-Schätzung mit 17 Keypoints (Modelldatei yolov8n_pose.rknn) |
| VPU | H.264-Hardware-Codec über ffmpeg h264_rkmpp |
| CPU | Letterbox-Vorverarbeitung, DFL/NMS-Nachbearbeitung und Frame-Rendering |
Repository-Aufbau
ceshi_rk3576/
├── README.md
├── pyproject.toml
├── requirements.txt
├── Dockerfile
├── configs/
│   └── default.yaml
├── data/
│   ├── inputs/                # Eingabevideoquellen
│   ├── outputs/               # Ausgabeverzeichnis für Ergebnisse
│   └── weights/               # Modellgewichte: yolov8n.rknn, yolov8n_pose.rknn
├── src/poseball/
│   ├── __init__.py
│   ├── __main__.py
│   ├── cli.py                 # Kommandozeilen-Einstiegspunkt
│   ├── config.py              # YAML-basierte Konfigurationsverwaltung
│   ├── rknn_engine.py         # NPU-Inferenz-Wrapper
│   ├── vpu_codec.py           # VPU-Codec über ffmpeg-Subprozess
│   ├── models.py              # Bequemer Modelllader
│   ├── preprocess.py          # Letterbox-Verarbeitung + BGR-zu-RGB-Konvertierung
│   ├── postprocess.py         # DFL/NMS + Wiederherstellung der Letterbox-Koordinaten
│   ├── video.py               # VPU / cv2 Video-Lese-/Schreibmodul
│   ├── hw_scheduler.py        # Multithread-Pipeline-Scheduler (CPU/NPU/VPU)
│   ├── pipeline.py            # Hochwertige Geschäftsorchestrierung
│   ├── geometry.py            # Point / Rect / Detection Datenklassen
│   ├── io_utils.py            # JSON- und Dateisystem-Dienstprogramme
│   └── _compat.py             # NumPy-Kompatibilitätsadapter
├── src/py_utils/
│   ├── __init__.py
│   ├── yolov8_utils.py        # Nachbearbeitung der Objekterkennung (aus dem ballo-Projekt)
│   └── pose_utils.py          # Nachbearbeitung der Pose-Schätzung (aus dem ball-Projekt)
└── tests/
    ├── test_rknn_engine.py
    ├── test_vpu_codec.py
    ├── test_postprocess.py
    └── test_hw_scheduler.py
Installation auf dem reComputer RK3576
Option 1: Installation von GitHub
Projekt beziehen
git clone https://github.com/doublelf/3D-Human-Pose-Estimation.git && cd 3D-Human-Pose-EstimationUmgebung einrichten
# 1. Virtuelle Umgebung anlegen
python3 -m venv venv
source venv/bin/activate

# 2. Dieses Paket und die erforderlichen Abhängigkeiten installieren
pip install -e .
pip install -r requirements.txt

# 3. rknn-toolkit-lite2 für die passende Python-Version installieren (nur aarch64)
cd RKNN-Toolkit/
pip3 install rknn_toolkit_lite2-2.3.2-cp311-cp311-manylinux_2_17_aarch64.manylinux2014_aarch64.whl
Nutzung
# Vollständige Hardware-Diagnose ausführen (bei Erstnutzung eines neuen Geräts empfohlen)
ceshi_rk3576 doctor

# Erkannte Hardware-Fähigkeiten ausgeben
ceshi_rk3576 info

# Smoke-Test mit einem Einzelbild
ceshi_rk3576 smoke --input data/inputs/sample.mp4

# End-to-End-Pipeline mit einer Kamera (Objekterkennung + Pose-Schätzung + Ballerkennung)
ceshi_rk3576 infer \
    --config configs/default.yaml \
    --input  data/inputs/sample.mp4 \
    --output data/outputs/annotated.mp4 \
    --json   data/outputs/detections.json

# Dual-Kamera-Pipeline (Haupt-Testbefehl)
ceshi_rk3576 dual-infer \
    --input-a  data/inputs/sample-a.mp4 \
    --input-b  data/inputs/sample-b.mp4 \
    --output-a data/outputs/annotated-a.mp4 \
    --output-b data/outputs/annotated-b.mp4 \
    --json-a   data/outputs/detections-a.json \
    --json-b   data/outputs/detections-b.json

# Pseudo-3D-Animations-MP4 mit matplotlib aus den JSON-Ergebnissen erzeugen
ceshi_rk3576 render \
    --json-a     data/outputs/detections-a.json \
    --output     data/outputs/3d.mp4 \
    --depth-mode lr
Option 2: Installation mit Docker
Projekt beziehen + in einem Schritt ausführen
Image ziehen
sudo docker pull ghcr.io/doublelf/3d_human_pose_estimation:v1.0Dual-Kamera-Pipeline ausführen
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 dual-infer --input-a  data/inputs/sample-a.mp4 --input-b  data/inputs/sample-b.mp4 --output-a data/outputs/annotated-a.mp4 --output-b data/outputs/annotated-b.mp4 --json-a   data/outputs/detections-a.json --json-b   data/outputs/detections-b.json
Pseudo-3D-Animations-MP4 mit matplotlib aus den JSON-Ergebnissen erzeugen
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 render --json-a data/outputs/detections-a.json --output data/outputs/3d.mp4 --depth-mode lr
Beschreibung der Ausgabedateien
| Datei | Inhalt |
|---|---|
annotated*.mp4 | Originalbild + Bounding Boxes + Skelett mit 17 Keypoints + roter Kreis für den Sportball (COCO-Klasse 32) |
detections*.json | Pro-Frame-Daten: detections (alle 80 COCO-Klassen), poses (Bounding Box + 17 Keypoints mit Konfidenz), ball_xy (Mittelpunkt der besten Ball-Bounding Box) |
3d.mp4 | matplotlib-gerendertes Pseudo-3D-Skelett + Ball-Trajektorie + Trajektorien des linken und rechten Sprunggelenks, pro Frame rotierend (depth_mode=lr); rendert nur die Daten von Kamera A |
Der render-Befehl liest die von infer oder dual-infer erzeugten JSON-Dateien — die beiden Stufen sind unabhängig voneinander. Sie können render einfach erneut ausführen, um Ausgabegröße, Bildrate oder Tiefenmodus anzupassen, ohne das Video erneut auf der NPU verarbeiten zu müssen.
Hardware-Aufgabenverteilung
RK3576-NPU-Topologie
Das RK3576-SoC verfügt über nur zwei NPU-Kerne (Kern 0 und Kern 1). Wir binden die beiden Modelle an unterschiedliche Kerne, damit sie parallel laufen können, ohne um Hardware-Ressourcen zu konkurrieren:
| Modell | Standard core_mask-Konfiguration | Physischer Kern |
|---|---|---|
| YOLOv8n-Detektor | NPU_CORE_0 (0x01) | Kern 0 |
| YOLOv8n-Pose-Modell | NPU_CORE_1 (0x02) | Kern 1 |
Die vorherige Standardkonfiguration (Detektor mit NPU_CORE_0_1, Pose-Modell mit NPU_CORE_2) war fehlerhaft: Der RKNN-Treiber mappt NPU_CORE_2 beim Laden stillschweigend auf NPU_CORE_0 um und gibt eine Warnung aus. Diese Konfiguration würde dazu führen, dass beide Modelle um die Ressourcen von Kern 0+1 konkurrieren.