Un sistema de estimación de pose humana 3D basado en RK3576 / RKNN / YOLO / Pose Estimation
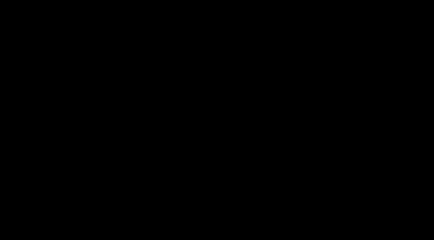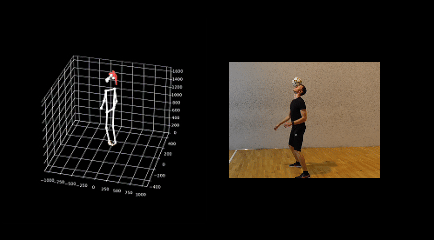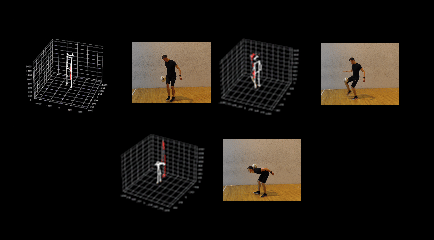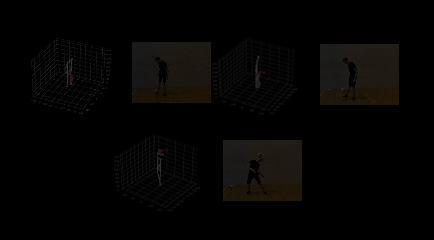
Puedes consultar el proyecto en GitHub: https://github.com/doublelf/3D-Human-Pose-Estimation/tree/main
Un pipeline de detección de objetos YOLOv8 + estimación de pose, optimizado para el reComputer RK3576. Este proyecto se basa en los algoritmos de la plataforma reComputer AI Lab como base, reemplazando el backend de inferencia y la lógica de planificación originales para distribuir las tareas de cómputo entre las unidades de cálculo heterogéneas del RK3576:
| Unidad de cómputo | Tarea |
|---|---|
| NPU 0+1 | Detección de objetos YOLOv8n con 80 clases (archivo de modelo yolov8n.rknn) |
| NPU 2 | Estimación de pose YOLOv8n-pose con 17 puntos clave (archivo de modelo yolov8n_pose.rknn) |
| VPU | Códec H.264 por hardware mediante ffmpeg h264_rkmpp |
| CPU | Preprocesamiento Letterbox, postprocesamiento DFL/NMS y renderizado de fotogramas |
Estructura del repositorio
ceshi_rk3576/
├── README.md
├── pyproject.toml
├── requirements.txt
├── Dockerfile
├── configs/
│   └── default.yaml
├── data/
│   ├── inputs/                # Fuentes de vídeo de entrada
│   ├── outputs/               # Directorio de salida para los resultados
│   └── weights/               # Pesos del modelo: yolov8n.rknn, yolov8n_pose.rknn
├── src/poseball/
│   ├── __init__.py
│   ├── __main__.py
│   ├── cli.py                 # Punto de entrada de línea de comandos
│   ├── config.py              # Gestión de configuración basada en YAML
│   ├── rknn_engine.py         # Wrapper de inferencia NPU
│   ├── vpu_codec.py           # Códec VPU mediante subproceso ffmpeg
│   ├── models.py              # Cargador de modelos práctico
│   ├── preprocess.py          # Procesado Letterbox + conversión de BGR a RGB
│   ├── postprocess.py         # DFL/NMS + restauración de coordenadas Letterbox
│   ├── video.py               # Módulo de lectura/escritura de vídeo VPU / cv2
│   ├── hw_scheduler.py        # Planificador de pipeline multihilo (CPU/NPU/VPU)
│   ├── pipeline.py            # Orquestación de la lógica de negocio de alto nivel
│   ├── geometry.py            # Clases de datos Point / Rect / Detection
│   ├── io_utils.py            # Utilidades JSON y de sistema de archivos
│   └── _compat.py             # Adaptador de compatibilidad NumPy
├── src/py_utils/
│   ├── __init__.py
│   ├── yolov8_utils.py        # Postprocesado de detección de objetos (del proyecto ballo)
│   └── pose_utils.py          # Postprocesado de estimación de pose (del proyecto ball)
└── tests/
    ├── test_rknn_engine.py
    ├── test_vpu_codec.py
    ├── test_postprocess.py
    └── test_hw_scheduler.py
Instalación en el reComputer RK3576
Opción 1: Instalar desde GitHub
Obtener el proyecto
git clone https://github.com/doublelf/3D-Human-Pose-Estimation.git && cd 3D-Human-Pose-EstimationConfigurar el entorno
# 1. Crear un entorno virtual
python3 -m venv venv
source venv/bin/activate

# 2. Instalar este paquete y las dependencias necesarias
pip install -e .
pip install -r requirements.txt

# 3. Instalar rknn-toolkit-lite2 para la versión de Python correspondiente (solo aarch64)
cd RKNN-Toolkit/
pip3 install rknn_toolkit_lite2-2.3.2-cp311-cp311-manylinux_2_17_aarch64.manylinux2014_aarch64.whl
Uso
# Ejecutar un diagnóstico completo del hardware (recomendado en el primer uso de un dispositivo nuevo)
ceshi_rk3576 doctor

# Imprimir las capacidades de hardware detectadas
ceshi_rk3576 info

# Smoke test de un solo fotograma
ceshi_rk3576 smoke --input data/inputs/sample.mp4

# Pipeline de extremo a extremo con una sola cámara (detección de objetos + estimación de pose + detección de balón)
ceshi_rk3576 infer \
    --config configs/default.yaml \
    --input  data/inputs/sample.mp4 \
    --output data/outputs/annotated.mp4 \
    --json   data/outputs/detections.json

# Pipeline con doble cámara (comando principal de prueba)
ceshi_rk3576 dual-infer \
    --input-a  data/inputs/sample-a.mp4 \
    --input-b  data/inputs/sample-b.mp4 \
    --output-a data/outputs/annotated-a.mp4 \
    --output-b data/outputs/annotated-b.mp4 \
    --json-a   data/outputs/detections-a.json \
    --json-b   data/outputs/detections-b.json

# Generar un MP4 de animación pseudo-3D con matplotlib a partir de los resultados JSON
ceshi_rk3576 render \
    --json-a     data/outputs/detections-a.json \
    --output     data/outputs/3d.mp4 \
    --depth-mode lr
Opción 2: Instalar con Docker
Obtener el proyecto + ejecución con un solo comando
Descargar la imagen
sudo docker pull ghcr.io/doublelf/3d_human_pose_estimation:v1.0Ejecutar el pipeline con doble cámara
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 dual-infer --input-a  data/inputs/sample-a.mp4 --input-b  data/inputs/sample-b.mp4 --output-a data/outputs/annotated-a.mp4 --output-b data/outputs/annotated-b.mp4 --json-a   data/outputs/detections-a.json --json-b   data/outputs/detections-b.json
Generar un MP4 de animación pseudo-3D con matplotlib a partir de los resultados JSON
sudo docker run --rm --privileged --net=host   -e PYTHONUNBUFFERED=1 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/data/inputs:/app/data/inputs \
  -v $(pwd)/data/weights:/app/data/weights \
  -v $(pwd)/data/outputs:/app/data/outputs \
  -v $(pwd)/configs:/app/configs \
  ghcr.io/doublelf/3d_human_pose_estimation:v1.0 \
  ceshi_rk3576 render --json-a data/outputs/detections-a.json --output data/outputs/3d.mp4 --depth-mode lr
Descripción de los archivos de salida
| Archivo | Contenido |
|---|---|
annotated*.mp4 | Fotograma original + bounding boxes + esqueleto de 17 puntos clave + círculo rojo para el balón deportivo (clase 32 de COCO) |
detections*.json | Datos por fotograma: detections (las 80 clases de COCO), poses (bbox + 17 puntos clave con confianza), ball_xy (centro de la mejor bbox del balón) |
3d.mp4 | Esqueleto pseudo-3D renderizado con matplotlib + trayectoria del balón + trayectorias de los tobillos izquierdo y derecho, con rotación por fotograma (depth_mode=lr); solo se renderizan los datos de la cámara A |
El comando render lee los archivos JSON generados por infer o dual-infer, por lo que las dos etapas son independientes. Puedes volver a ejecutar render para ajustar el tamaño de salida, la velocidad de fotogramas o el modo de profundidad sin necesidad de reprocesar el vídeo en la NPU.
Distribución de tareas del hardware
Topología de la NPU del RK3576
El SoC RK3576 dispone de solo dos núcleos NPU (núcleo 0 y núcleo 1). Vinculamos cada modelo a un núcleo distinto para que puedan ejecutarse en paralelo sin competir por los mismos recursos de hardware:
| Modelo | Configuración core_mask por defecto | Núcleo físico |
|---|---|---|
| Detector YOLOv8n | NPU_CORE_0 (0x01) | Núcleo 0 |
| Modelo de pose YOLOv8n | NPU_CORE_1 (0x02) | Núcleo 1 |
La configuración predeterminada anterior (detector con NPU_CORE_0_1 y modelo de pose con NPU_CORE_2) era incorrecta: el controlador RKNN reasigna NPU_CORE_2 a NPU_CORE_0 de forma silenciosa y emite una advertencia al cargar. Esa configuración provocaría que ambos modelos compitieran por los recursos de los núcleos 0+1.