Un proyecto de detección de caídas basado en RK3576 / RKNN / YOLO / RGA.
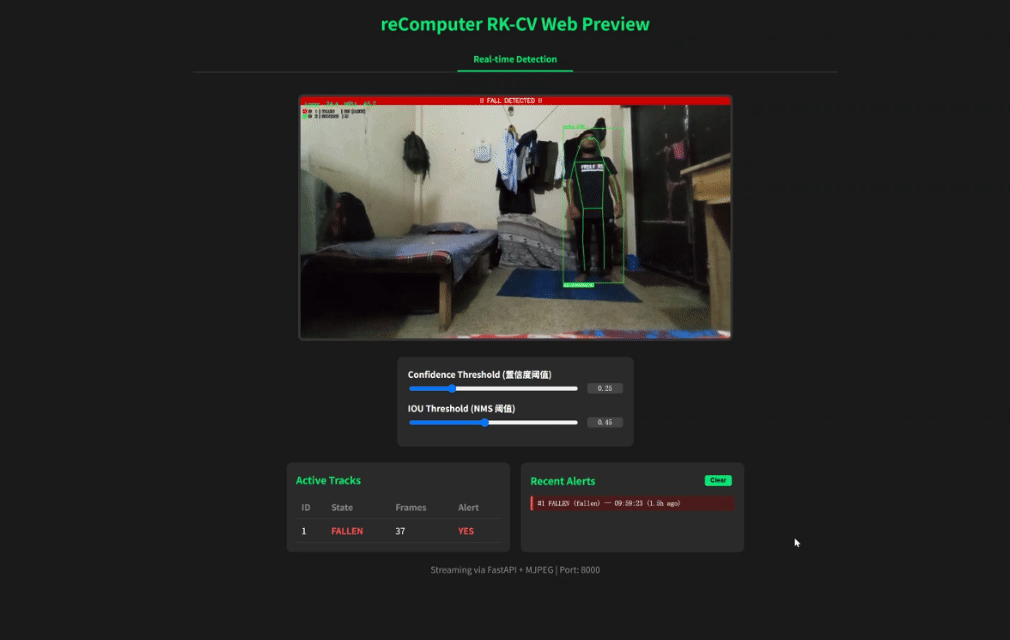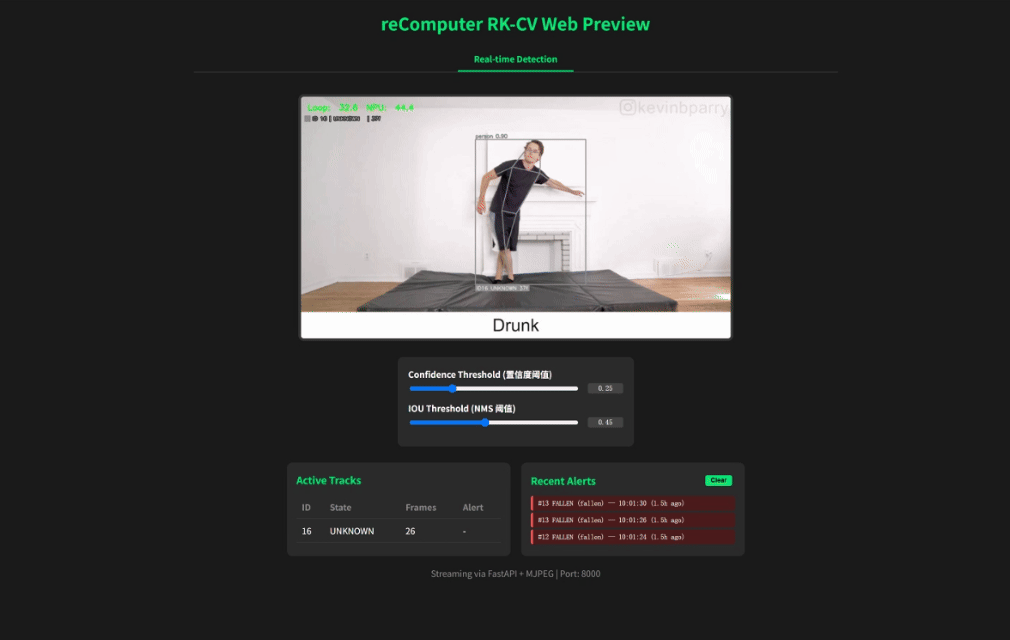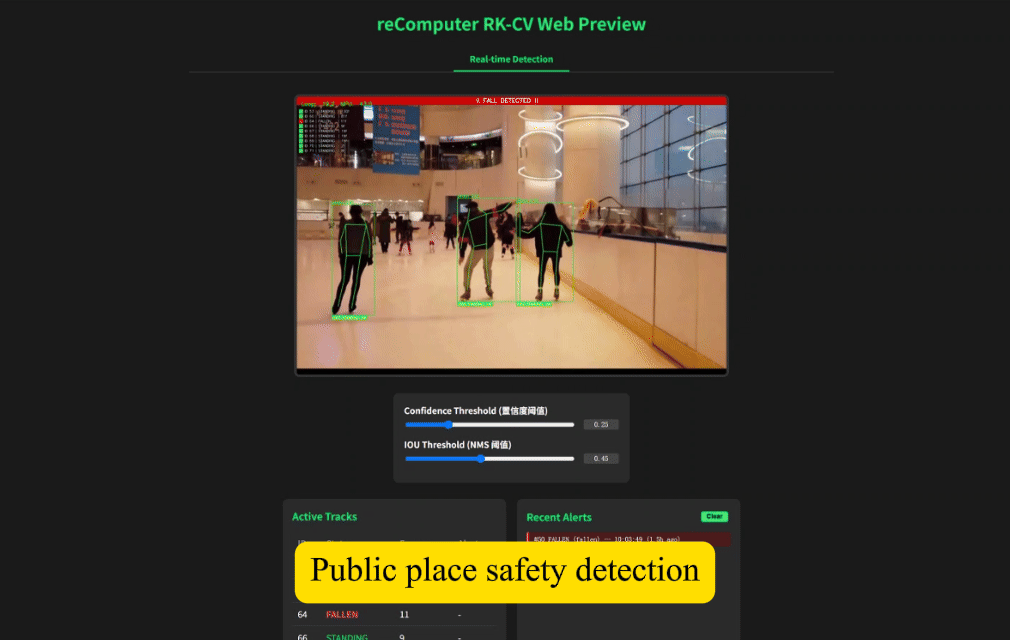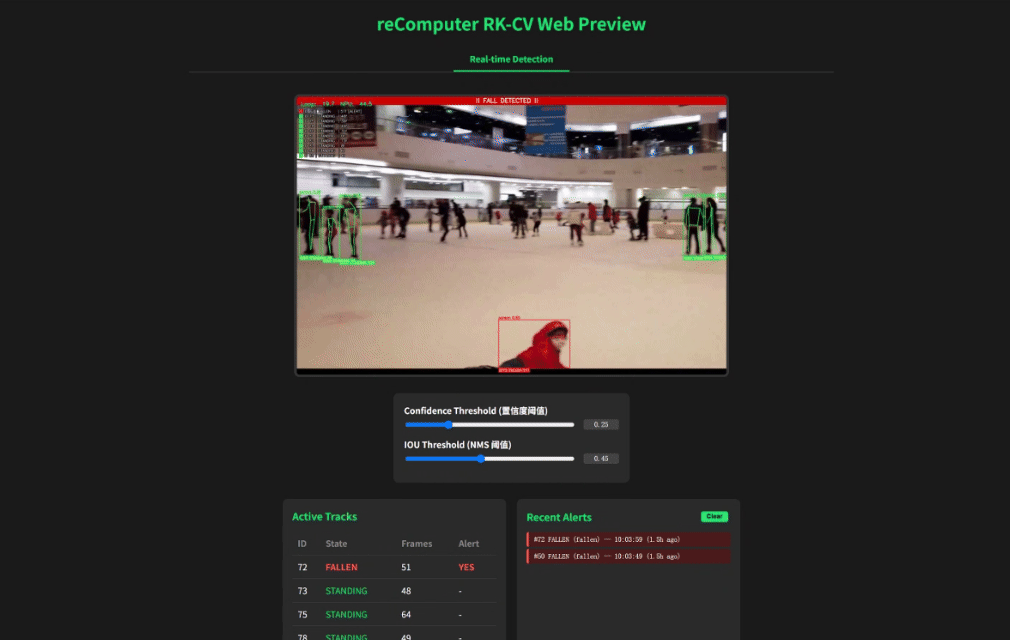
Puedes consultar el código fuente de este proyecto en el siguiente enlace: https://github.com/doublelf/fall_detection
Inicio rápido
Obtén la imagen del proyecto mediante Docker
sudo docker pull ghcr.io/doublelf/pose_optimized:v1.4Prueba el efecto del modelo usando el ejemplo integrado
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Si quieres probar con un vídeo local, crea una carpeta "video" en el directorio actual y añade -v "$(pwd)"/video:/app/video al comando para mapear la carpeta. Luego podrás subir cualquier vídeo de tu carpeta local de vídeo para inferencia.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Cuando el proyecto se ejecute correctamente, abre la página http://<board_ip>:8000/ para ver el efecto de inferencia en tiempo real.
Desarrollo secundario basado en el proyecto
Obtén directamente el código fuente original desde GitHub para modificarlo
git clone https://github.com/doublelf/fall_detectionEl archivo principal de ejecución es web_detection.py. Tras terminar las modificaciones del código, recuerda reconstruir el código local en la imagen de Docker.
sudo docker build -t ghcr.io/doublelf/pose_optimized:v1.4Después, vuelve a ejecutarlo.
Llamar a la cámara para inferencia en tiempo real
Durante la inferencia, cambia el parámetro --video por --camera_id para invocar la cámara y realizar la inferencia.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --camera_id 1
Aquí, --camera_id está relacionado con el dispositivo que especificaste en --device /dev/video1:/dev/video1.
Extensiones de inferencia de IA
Motor de inferencia: encapsulado sobre la API C de RKNN, con la entrada principal en web_detection.py y las llamadas reales en utils/rknn_wrapper.py, compatible con la aceleración por hardware de la NPU del RK3576.
Entrada del modelo: acepta el modelo cuantizado yolov8n_pose.rknn con un tamaño de entrada fijo de 640×640. La salida incluye cajas de detección de objetos y coordenadas de 17 puntos clave.
Postprocesado: analiza los tres mapas de características de la salida del modelo, elimina cajas duplicadas mediante NMS y utiliza el algoritmo OKS para optimizar la confianza de los puntos clave, generando finalmente datos de pose estructurados.
Preprocesamiento y procesamiento de imagen
Aceleración por hardware: utiliza la unidad RGA del RK3576 para el escalado de imagen, conversión del espacio de color (YUV→RGB) y conversión de formato, reduciendo significativamente la carga de CPU.
Captura de vídeo: admite captura directa desde cámaras V4L2 o lectura desde archivos de vídeo locales, con cambio de fuente de entrada mediante los parámetros --camera_id y --video.
Control de frecuencia de imagen: los hilos de captura e inferencia están separados, utilizando una cola de doble búfer para evitar pérdidas de fotogramas y garantizar la latencia mínima de los flujos en tiempo real.
Recomendaciones de despliegue
Permisos de ejecución: se debe usar el modo de contenedor --privileged y mapear explícitamente /dev/video*, /dev/dri/renderD* (para RGA) y el archivo de compatibilidad del árbol de dispositivos, para garantizar el acceso normal a la NPU y la VPU.
Empaquetado de la imagen: la imagen ya incluye todas las dependencias (RKNN Runtime, OpenCV, Flask). Se recomienda usar --net=host para evitar la complejidad del mapeo de puertos. Si necesitas persistir modelos o configuraciones, puedes montar directorios externos.
Ejecución prolongada: se recomienda combinar con un servicio systemd o supervisor para monitorizar el proceso del contenedor, y establecer la política --restart=always.
Limitaciones conocidas
Inferencia de un único flujo: el diseño actual solo admite la entrada de un único flujo de vídeo. La concurrencia de múltiples flujos requiere desarrollo adicional de lógica de gestión multihilo/multiproceso. Sobrecarga de renderizado: aunque RGA acelera el preprocesado, las operaciones de dibujo de OpenCV siguen consumiendo ciertos recursos de CPU. En alta resolución, la frecuencia de imagen puede caer a 15–20 FPS. Soporte de flujos de red: actualmente solo admite cámaras o archivos locales; la captura de flujos de red RTSP/HTTP aún no está integrada. Sin caché persistente: los resultados de detección solo se utilizan para visualización en tiempo real y no se almacenan en una base de datos ni en el sistema de archivos. Para conservar el historial es necesario ampliarlo a medida. Compatibilidad de hardware: la aceleración RGA depende de drivers específicos del RK3576. Otros chips de la serie RK (como el RK3568) podrían no ejecutarse directamente y requerirían recompilar OpenCV y ajustar la interfaz de llamada RGA.