Ein Sturzerkennungsprojekt basierend auf RK3576 / RKNN / YOLO / RGA.
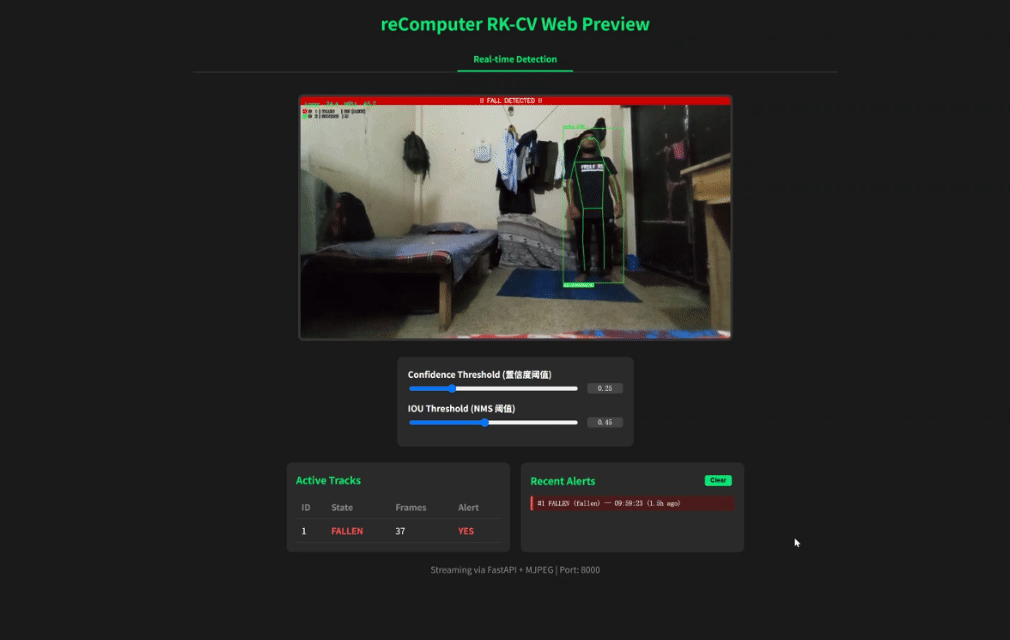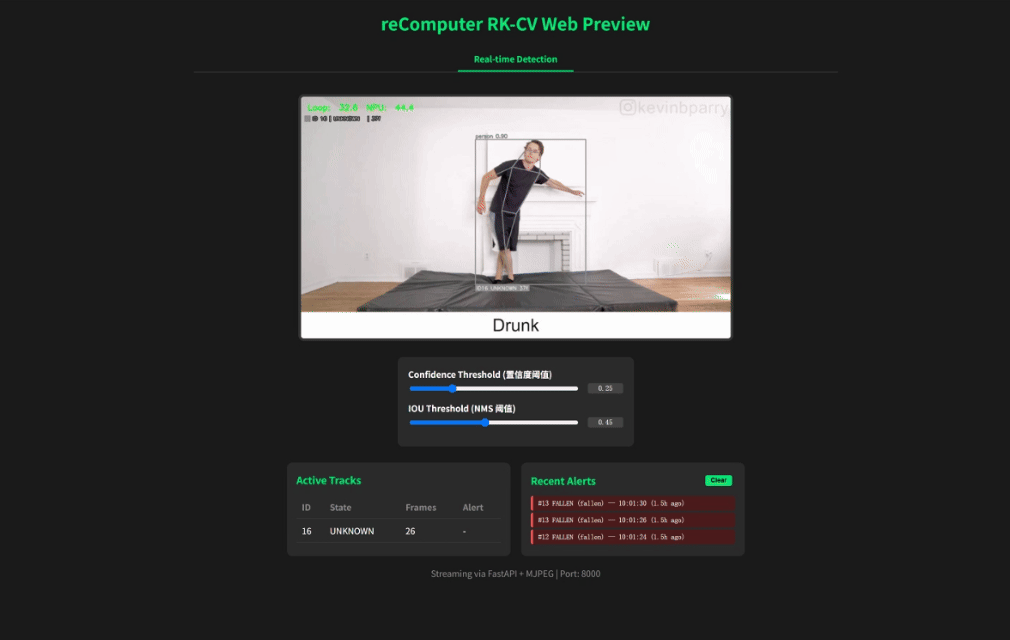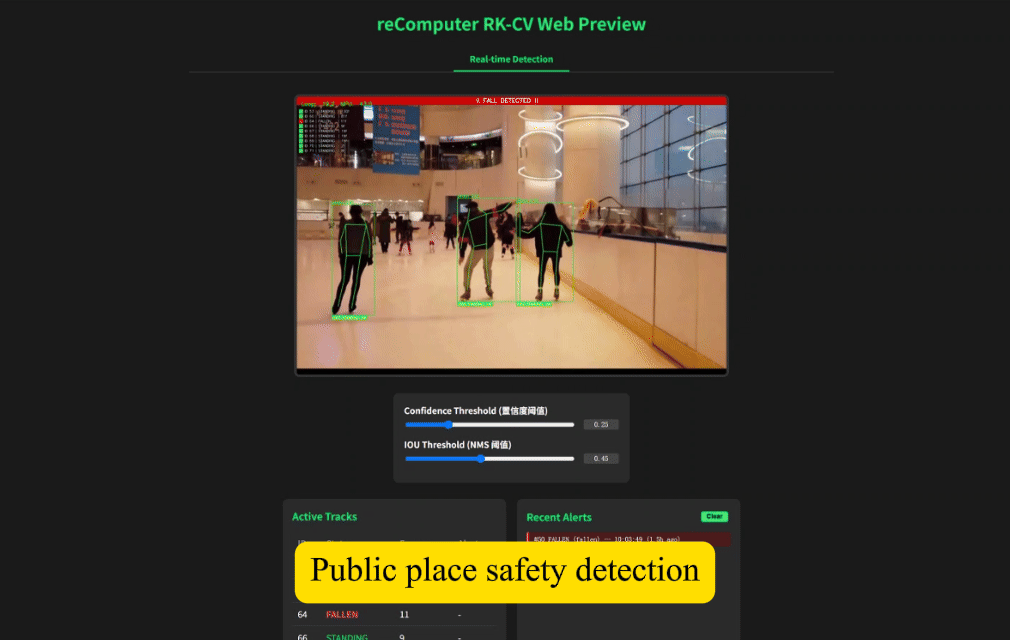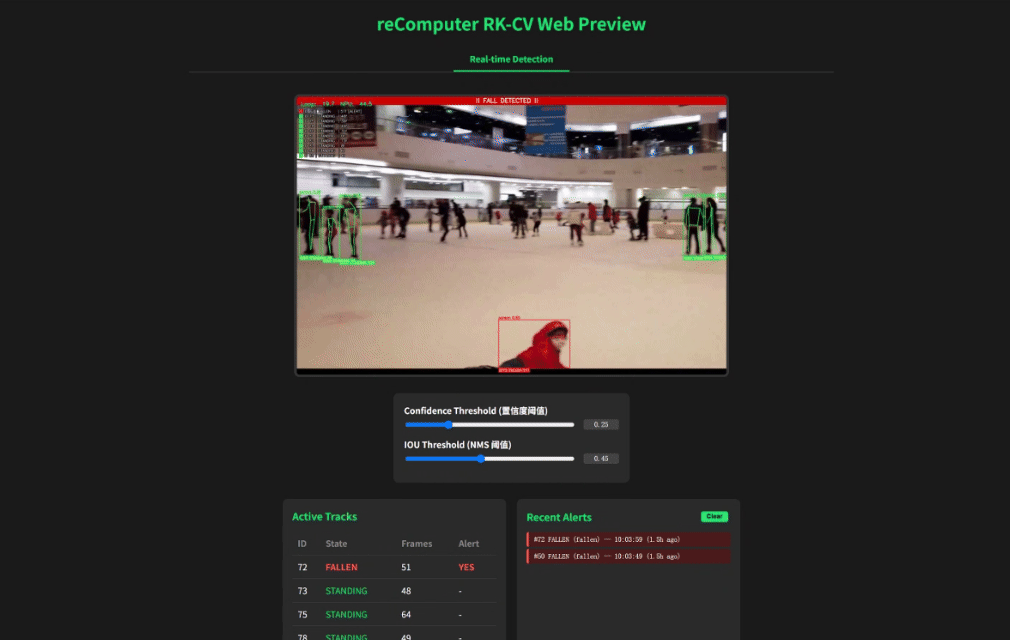
Sie können den Quellcode dieses Projekts unter folgendem Link einsehen: https://github.com/doublelf/fall_detection
Schnellstart
Projekt-Image über Docker ziehen
sudo docker pull ghcr.io/doublelf/pose_optimized:v1.4Modelleffekt mit dem integrierten Beispiel testen
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Wenn Sie mit einem lokalen Video testen möchten, erstellen Sie im aktuellen Verzeichnis einen Ordner „video" und fügen Sie dem Befehl -v $(pwd)/video:/app/video hinzu, um den Ordner einzubinden. Anschließend können Sie jedes Video aus Ihrem lokalen video-Ordner für die Inferenz bereitstellen.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Nach erfolgreichem Projektstart rufen Sie die Seite http://<board_ip>:8000/ auf, um die Echtzeit-Inferenzwirkung zu sehen.
Sekundärentwicklung auf Basis des Projekts
Den Originalcode direkt von GitHub holen und ändern
git clone https://github.com/doublelf/fall_detectionDie zentrale Ausführungsdatei ist web_detection.py. Nach Abschluss der Codeänderungen muss der lokale Code wieder in das Image eingebaut werden.
sudo docker build -t ghcr.io/doublelf/pose_optimized:v1.4Danach einfach erneut ausführen.
Kamera für Echtzeit-Inferenz aufrufen
Ändern Sie während der Inferenz den Parameter --video zu --camera_id, um die Kamera für die Inferenz aufzurufen.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --camera_id 1
Dabei bezieht sich --camera_id auf das Gerät, das Sie in --device /dev/video1:/dev/video1 angegeben haben.
KI-Inferenz-Erweiterungen
Inferenz-Engine: Verpackt auf Basis der RKNN C API, der Haupteinstieg liegt in web_detection.py, die tatsächlichen Aufrufe in utils/rknn_wrapper.py, unterstützt RK3576-NPU-Hardwarebeschleunigung.
Modelleingabe: Akzeptiert das quantisierte Modell yolov8n_pose.rknn mit fester Eingabegröße 640×640. Die Ausgabe umfasst Objekterkennungsboxen und 17 Schlüsselpunktkoordinaten.
Nachbearbeitung: Analysiert die drei Feature-Maps aus der Modellausgabe, entfernt doppelte Boxen mittels NMS und optimiert die Schlüsselpunkt-Konfidenz mit dem OKS-Algorithmus, um strukturierte Posedaten zu erzeugen.
Vorverarbeitung und Bildverarbeitung
Hardware-Beschleunigung: Nutzt die RGA-Einheit des RK3576 für Bildskalierung, Farbräumkonvertierung (YUV→RGB) und Formatkonvertierung, was die CPU-Last erheblich reduziert.
Videoerfassung: Unterstützt direkte Erfassung von V4L2-Kameras oder das Lesen lokaler Videodateien; Eingabequellen werden über die Parameter --camera_id und --video umgeschaltet.
Bildratensteuerung: Erfassungs- und Inferenz-Thread sind getrennt, mit einer Doppel-Puffer-Warteschlange, um Frame-Drops zu vermeiden und minimale Latenz für Echtzeit-Streams zu gewährleisten.
Empfehlungen für die Bereitstellung
Laufzeitberechtigungen: Der --privileged-Container-Modus muss verwendet und /dev/video*, /dev/dri/renderD* (für RGA) sowie die Gerätebaum-Kompatibilitätsdatei müssen explizit gemappt werden, um den normalen Zugriff auf NPU und VPU sicherzustellen.
Image-Paketierung: Das Image enthält bereits alle Abhängigkeiten (RKNN Runtime, OpenCV, Flask). Es wird empfohlen, --net=host zu verwenden, um die Komplexität der Portzuordnung zu vermeiden. Wenn Sie Modelle oder Konfigurationen dauerhaft speichern müssen, können Sie externe Verzeichnisse einbinden.
Langzeitbetrieb: Es wird empfohlen, einen systemd-Dienst oder Supervisor zur Überwachung des Container-Prozesses zu verwenden und die Richtlinie --restart=always festzulegen.
Bekannte Einschränkungen
Einzelstrom-Inferenz: Das aktuelle Design unterstützt nur Eingabe eines einzelnen Videostreams. Mehrfach-Streams erfordern zusätzliche Entwicklung von Multithreading- / Multiprozess-Management-Logik. Rendering-Overhead: Obwohl RGA die Vorverarbeitung beschleunigt, verbrauchen die Zeichenoperationen von OpenCV immer noch einige CPU-Ressourcen. Bei hohen Auflösungen kann die Bildrate auf 15–20 FPS sinken. Netzwerkstrom-Unterstützung: Derzeit werden nur lokale Kameras oder Dateien unterstützt; das Abrufen von RTSP/HTTP-Netzwerkstreams ist noch nicht integriert. Keine persistente Zwischenspeicherung: Erkennungsergebnisse werden nur für die Echtzeitanzeige verwendet und nicht in einer Datenbank oder einem Dateisystem gespeichert. Für Verlaufsdaten ist eine benutzerdefinierte Erweiterung erforderlich. Hardwarekompatibilität: Die RGA-Beschleunigung hängt von RK3576-spezifischen Treibern ab. Andere RK-Serien-Chips (wie RK3568) laufen möglicherweise nicht direkt und erfordern möglicherweise das Neukompilieren von OpenCV und die Anpassung der RGA-Aufrufschnittstelle.