Een valdetectieproject gebaseerd op RK3576 / RKNN / YOLO / RGA.
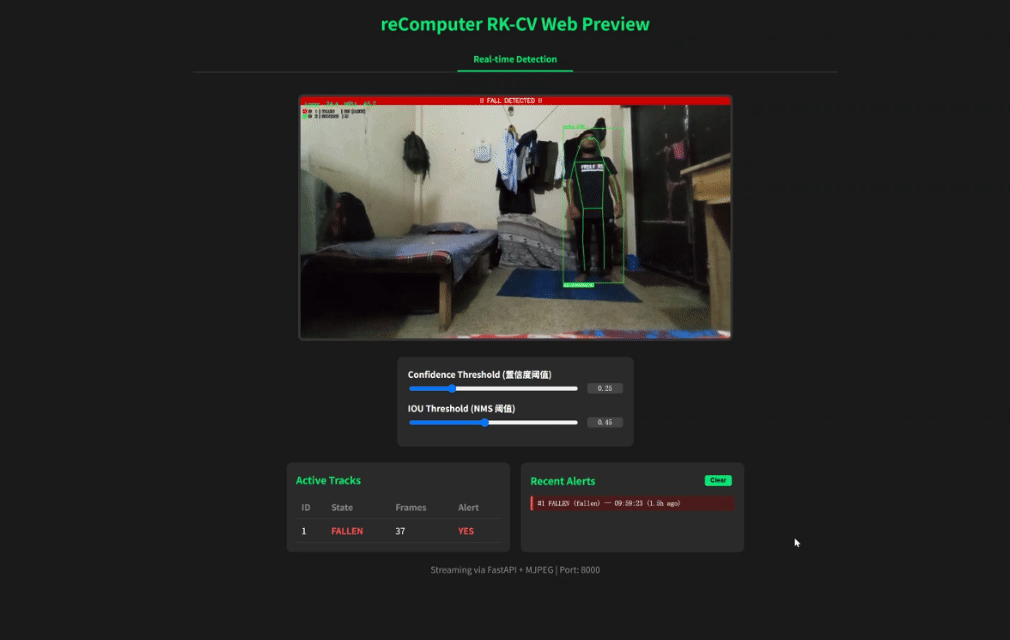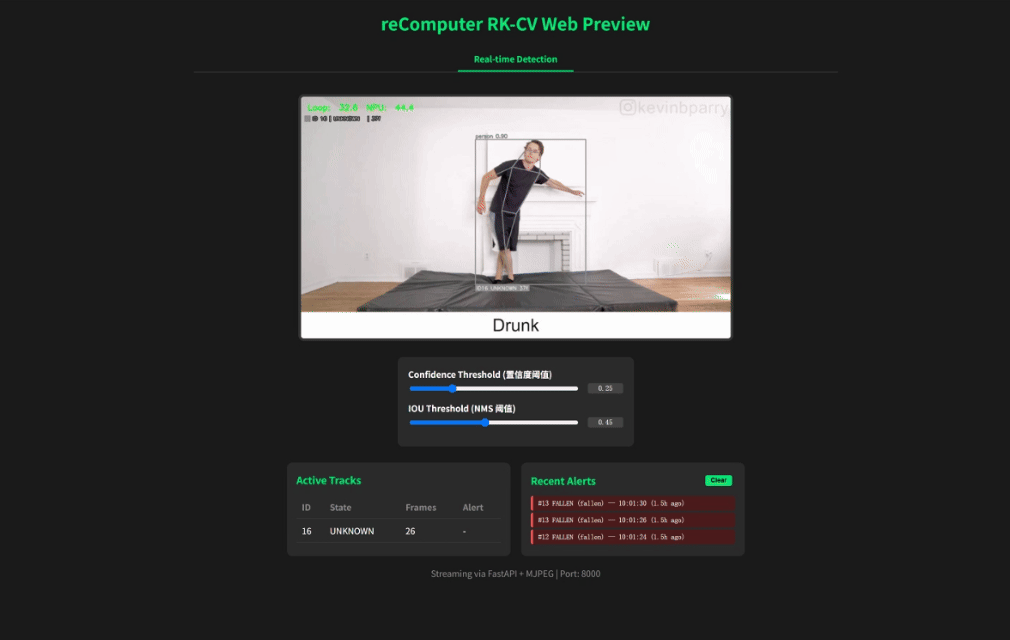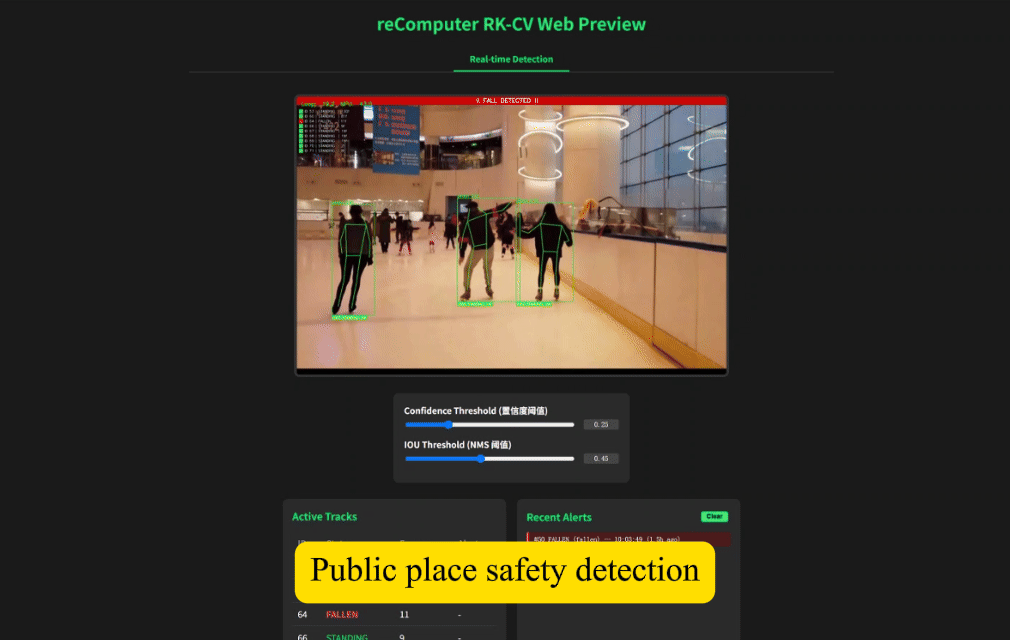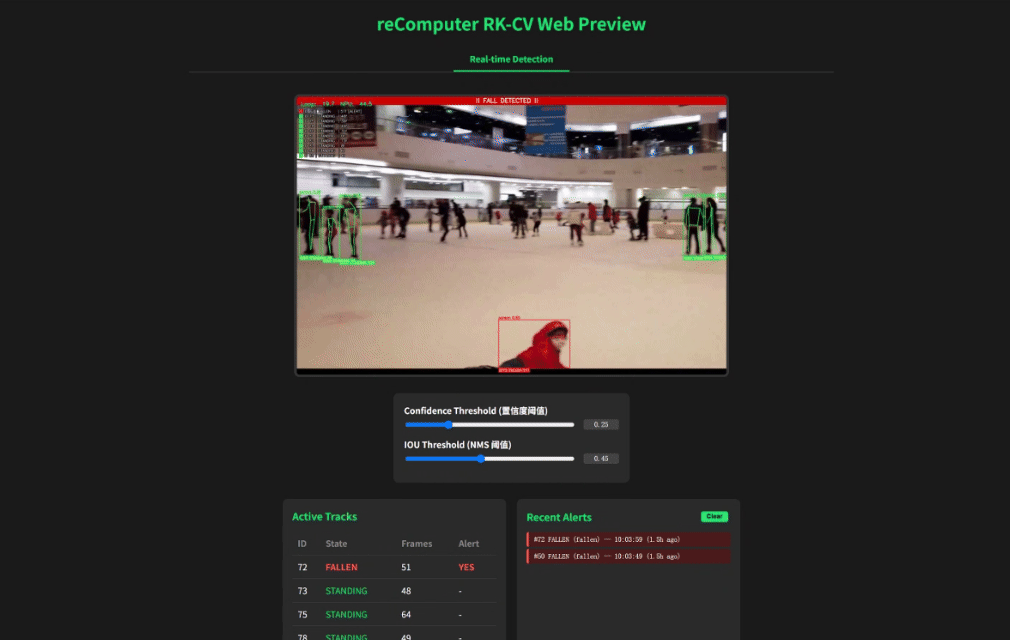
U kunt de broncode van dit project bekijken via de volgende link: https://github.com/doublelf/fall_detection
Snel starten
Project-image via Docker ophalen
sudo docker pull ghcr.io/doublelf/pose_optimized:v1.4Test het modeleffect met het ingebouwde voorbeeld
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Als je met een lokale video wilt testen, maak dan een map "video" aan in de huidige directory en voeg -v $(pwd)/video:/app/video toe aan het commando om de map te koppelen. Vervolgens kun je elke video uit je lokale video-map aanleveren voor inferentie.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Als het project succesvol draait, open dan http://<board_ip>:8000/ om het realtime-inferentieresultaat te bekijken.
Secundaire ontwikkeling op basis van het project
Haal de originele broncode rechtstreeks op van GitHub om aan te passen
git clone https://github.com/doublelf/fall_detectionHet kernuitvoeringsbestand is web_detection.py. Vergeet niet om na het voltooien van de codewijzigingen de lokale code opnieuw in de Docker-image te bouwen.
sudo docker build -t ghcr.io/doublelf/pose_optimized:v1.4Start daarna opnieuw.
Camera oproepen voor realtime-inferentie
Wijzig tijdens de inferentie de parameter --video naar --camera_id om de camera op te roepen voor inferentie.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --camera_id 1
Hier is --camera_id gekoppeld aan het apparaat dat je hebt opgegeven in --device /dev/video1:/dev/video1.
AI-inferentie-uitbreidingen
Inferentie-engine: ingepakt op basis van de RKNN C API, met de hoofdingang in web_detection.py en de daadwerkelijke aanroepen in utils/rknn_wrapper.py, ondersteunt RK3576-NPU-hardwareversnelling.
Modelinvoer: accepteert het gekwantiseerde model yolov8n_pose.rknn met een vaste invoergrootte van 640×640. De uitvoer omvat objectdetectie-bboxes en coördinaten van 17 keypoints.
Post-processing: analyseert de drie feature maps uit de modeluitvoer, verwijdert dubbele boxes en optimaliseert de keypoint-confidence met het OKS algoritme, en genereert uiteindelijk gestructureerde posedata.
Voorverwerking en beeldverwerking
Hardwareversnelling: gebruikt de RGA-eenheid van de RK3576 voor beeldschaling, kleurruimteconversie (YUV→RGB) en formaatconversie, wat de CPU-belasting aanzienlijk verlaagt.
Video-opname: ondersteunt directe opname van V4L2-camera's of lezen van lokale videobestanden, met wisseling van inputvoer via de parameters --camera_id en --video.
Framerate-regeling: opname- en inferentie-threads zijn gescheiden, met een dubbelbuffer-wachtrij om framedrops te voorkomen en minimale latentie voor realtime-streams te garanderen.
Implementatie-aanbevelingen
Runtime-rechten: de container-modus --privileged moet worden gebruikt en /dev/video*, /dev/dri/renderD* (voor RGA) en het device-tree-compatibiliteitsbestand moeten expliciet worden gemapt om normale toegang tot NPU en VPU te garanderen.
Image-packaging: de image bevat reeds alle afhankelijkheden (RKNN Runtime, OpenCV, Flask). Het wordt aanbevolen om --net=host te gebruiken om de complexiteit van poortmapping te vermijden. Als je modellen of configuraties wilt bewaren, kun je externe directories mounten.
Continue werking: het wordt aanbevolen om een systemd-service of supervisor te gebruiken om het containerproces te bewaken, en het beleid --restart=always in te stellen.
Bekende beperkingen
Enkelvoudige-stream-inferentie: het huidige ontwerp ondersteunt slechts invoer van één videostream. Gelijktijdigheid van meerdere streams vereist extra ontwikkeling van multi-thread-/multi-proces-beheerlogica. Rendering-overhead: hoewel RGA de voorverwerking versnelt, kosten de tekenbewerkingen van OpenCV nog steeds enige CPU-middelen. Bij hoge resoluties kan de framerate dalen naar 15–20 FPS. Netwerkstream-ondersteuning: momenteel worden alleen lokale camera's of bestanden ondersteund; het ophalen van RTSP/HTTP-netwerkstreams is nog niet geïntegreerd. Geen persistente cache: detectieresultaten worden alleen voor realtimedisplay gebruikt en worden niet opgeslagen in een database of bestandssysteem. Voor historische gegevens is een eigen uitbreiding vereist. Hardwarecompatibiliteit: RGA-versnelling is afhankelijk van RK3576-specifieke drivers. Andere RK-serie-chips (zoals RK3568) werken mogelijk niet direct en vereisen mogelijk het hercompileren van OpenCV en het aanpassen van de RGA-aanroepinterface.