Un projet de détection de chute basé sur RK3576 / RKNN / YOLO / RGA.
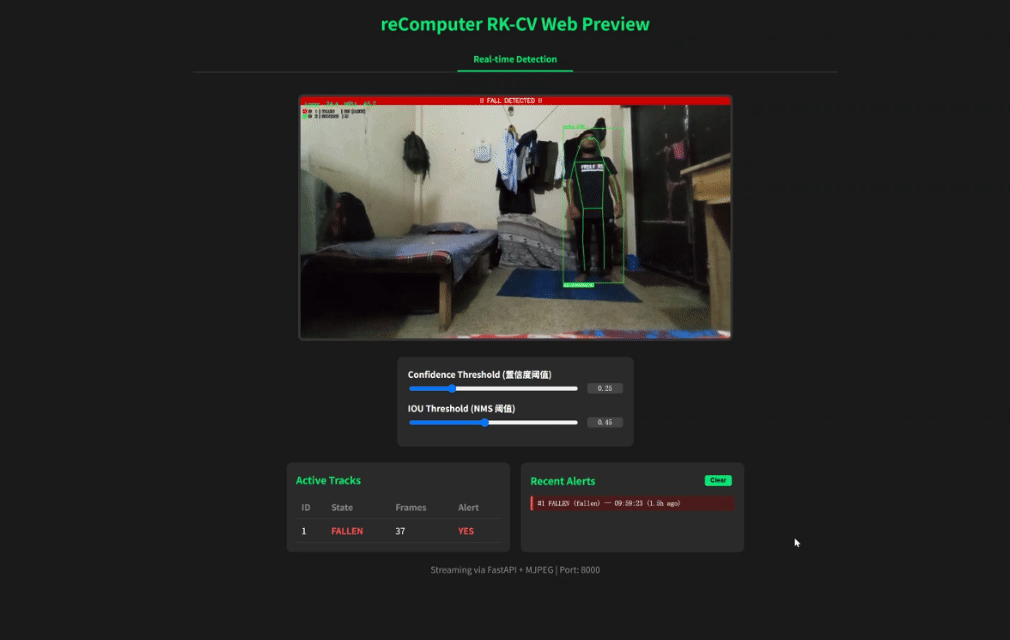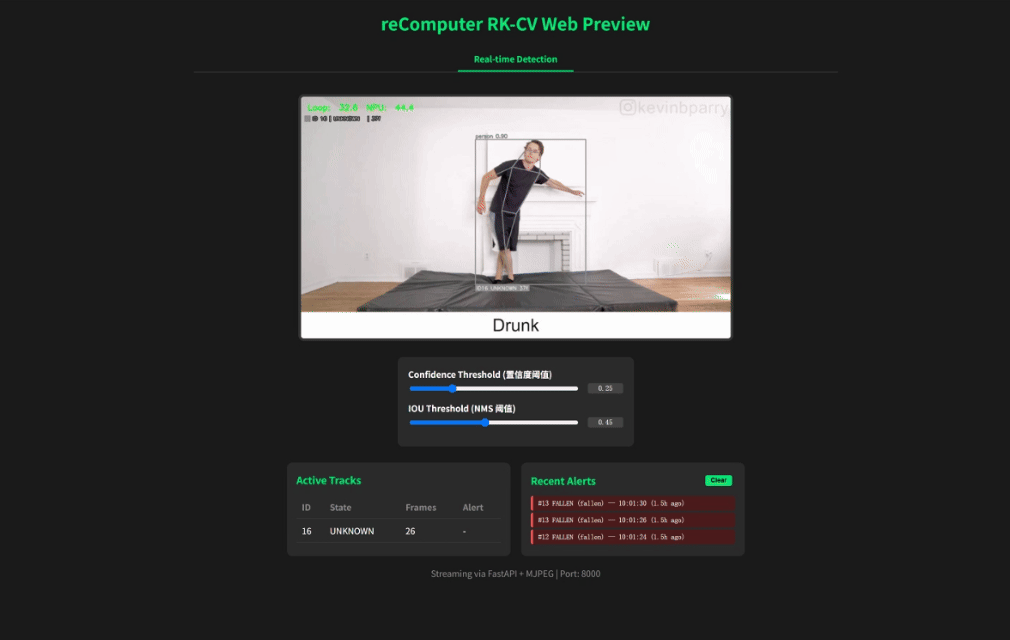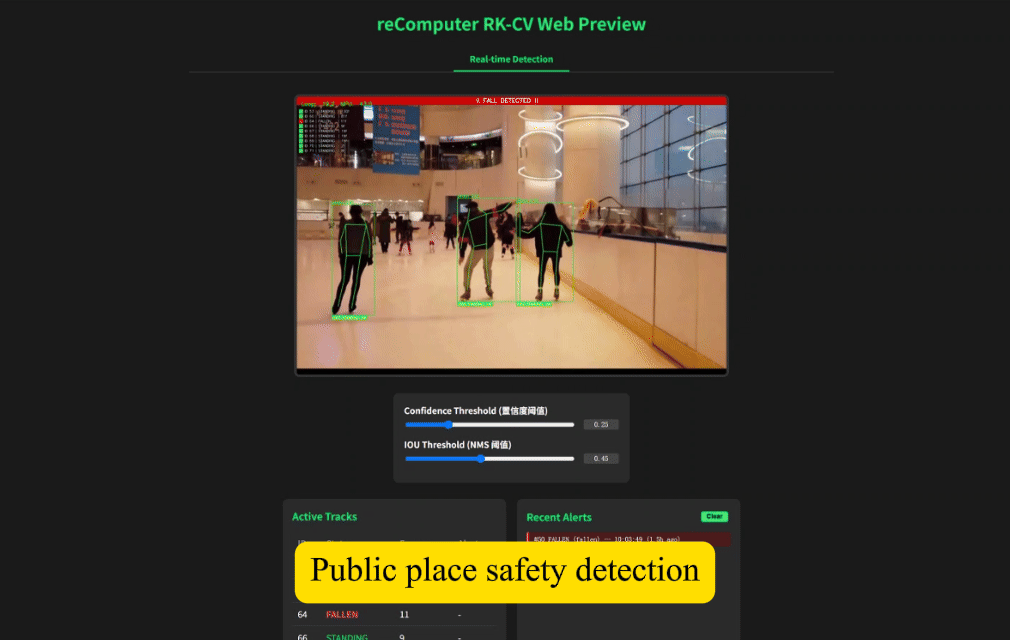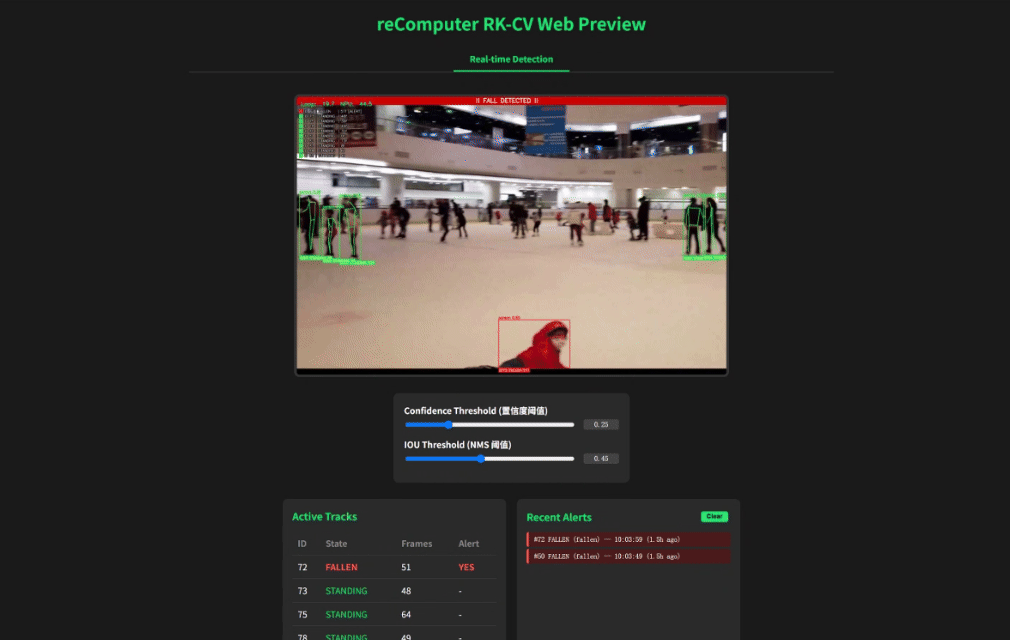
Vous pouvez consulter le code source de ce projet à l'adresse suivante : https://github.com/doublelf/fall_detection
Démarrage rapide
Récupérer l'image du projet via Docker
sudo docker pull ghcr.io/doublelf/pose_optimized:v1.4Tester l'effet du modèle à l'aide de l'exemple intégré
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Si vous souhaitez tester avec une vidéo locale, créez un dossier « video » dans le répertoire courant et ajoutez -v $(pwd)/video:/app/video à la commande pour monter le dossier. Vous pourrez ensuite transmettre n'importe quelle vidéo de votre dossier local « video » pour l'inférence.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
Une fois le projet exécuté avec succès, ouvrez la page http://<board_ip>:8000/ pour visualiser l'effet d'inférence en temps réel.
Développement secondaire basé sur le projet
Récupérer directement le code source original depuis GitHub pour le modifier
git clone https://github.com/doublelf/fall_detectionLe fichier d'exécution principal est web_detection.py. Une fois les modifications de code terminées, n'oubliez pas de reconstruire le code local dans l'image Docker.
sudo docker build -t ghcr.io/doublelf/pose_optimized:v1.4Relancez ensuite simplement.
Appeler la caméra pour l'inférence en temps réel
Pendant l'inférence, modifiez le paramètre --video en --camera_id pour appeler la caméra et effectuer l'inférence.
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --camera_id 1
Ici, --camera_id est lié au périphérique que vous avez indiqué dans --device /dev/video1:/dev/video1.
Extensions d'inférence IA
Moteur d'inférence : encapsulé sur la base de l'API C RKNN, l'entrée principale se trouve dans web_detection.py, les appels réels dans utils/rknn_wrapper.py, avec prise en charge de l'accélération matérielle NPU du RK3576.
Entrée du modèle : accepte le modèle quantifié yolov8n_pose.rknn avec une taille d'entrée fixe de 640×640. La sortie comprend les boîtes de détection d'objets et les coordonnées de 17 points-clés.
Post-traitement : analyse les trois cartes de caractéristiques issues du modèle, supprime les boîtes en doublon via NMS et utilise l'algorithme OKS pour optimiser la confiance des points-clés, produisant finalement des données de pose structurées.
Prétraitement et traitement d'image
Accélération matérielle : exploite l'unité RGA du RK3576 pour la mise à l'échelle d'image, la conversion d'espace colorimétrique (YUV→RGB) et la conversion de format, réduisant considérablement la charge CPU.
Capture vidéo : prend en charge la capture directe depuis des caméras V4L2 ou la lecture depuis des fichiers vidéo locaux, les sources d'entrée étant commutées via les paramètres --camera_id et --video.
Contrôle de la fréquence d'images : les threads de capture et d'inférence sont séparés, avec une file à double tampon pour éviter les pertes de trames et garantir une latence minimale pour les flux en temps réel.
Recommandations de déploiement
Droits d'exécution : le mode conteneur --privileged doit être utilisé et /dev/video*, /dev/dri/renderD* (pour RGA), ainsi que le fichier de compatibilité du device tree doivent être explicitement mappés pour garantir un accès normal au NPU et au VPU.
Packaging de l'image : l'image inclut déjà toutes les dépendances (RKNN Runtime, OpenCV, Flask). Il est recommandé d'utiliser --net=host pour éviter la complexité du mappage de ports. Si vous avez besoin de persister des modèles ou des configurations, vous pouvez monter des répertoires externes.
Fonctionnement longue durée : il est recommandé d'utiliser un service systemd ou un supervisor pour surveiller le processus du conteneur, et de définir la politique --restart=always.
Limitations connues
Inférence à un seul flux : la conception actuelle ne prend en charge qu'une seule entrée de flux vidéo. La concurrence multi-flux nécessite le développement d'une logique supplémentaire de gestion multi-thread / multi-processus. Surcharge de rendu : bien que RGA accélère le prétraitement, les opérations de dessin d'OpenCV consomment encore certaines ressources CPU. À haute résolution, la fréquence d'images peut descendre à 15–20 FPS. Prise en charge des flux réseau : actuellement, seules les caméras ou fichiers locaux sont pris en charge ; la récupération de flux réseau RTSP/HTTP n'est pas encore intégrée. Pas de cache persistant : les résultats de détection ne servent qu'à l'affichage en temps réel et ne sont pas stockés dans une base de données ni dans le système de fichiers. La conservation de l'historique nécessite une extension personnalisée. Compatibilité matérielle : l'accélération RGA dépend de pilotes spécifiques au RK3576. D'autres puces de la série RK (telles que le RK3568) peuvent ne pas fonctionner directement et peuvent nécessiter une recompilation d'OpenCV et un ajustement de l'interface d'appel RGA.