RK3576 / RKNN / YOLO / RGA に基づく転倒検知プロジェクト。
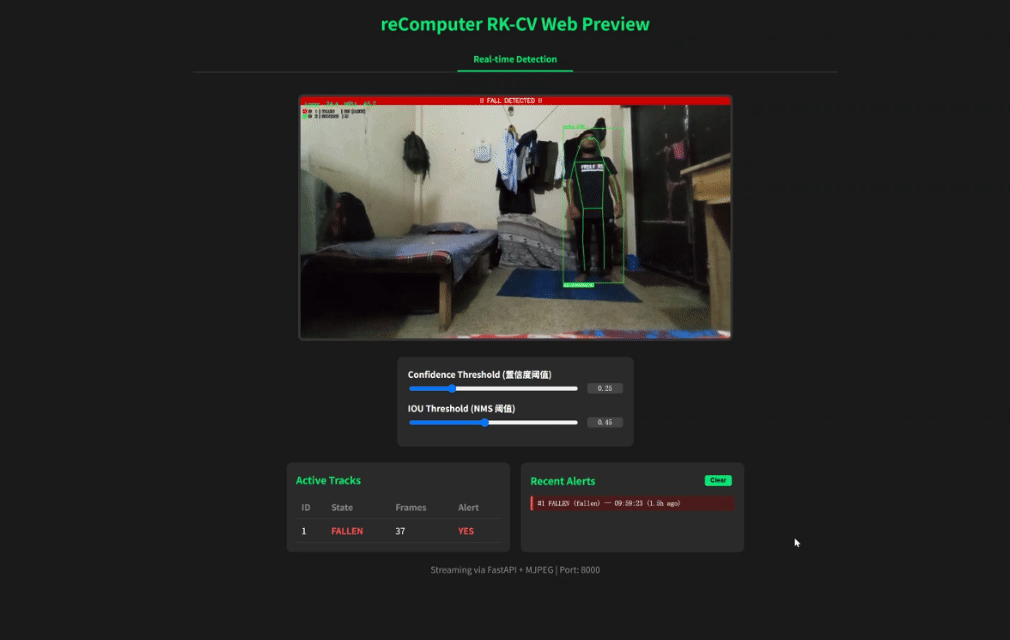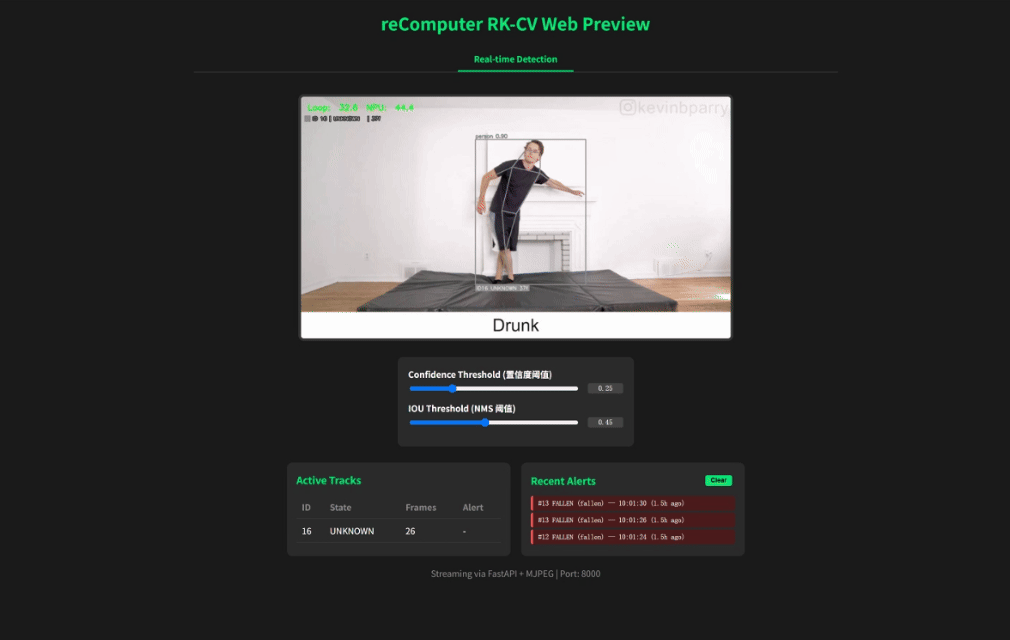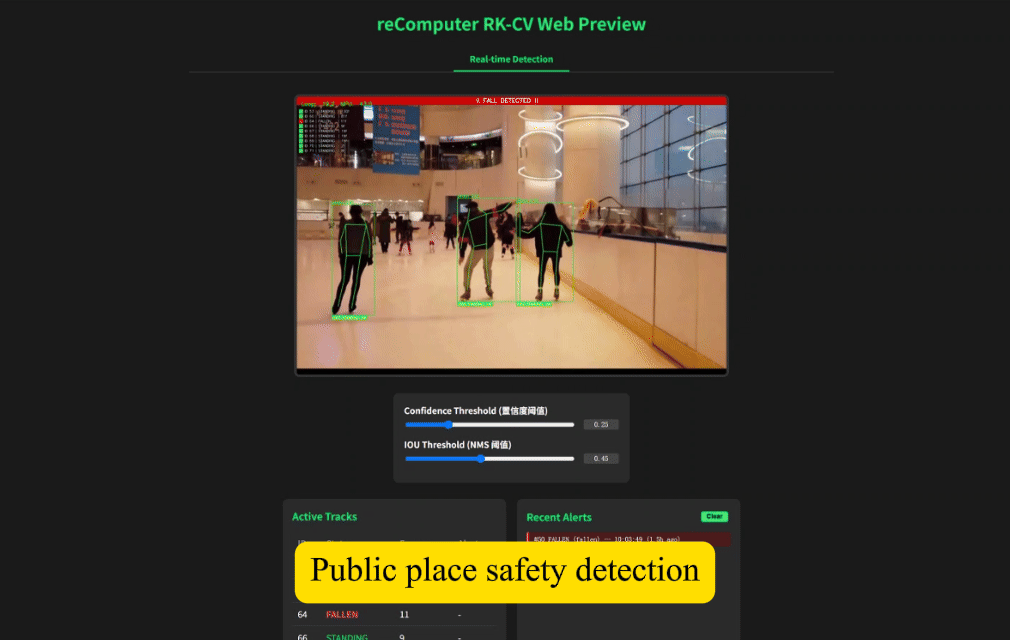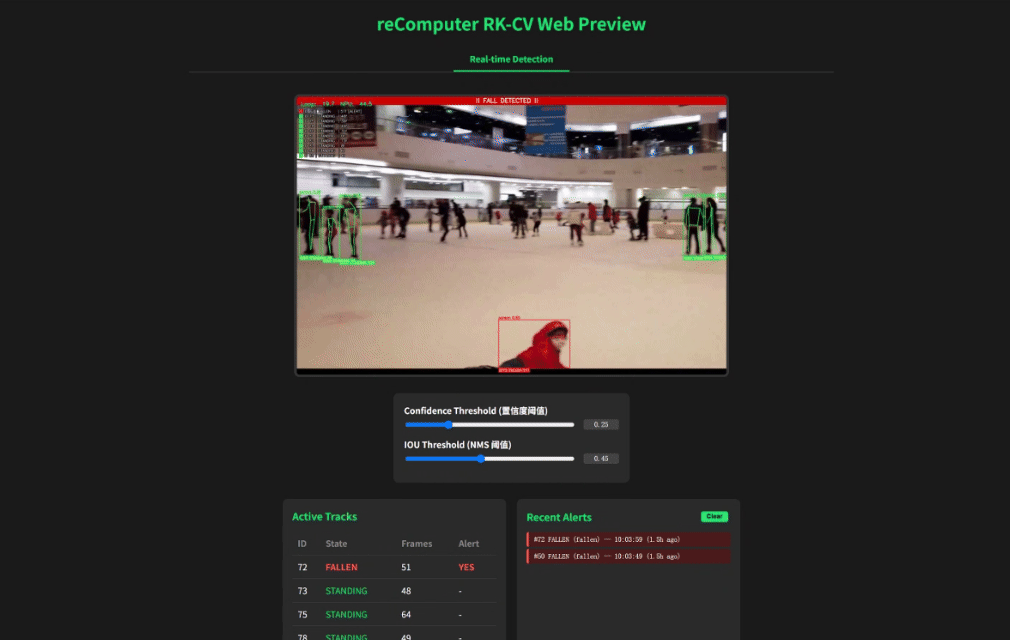
本プロジェクトのソースコードは以下のリンクから確認できます: https://github.com/doublelf/fall_detection
クイックスタート
Docker でイメージを取得
sudo docker pull ghcr.io/doublelf/pose_optimized:v1.4内蔵のサンプルでモデルの効果をテスト
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
ローカル動画でテストしたい場合は、カレントディレクトリに「video」フォルダを作成し、コマンドに -v $(pwd)/video:/app/video を追加してフォルダをマウントしてください。これでローカルの video フォルダ内の任意の動画を推論にアップロードできます。
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --video video/example1.mp4
プロジェクトが正常に動作したら、ページ http://<board_ip>:8000/ を開いてリアルタイム推論の効果を確認してください。
プロジェクトに基づく二次開発
GitHub から直接ソースコードをクローンして変更
git clone https://github.com/doublelf/fall_detection主要な実行ファイルは web_detection.py です。コード修正が完了したら、ローカルコードを Docker イメージに再ビルドすることを忘れずに。
sudo docker build -t ghcr.io/doublelf/pose_optimized:v1.4その後、再度実行してください。
カメラを呼び出してリアルタイム推論
推論時に --video パラメータを --camera_id に変更すれば、カメラを呼び出して推論できます。
sudo docker run --rm --privileged --net=host \
  -e PYTHONUNBUFFERED=1 \
  -e RKNN_LOG_LEVEL=0 \
  --device /dev/video1:/dev/video1 \
  --device /dev/dri/renderD129:/dev/dri/renderD129 \
  -v /proc/device-tree/compatible:/proc/device-tree/compatible \
  -v $(pwd)/video:/app/video \
  ghcr.io/doublelf/pose_optimized:v1.4 \
  python3 web_detection.py --model_path model/yolov8n_pose.rknn --camera_id 1
ここで --camera_id は --device /dev/video1:/dev/video1 で指定したデバイスに対応します。
AI 推論の拡張
推論エンジン: RKNN C API をベースにカプセル化されており、メインエントリは web_detection.py、実際の呼び出しは utils/rknn_wrapper.py で RK3576 NPU ハードウェアアクセラレーションをサポートします。
モデル入力: 量子化モデル yolov8n_pose.rknn を受け付け、入力サイズは 640×640 固定です。出力には物体検出ボックスと 17 個のキーポイント座標が含まれます。
後処理: モデル出力の 3 つの特徴マップを解析し、NMS で重複ボックスを取り除き、OKS アルゴリズムでキーポイントの信頼度を最適化して、最終的に構造化された姿勢データを生成します。
前処理と画像処理
ハードウェアアクセラレーション: RK3576 の RGA ユニットを利用して画像のリスケーリング、色空間変換 (YUV→RGB)、フォーマット変換を行い、CPU 負荷を大幅に削減します。
動画取得: V4L2 カメラからの直接取得、またはローカル動画ファイルの読み取りに対応し、--camera_id と --video パラメータで入力ソースを切り替えます。
フレームレート制御: 取得スレッドと推論スレッドを分離し、ダブルバッファキューでフレームドロップを回避してリアルタイムストリームの最小遅延を保証します。
デプロイの推奨事項
実行権限: --privileged コンテナモードを使用し、/dev/video*、/dev/dri/renderD*(RGA 用)、デバイスツリー互換ファイルを明示的にマップし、NPU と VPU への正常なアクセスを保証する必要があります。
イメージのパッケージング: イメージには既にすべての依存関係(RKNN Runtime、OpenCV、Flask)が含まれています。ポートマッピングの複雑さを避けるため --net=host の使用を推奨します。モデルや設定を永続化する必要がある場合は、外部ディレクトリをマウントできます。
長期実行: systemd サービスや supervisor でコンテナプロセスを監視し、--restart=always ポリシーを設定することを推奨します。
既知の制限事項
単一ストリーム推論: 現在の設計は単一の動画ストリーム入力のみサポートします。複数ストリームの並行実行には、マルチスレッド/マルチプロセス管理ロジックの追加開発が必要です。 レンダリングオーバーヘッド: RGA が前処理を高速化しているものの、OpenCV の描画操作は依然として一定の CPU リソースを消費します。高解像度ではフレームレートが 15–20 FPS まで低下する可能性があります。 ネットワークストリーム対応: 現在はローカルカメラまたはファイルのみをサポートしており、RTSP/HTTP ネットワークストリームの取得はまだ統合されていません。 永続キャッシュなし: 検出結果はリアルタイム表示にのみ使用され、データベースやファイルシステムには保存されません。履歴データの保持には独自の拡張が必要です。 ハードウェア互換性: RGA アクセラレーションは RK3576 専用ドライバに依存します。他の RK シリーズチップ(RK3568 など)は直接動作しない可能性があり、OpenCV の再コンパイルと RGA 呼び出しインターフェース adjustment が必要になる場合があります。