reComputer で動画から顔アルバムを自動構築
Hailo-8 / SCRFD / ArcFace をベースにした、エッジでの顔アルバム自動アーカイブプロジェクト。
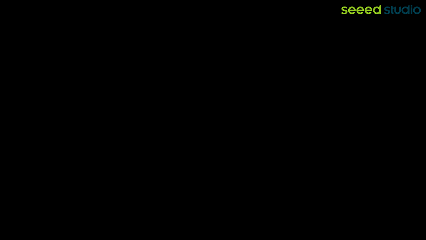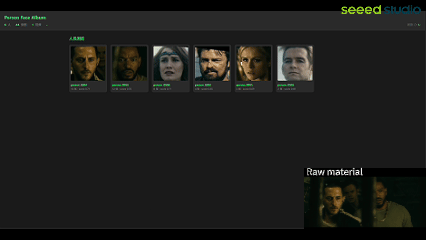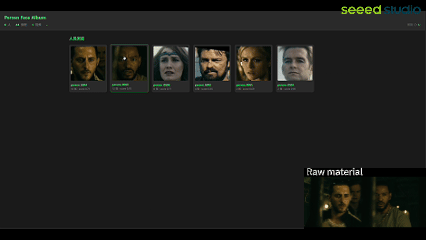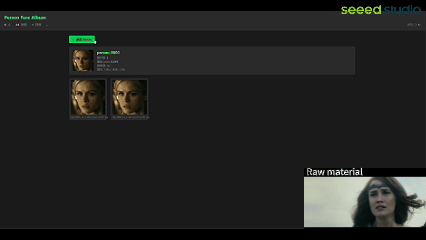
本プロジェクトのソースコードは GitHub で確認できます: https://github.com/doublelf/person_face_sign
1. プロジェクト概要
Person Face Sign は、エッジデバイス(reComputer + Hailo-8 NPU)上でオフラインの「顔アルバム」を構築するプロジェクトです。中心的な目的は、監視 / アクティビティ映像中のすべての顔をそれぞれの「アイデンティティアルバム」に自動分類し、後から検索・統計・整理しやすくすることです。
解決する典型的な課題
- 来訪者受付 / ビジター管理:受付カメラの長時間映像を本スクリプトに渡すと、「今日は 23 人来て、それぞれ N 枚」と自動で出力されます。
- 授業 / 会議の出欠補助:授業録画を頭ごとに分類し、電子出欠の根拠として利用できます。
- イベント写真の自動整理:現場の複数カメラ・複数アングルの映像を結合・クラスタリングし、人物別のアルバムを自動で生成します。
- 映像素材の二次検索:タイムスタンプではなく、人物で人物を検索できるようにします。
中核パイプライン
映像 (data/*.mp4)
    │
    ▼
[VideoSampler] —— 1 秒に 1 フレーム (1280×720)
    │
    ▼
[YOLOv8n] —— 人物検出 (640×640)
    │
    ▼
[IoUTracker] —— 人物トラッキング + 顔サンプリングのスロットル (無効化可能)
    │
    ▼
[SCRFD-10G] —— 顔検出 + 5 点ランドマーク
    │
    ▼
[FaceAlign 5pt] —— アフィン変換で 112×112 にアライメント
    │
    ▼
[ArcFace MobileFaceNet] —— 512-d L2-norm 埋め込み
    │
    ▼
[AlbumCluster] —— pHash 優先 / Faiss HNSW をフォールバック → person_id を割り当て
    │
    ▼
[AlbumStorage] —— ファイル書き出し + 二重重複排除 + manifest.json 更新
    │
    ▼
[Web Browser :8080] —— 結果を閲覧 / 検索
2. クイックスタート
以下は reComputer 上で閲覧可能な顔アルバムを構築するまでの、エンドツーエンドの手順です。
2.1 リポジトリのクローン
git clone https://github.com/doublelf/person_face_sign.git
cd person_face_sign
2.2 仮想環境の作成
venv の使用を推奨します(Python 標準で追加インストール不要)。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
2.3 Python 依存関係のインストール
pip install -r requirements.txt2.4 システムレベルの前提依存をインストール
build_album.py は subprocess 経由で ffmpeg / ffprobe を呼び出してフレームをサンプリングするため、システムレベルでのインストールが必要です:
# Debian / Ubuntu(reComputer を含む)
sudo apt update
sudo apt install -y ffmpeg

# 確認
ffmpeg -version | head -n 1
ffprobe -version | head -n 1
2.5 HEF モデルファイルの準備
person_face_sign/
└── models/
    ├── yolov8n.hef                    # ~4.3 MB
    ├── scrfd_10g.hef                  # ~10 MB
└── arcface_mobilefacenet.hef # ~5 MB| 用途 | モデル | デフォルトパス(build_album.py にハードコード) | 入手元 |
|---|---|---|---|
| 人物検出 | YOLOv8n | <プロジェクトルート>/models/yolov8n.hef | 公式 Docker イメージに内蔵、コンテナ内パス /app/model/yolov8n.hef |
| 顔検出 | SCRFD-10G | <プロジェクトルート>/models/scrfd_10g.hef | HailoRT の deb パッケージに同梱(models/ にコピー可) |
| 顔埋め込み | ArcFace MobileFaceNet | <プロジェクトルート>/models/arcface_mobilefacenet.hef | HailoRT の deb パッケージに同梱(models/ にコピー可) |
2.5.1 SCRFD + ArcFace を入手する(最も簡単)
SCRFD-10G と ArcFace MobileFaceNet の HEF は Hailo 公式の事前コンパイル済みモデルで、hailort の deb パッケージにより /usr/local/hailo/resources/models/hailo8/ にインストールされます — そのまま本プロジェクトの models/ にコピーしてください:
sudo apt install hailort
ls /usr/local/hailo/resources/models/hailo8/
# 以下のようなファイルが見えるはずです:
#   arcface_mobilefacenet.hef
#   scrfd_10g.hef
#   その他いくつかの公式サンプルモデル

# プロジェクトのローカル models/ ディレクトリへコピー
cp /usr/local/hailo/resources/models/hailo8/scrfd_10g.hef            models/
cp /usr/local/hailo/resources/models/hailo8/arcface_mobilefacenet.hef models/
ls -lh models/
2.5.2 YOLOv8n を入手する
https://sensecraft.seeed.cc/ai-lab/en/models/yolov8/hailo-8 を参照してください。YOLOv8n の HEF は ghcr.io/seeed-projects/recomputer-r20-cv/yolov8:latest に同梱されています。コンテナ内パスは /app/model/yolov8n.hef です。
mkdir -p models

# 1. 公式イメージを取得
docker pull ghcr.io/seeed-projects/recomputer-r20-cv/yolov8:latest

# 2. 実行しないコンテナインスタンスを create で作成(ファイルを取り出すためだけ)
docker create --name yolov8-temp ghcr.io/seeed-projects/recomputer-r20-cv/yolov8:latest

# 3. コンテナから yolov8n.hef をプロジェクトの models/ にコピー
docker cp yolov8-temp:/app/model/yolov8n.hef models/yolov8n.hef

# 4. 一時コンテナを削除
docker rm yolov8-temp

# 5. 確認
ls -lh models/yolov8n.hef
2.6 顔アルバムを構築する(中核ステップ)
リポジトリにはデモ動画 data/tex.mp4(約 11 MB)が付属しています。次のコマンドを実行するとアルバムが生成されます:
python apps/build_album.py \
  --video data/tex.mp4 \
  --out data/album \
  --no-tracker \
  --scrfd-score 0.6 \
  --cluster-thresh 0.85 \
  --skip-dedup
パラメータ:
| パラメータ | 値 | 説明 |
|---|---|---|
--video | data/tex.mp4 | 入力動画。複数指定可、カンマ区切りも可 |
--out | data/album | アルバムの出力ディレクトリ |
--no-tracker | flag | IoU tracker をオフにし、毎フレーム・各顔をサンプリング(短尺サンプル動画向け) |
--scrfd-score | 0.6 | SCRFD 顔検出の信頼度しきい値(既定 0.60) |
--cluster-thresh | 0.85 | 緩やかなクラスタリング:コサイン距離のしきい値。詳細は 4.2 節 |
--skip-dedup | flag | 書き出し時の pHash / embedding 二重重複排除をスキップ(pHash 優先のクラスタリングは維持) |
ビルド完了後、data/album/ 配下に以下が現れます:
data/album/
├── manifest.json
├── thumbnails/
│   ├── person_0001.jpg
│   ├── person_0002.jpg
│   └── ...
├── person_0001/
│   ├── representative.jpg
│   ├── info.json
│   ├── embeddings.npz
│   └── img_0001_ts_2.00s_score_0.78.jpg
│   └── img_0002_ts_5.00s_score_0.74.jpg
│   └── ...
├── person_0002/
└── ...
2.7 Web アルバム閲覧サービスを開始する
ビルド完了後、もう一つターミナルを開き、ミニマルな Web サービスを起動します:
python apps/web_browser.py --port 8080ブラウザで http://<reComputer-IP>:8080/ にアクセスします:
- 上部の統計バーに総人数・総画像数・ソース動画数が表示されます;
- メインのグリッドは「1 画像 = 1 人」の原則でサムネイルを一覧します(
representative.jpg由来、画像数の降順); - 人物をクリックすると、その人物の
img_*.jpgを一覧する詳細ページが開きます; - 画像をクリックすると、全画面のビューアがポップアップします。
3. 生成物の読み方
3.1 データディレクトリの構造
data/album/
├── manifest.json                    # 全体統計 + 人物一覧(Web UI のデータソース)
├── thumbnails/
│   └── person_<id>.jpg              # サムネイル(representative.jpg のコピー)
└── person_<NNNN>/                   # アイデンティティごとに 1 ディレクトリ、NNNN は 4 桁ゼロパディング ID
    ├── info.json                    # 1 人あたりのメタデータ: count / first_ts / last_ts / best_score / source_videos
    ├── embeddings.npz               # その person の top-N 埋め込み(既定 N=5、スコア順)
    ├── representative.jpg           # 最高スコアの「表紙画像」、thumbnails/ にも同期
    └── img_<NNNN>_ts_<ts>s_score_<score>.jpg  # 残した顔画像(112×112 アライメント後)
ファイル命名規則の例:
person_0001/img_0001_ts_2.00s_score_0.78.jpg:1 枚目、2.00 秒、SCRFD スコア = 0.78person_0001/img_0014_ts_18.50s_score_0.82.jpg:14 枚目、18.50 秒
3.2 manifest.json の主要フィールド
{
  "version": "1.0",
  "created_at": "2026-09-26T10:23:11",
  "updated_at": "2026-09-26T10:24:48",
  "total_persons": 6,
  "total_images": 142,
  "source_videos": ["tex"],
  "config": {
    "interval_s": 1.0,
    "cosine_distance_threshold": 0.85,
    "min_face_size": [40, 40],
    "min_face_score": 0.6,
    "best_n_embeddings": 5,
    "phash_max_dist": 4
  },
  "persons": [
    {
      "id": 1,
      "count": 28,
      "first_ts": 2.0,
      "last_ts": 82.0,
      "best_score": 0.85,
      "source_videos": ["tex"],
      "thumbnail": "thumbnails/person_0001.jpg"
    },
    ...
  ]
}
フィールドの意味:
| フィールド | 意味 |
|---|---|
total_persons | クラスタリングされた人物の総数(インクリメンタルビルドでは単調増加) |
total_images | 全顔画像の総数(重複排除後) |
config | 本ビルドのパラメータスナップショット(追跡用としてアルバムに書き戻される) |
persons[].count | その person の顔画像数 |
persons[].first_ts / last_ts | 初回 / 最終出現のタイムスタンプ(秒) |
persons[].best_score | 最高の SCRFD 検出スコア |
3.3 Web UI のインタラクション
Web フロントエンドは素の http.server + 静的 HTML/CSS/JS のみで、データベースは使いません。すべてのデータは manifest.json とファイルシステムからリアルタイムに読み込みます。
主なインタラクションの流れ:
- ホーム (
/):/manifest.jsonを取得し、countの降順で全人物のサムネイルを一覧表示します; - 人物詳細を開く:サムネイルをクリック → バックエンドが
person_<id>/img_*.jpgを glob → 全画像を一覧; - 画像プレビュー:画像をクリック →
<dialog>の全画面モーダル; - 再読み込み:上部の
↻をクリックでmanifest.jsonを再取得。