reComputer RK3576 での YOLO11 量子化比較
YOLO11n を ONNX から RKNN に変換し、reComputer RK3576 上で FP16、INT8、W4A16 の モデルサイズ、推論速度、実行時メモリ、COCO 精度を比較します。
reComputer RK3576 での YOLO11 量子化比較
コンピュータービジョンモデルは Rockchip ハードウェア上で本当に 4 ビット精度で動作するのでしょうか。RK3576 だけが 4 ビットモデルに対応しているのでしょうか。また、モデルが小さければ必ず高速になるのでしょうか。
このプロジェクトでは、同じ YOLO11n ONNX モデルを FP16、INT8、W4A16 の RKNN モデルに変換し、reComputer RK3576 上で共通の再現可能な手順により評価します。
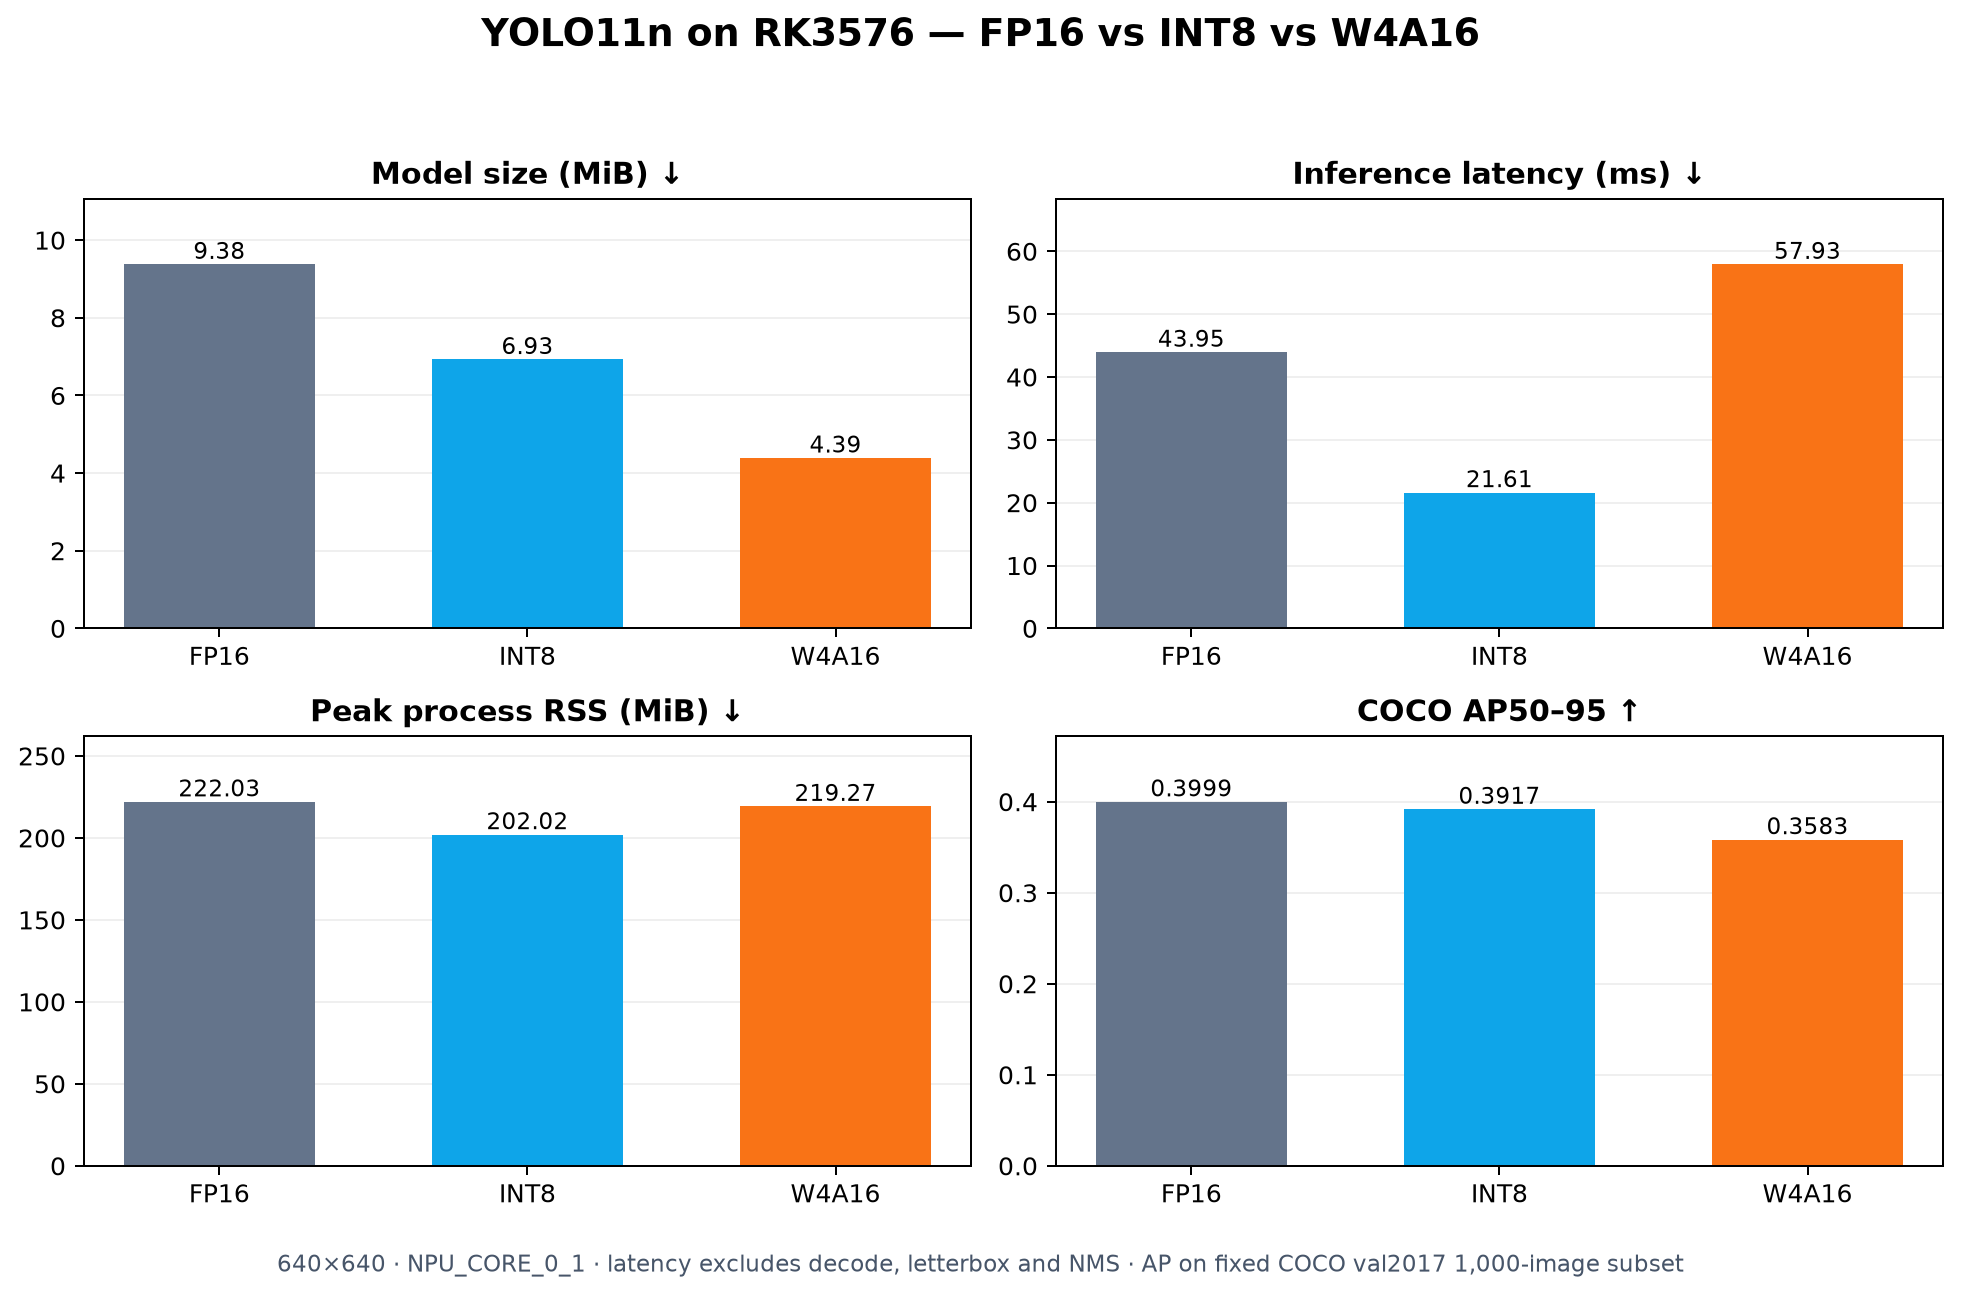
結果は単純に「ビット数が少ないほど良い」とはなりませんでした。W4A16 は最小のモデルファイルを生成しましたが、速度と精度のバランスは INT8 が最良でした。
RK3576 における 4 ビットの意味
W4A16 の W は重みの精度、A はアクティベーションの精度を表します。
| 形式 | 重み | アクティベーション | 一般的な説明 |
|---|---|---|---|
| FP16 | 16 ビット浮動小数点 | 16 ビット浮動小数点 | 半精度 |
| W8A8 | 8 ビット整数 | 8 ビット整数 | INT8 量子化 |
| W4A16 | 4 ビット整数 | 16 ビット浮動小数点 | 4 ビット重み量子化 |
| W4A4 | 4 ビット整数 | 4 ビット整数 | 完全または純粋な INT4 |
W4A16 は重みを 4 ビットで保存し、アクティベーションを 16 ビットのまま保持します。つまり 4 ビットの重み量子化モデルであり、完全な W4A4 ネットワークではありません。
この違いはコンピュータービジョンで重要です。重みは固定されており、展開前にオフライン解析できますが、アクティベーションは入力画像ごとに変化します。検出ヘッド、小物体の特徴、信頼度、バウンディングボックス回帰はアクティベーションの量子化ノイズに敏感です。16 ビットを維持すればリスクを抑えられますが、実行時メモリはモデルファイルほど小さくなりません。
RKNN-Toolkit2 の変更履歴には、RK3576 向け W4A16 対称量子化が明記されています。ただし、これは「INT4 演算が可能な Rockchip SoC は RK3576 だけ」という意味ではありません。他のチップが特定の低ビット演算を備えていても、ここで利用する完全な RKNN W4A16 CV 変換フローと同じとは限りません。
ハードウェアとソフトウェア
- ボード:reComputer RK3576、8 GB
- OS:Debian 12 / Armbian
- カーネル:
6.1.115-vendor-seeed-rk3576 - RKNN-Toolkit2:2.3.2
- RKNN-Toolkit-Lite2:2.3.2
- RKNN Runtime:2.3.0
- RKNPU ドライバー:0.9.8
- モデル:Rockchip Model Zoo の最適化済み YOLO11n ONNX
- 入力:640 × 640 RGB
- キャリブレーション:INT8 と W4A16 で共通の固定 COCO val2017 画像 20 枚
- 精度評価:固定した COCO val2017 の 1,000 枚、乱数シード 3576
変換手順
YOLO11n ONNX
      +-- FP16 RKNN ------------------------+
      +-- INT8/W8A8 + calibration ---------+--> RK3576 NPU --> benchmark
      +-- W4A16 + GDQ + group128 ----------+
1. RKNN-Toolkit2 をインストールする
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
  rknn-toolkit2==2.3.2 \
  rknn-toolkit-lite2==2.3.2 \
  numpy==1.26.4 onnx==1.16.1 \
  onnxruntime opencv-python pycocotools psutil
2. 代表的なキャリブレーションデータを用意する
画像パスを 1 行に 1 つ記載した dataset.txt を作成します。
./calibration/000000000139.jpg
./calibration/000000000285.jpg
./calibration/000000000632.jpg
実際の利用環境を代表する画像を選んでください。量子化設定を比較するときは、ONNX モデルとキャリブレーションセットを統一します。
3. FP16 ベースラインを作成する
from rknn.api import RKNN

rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("yolo11n_fp16.rknn")
この設定では、RKNN ランタイムが uint8 RGB 入力を受け取り、0–255 から 0–1 に正規化します。アプリケーション側でもう一度 255 で割らないでください。
4. INT8/W8A8 をビルドする
同じ前処理設定に次の項目を追加します。
quantized_dtype="w8a8"
quantized_algorithm="normal"
quantized_method="channel"
キャリブレーションを有効にしてモデルをビルドします。
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_int8.rknn")
5. W4A16 をビルドする
基本的な w4a16 + normal + channel はビルドと実行に成功しましたが、精度が大幅に低下しました。今回最も良かった設定は GDQ + group128 です。
rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    quantized_dtype="w4a16",
    quantized_algorithm="gdq",
    quantized_method="group128",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_w4a16_gdq_group128.rknn")
通常の W4A16 変換は約 27 秒、GDQ-group128 は約 641 秒かかりました。これはオフライン変換時だけのコストで、推論時には発生しません。
group128 がすべてのモデルに最適とは限りません。独自の検証データで channel 量子化、複数の group サイズ、GDQ を比較してください。
RK3576 でモデルを実行する
import cv2
import numpy as np
from rknnlite.api import RKNNLite

runtime = RKNNLite()
runtime.load_rknn("yolo11n_w4a16_gdq_group128.rknn")
runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)

image = cv2.imread("test.jpg")
image = cv2.resize(image, (640, 640))
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
outputs = runtime.inference(
    inputs=[image[np.newaxis, ...].astype(np.uint8)]
)

runtime.release()
この最小例はモデルが起動することだけを確認します。本番の YOLO11 推論では、一致した letterbox 前処理、DFL デコード、クラスフィルタリング、NMS、座標復元が必要です。
ベンチマーク手順
性能測定では、各モデルで NPU_CORE_0_1 を使用し、50 回のウォームアップ後に 500 回の推論を測定しました。モデル順を入れ替えながら全工程を 3 回繰り返しました。レイテンシは RKNNLite の inference() 呼び出しのみで、画像読み込み、letterbox、NMS は含みません。
精度評価では、全モデルに同じ COCO 画像 1,000 枚、letterbox 設定、信頼度しきい値 0.001、NMS しきい値 0.65、COCOeval 設定を使用しました。
実際の推論画像の比較
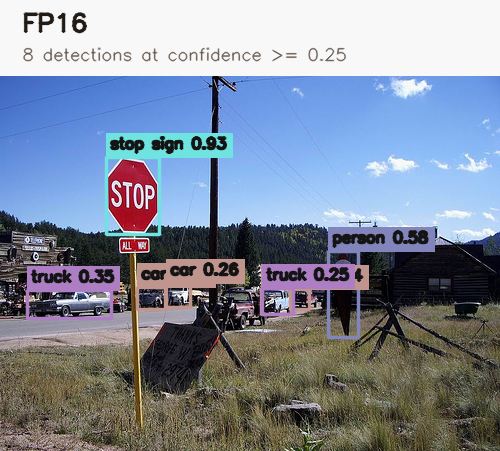
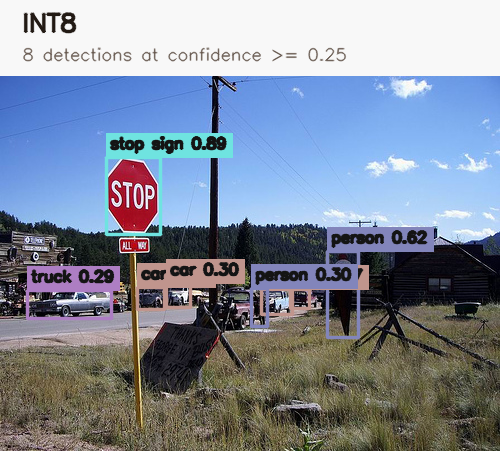
以下は同じ COCO val2017 画像(000000222094.jpg)と、正式な 1,000 画像評価で保存した予測を使用しています。見やすくするため、信頼度 0.25 以上の検出だけを描画し、NMS しきい値は 0.65 のままです。
FP16 — 8 件の検出
INT8 — 8 件の検出
W4A16 GDQ-group128 — 2 件の検出
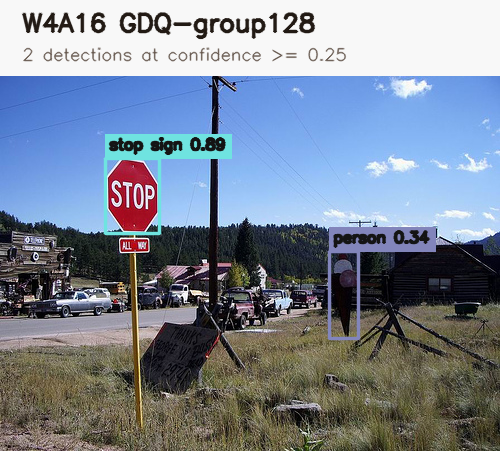
この画像は量子化による違いが分かりやすいため選びました。あくまで視覚的な例であり、以下の COCO AP 集計結果に代わるものではありません。
結果
| 精度 | モデルサイズ | 平均レイテンシ | スループット | ピーク RSS | AP50–95 |
|---|---|---|---|---|---|
| FP16 | 9.38 MiB | 43.95 ms | 22.76 FPS | 222.03 MiB | 0.3999 |
| INT8 | 6.93 MiB | 21.61 ms | 46.36 FPS | 202.02 MiB | 0.3917 |
| W4A16 GDQ-group128 | 4.39 MiB | 57.93 ms | 17.30 FPS | 219.27 MiB | 0.3583 |
INT8 のスループットは FP16 の約 2.04 倍で、AP の低下は 0.82 ポイントだけでした。
W4A16 は RKNN ファイルを FP16 の 46.8% に縮小しましたが、スループットは FP16 より 24.0%、INT8 より 62.7% 低く、AP50–95 は FP16 より 4.16 ポイント低下しました。
最初の normal + channel W4A16 モデルは正常な形状のテンソルを返したものの、AP50–95 は 0.0121 でした。GDQ-group128 では 0.3583 まで回復し、変換成功だけでは検証の代わりにならないことが分かります。
どの精度を選ぶべきか
- FP16:信頼できる展開と精度の基準を作る場合。
- INT8:スループットと精度のバランスを重視する場合。
- W4A16:モデル保存容量または重み帯域幅が主な制約の場合。
今回の YOLO11n では、総合的に INT8 が最良でした。W4A16 は重み圧縮には有効ですが、自動的な高速化にはなりません。