Vision Story Studio convierte imágenes en textos creativos mediante un modelo de visión y lenguaje local. En un reComputer RK3576 con acelerador RK1820, sube una imagen, elige un estilo y observa cómo la respuesta aparece progresivamente en el navegador. El modelo del proyecto es Qwen2.5-VL-3B_prune; mientras funciona el servicio local, la imagen y el prompt se procesan en el dispositivo.
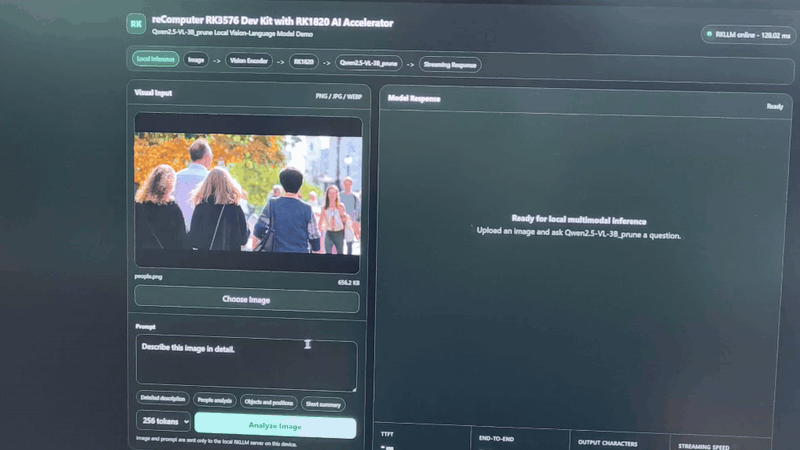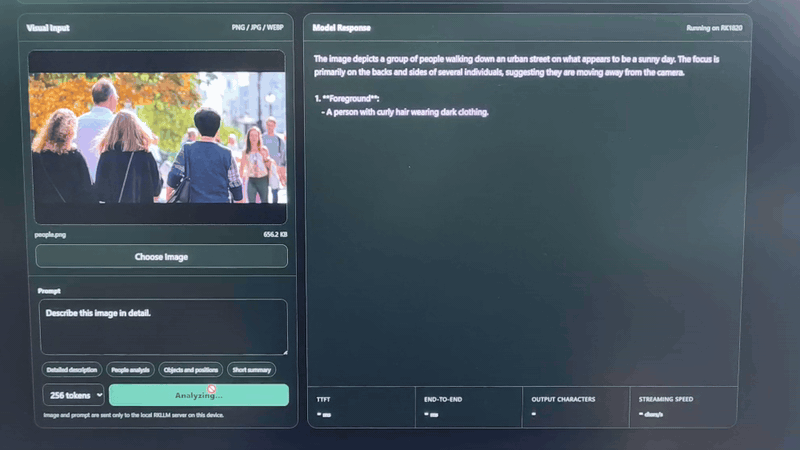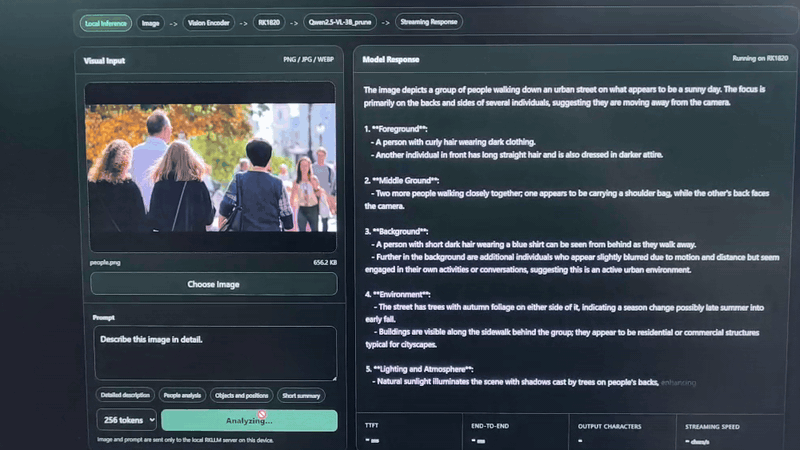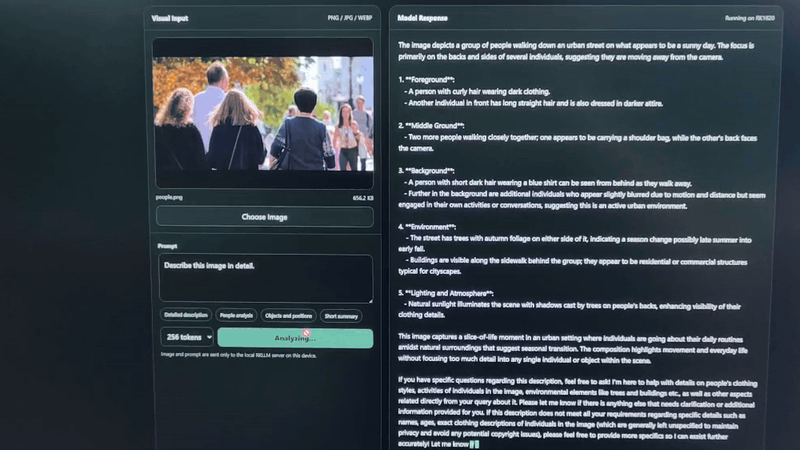
El vídeo muestra una demostración relacionada de comprensión de imágenes con RK1820 y Qwen2.5-VL-3B_prune: se carga una imagen y la respuesta aparece poco a poco. Vision Story Studio utiliza la misma combinación de hardware y modelo para sus opciones de escritura creativa.
Qué se puede crear
Sube una imagen JPG, PNG o WEBP y selecciona una de las opciones incluidas:
- una postal inspirada en la imagen;
- un relato breve;
- una descripción de la escena; o
- una colección de prompts creativos.
También puedes editar el prompt antes de pulsar Create Story. La respuesta se transmite desde el modelo local al navegador.
Hardware y archivos del modelo
- reComputer RK3576 con un módulo RK1820 instalado y reconocido.
- Runtime RKNN3/RKLLM compatible, con
rkllm3-serverdisponible en el dispositivo. - Python 3 y
venvpara la interfaz FastAPI; sus dependencias figuran en elrequirements.txtdel proyecto. - Paquete Qwen2.5-VL-3B_prune obtenido por separado. El archivo de distribución independiente del proyecto no incluye los binarios del modelo.
El script de inicio espera estos archivos en MODEL_DIR:
llm_Qwen2.5-VL-3B_prune.rknn
llm_Qwen2.5-VL-3B_prune.weight
vision_Qwen2.5-VL-3B_prune.rknn
vision_Qwen2.5-VL-3B_prune.weight
Qwen2.5-VL-3B_prune.tokenizer.gguf
Qwen2.5-VL-3B_prune.embed.bin
Comprueba que el paquete del modelo y el runtime del dispositivo sean compatibles antes de iniciar el servicio.
Ejecutar el estudio
Clona el repositorio y entra en el directorio del proyecto:
git clone https://github.com/Seeed-Projects/Lab-Prooject-RK.git
cd Lab-Prooject-RK/projects/rk1820-vlm-creative
chmod +x *.sh
En la primera terminal, indica la carpeta del modelo e inicia el servicio VLM:
MODEL_DIR=/path/to/Qwen2.5-VL-3B_prune ./start_vlm_server.shMantén esa terminal abierta. En otra terminal, entra en el mismo directorio e inicia la interfaz web:
./start_ui.shAbre http://<RK3576-IP>:7861 desde un navegador de la misma red. La interfaz se conecta por defecto al servicio de modelos en http://127.0.0.1:8080. En la primera ejecución, start_ui.sh crea un entorno virtual e instala las dependencias de Python; si no están en caché, el dispositivo debe poder obtener esos paquetes.
Notas
El repositorio del proyecto contiene el código y los scripts de inicio. Mantén la interfaz en una red local de confianza o añade controles de acceso antes de exponerla a otras redes. El paquete del modelo y un runtime compatible se preparan por separado.