Una interfaz de voz útil debe sentirse como una conversación, no como una grabación que tiene que terminar antes de que puedas volver a hablar. Este proyecto crea un terminal de voz en el borde que escucha, responde por un altavoz y detiene su respuesta en cuanto el usuario empieza a hablar mientras se reproduce.
El reconocimiento y la síntesis de voz se ejecutan en el dispositivo. El modelo de conversación puede ser un servicio en la nube compatible con OpenAI o un modelo local, según el hardware y los requisitos de privacidad. Así, el mismo proyecto sirve para mostradores de atención, exposiciones, quioscos, terminales de habitaciones inteligentes e interfaces de voz para robots.
¿Qué distingue a este proyecto?
La función clave es la interrupción de la respuesta: el micrófono sigue capturando audio procesado mientras el altavoz reproduce la respuesta. Cuando el sistema detecta una nueva intervención, interrumpe la reproducción y empieza a escuchar la siguiente petición.
Este comportamiento depende de una matriz de micrófonos con cancelación de eco acústico (AEC) por hardware. Sin AEC, el sonido del altavoz puede volver a entrar por el micrófono y confundirse con la voz del usuario. reSpeaker XVF3800 es la opción predeterminada validada porque ofrece un canal de captura USB con procesamiento AEC.
El proyecto también mantiene el procesamiento de voz cerca del usuario:
- El reconocimiento automático de voz (ASR) se ejecuta en el equipo de voz.
- La conversión de texto a voz (TTS) se ejecuta en el equipo de voz.
- Un agente de voz residente gestiona la escucha, las interrupciones, la conversación y la reproducción.
- Solo la petición de conversación tiene que salir del dispositivo cuando se selecciona un LLM en la nube.
- Una configuración totalmente local permite mantener el procesamiento de voz y conversación en las instalaciones.
Cómo funciona el sistema
La matriz de micrófonos envía audio procesado con AEC al equipo de voz mediante USB. El equipo detecta el habla, la convierte en texto, envía ese texto al modelo de conversación seleccionado y convierte la respuesta en audio, que se reproduce por el altavoz conectado a la salida de 3.5 mm del reSpeaker.
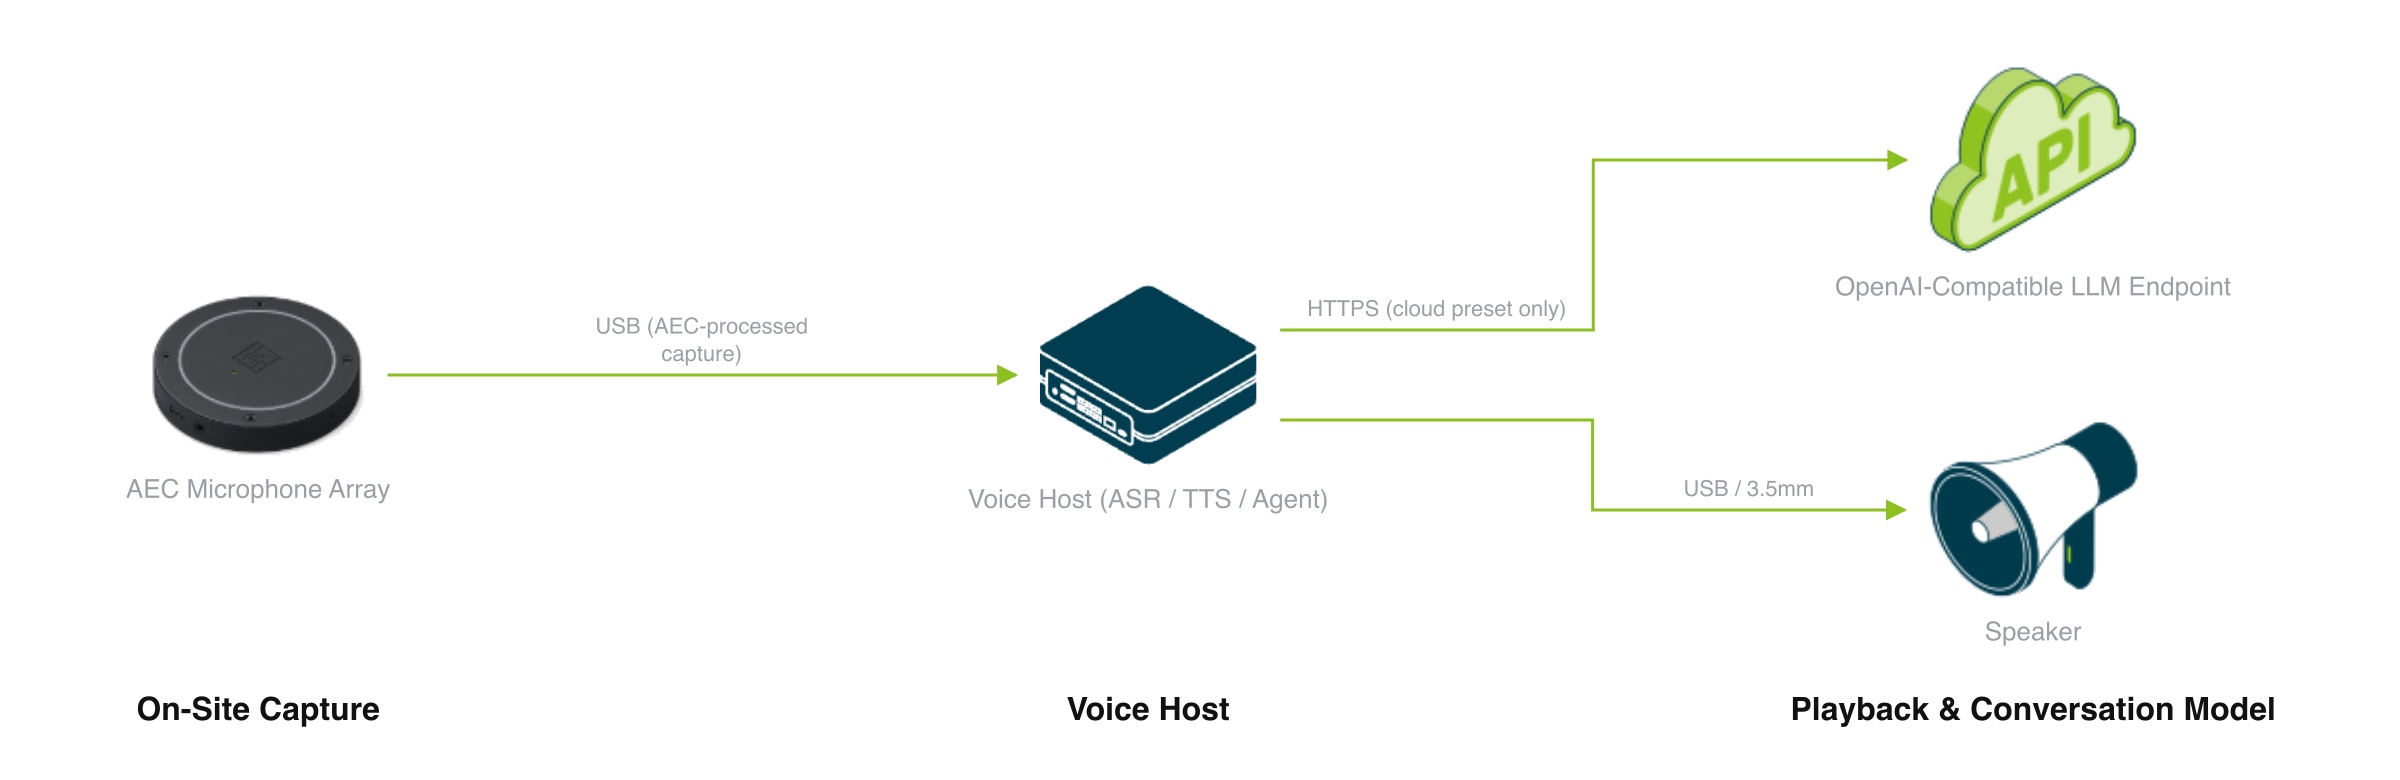
El diagrama muestra el flujo lógico del audio. Para la configuración de esta guía, conecta el altavoz a la salida de 3.5 mm del reSpeaker XVF3800.
| Etapa | Función |
|---|---|
| Captura local | Una matriz de micrófonos USB captura la voz y elimina por hardware el eco de la reproducción. |
| Equipo de voz | El reComputer ejecuta ASR, TTS, detección de actividad de voz y el agente conversacional. |
| Modelo de conversación | Un servicio compatible con OpenAI o un LLM local genera la respuesta. |
| Reproducción | Un altavoz conectado a la salida de 3.5 mm del reSpeaker XVF3800 reproduce la respuesta sintetizada. |
| Interrupción | Una nueva intervención del usuario interrumpe la respuesta actual e inicia otro turno. |
La implementación de código abierto está disponible en OpenVoiceStream. Proporciona motores de voz específicos para cada dispositivo y mantiene coherentes la aplicación conversacional y las interfaces de servicio entre los equipos compatibles.
Elige una opción de despliegue
LLM en la nube o compatible con OpenAI
Es la opción más sencilla para la mayoría de los despliegues. ASR y TTS permanecen en el equipo de voz, mientras que el texto reconocido se envía a Qwen API o a otro servicio compatible con OpenAI. Durante el despliegue, proporcionas la URL base, la clave API y el ID del modelo.
Elige esta opción si quieres una amplia selección de modelos, no necesitas mantener todo el texto de la conversación en las instalaciones o tu equipo no tiene capacidad suficiente para ejecutar a la vez los servicios de voz y un LLM local.
Conversación totalmente local
Elige una configuración local cuando el audio y el texto de la conversación deban permanecer en el dispositivo, o cuando el terminal tenga que funcionar sin conexión continua a internet. En esta guía, la configuración totalmente local utiliza reComputer RK3588 con un acelerador RK1828/RM182X para Qwen3-4B. No necesita una clave API de la nube.
El primer despliegue sí necesita internet para obtener las imágenes de contenedor y los archivos del modelo. Una vez almacenados en caché, la configuración local puede funcionar sin conexión.
Elige el equipo de voz
Estas son las opciones de SenseCraft Solution que se describen aquí:
| Opción de conversación | Dispositivo | Dónde se ejecuta el modelo de conversación |
|---|---|---|
| LLM en la nube o compatible con OpenAI | reComputer RK3576 | En la nube u otro servicio compatible; ASR y TTS permanecen en el RK3576 |
| LLM en la nube o compatible con OpenAI | reComputer RK3588 | En la nube u otro servicio compatible; ASR y TTS permanecen en el RK3588 |
| Conversación totalmente local | reComputer RK3588 + RK1828/RM182X | En el acelerador local, junto con los servicios de voz del RK3588 |
Selecciona un idioma de conversación compatible con el dispositivo elegido. El idioma se configura durante el despliegue y la aplicación selecciona los modelos de voz correspondientes.
Qué necesitas
Hardware
- Un reComputer RK3576 o RK3588 para la opción en la nube, o un RK3588 con una tarjeta RK1828/RM182X para la opción totalmente local.
- Una matriz de micrófonos USB con un canal de captura procesado con AEC. reSpeaker XVF3800 es la opción predeterminada validada.
- Un altavoz conectado a la salida de 3.5 mm del reSpeaker XVF3800.
Red y acceso a servicios
- Acceso por red desde el ordenador de despliegue al equipo de voz.
- Acceso a internet durante el primer despliegue para las imágenes y los archivos del modelo.
- Acceso continuo a internet y a la API si se utiliza un modelo de conversación en la nube.
- La URL base, la clave API y el ID del modelo para un servicio personalizado compatible con OpenAI.
Configura el hardware
- Conecta el reSpeaker XVF3800 al reComputer mediante USB.
- Conecta el altavoz a la salida de 3.5 mm del reSpeaker.
- Para la opción totalmente local, instala la tarjeta RK1828/RM182X en el equipo RK3588 y conecta su fuente de alimentación independiente de 12 V.
Consulta los requisitos del dispositivo en el diseño de referencia.
Cómo ejecutarlo
1. Instala y abre SenseCraft Solution
Ve al centro de descargas de SenseCraft, busca SenseCraft Solution y descarga el instalador para el sistema operativo de tu ordenador. Instala y abre la aplicación.
2. Busca la solución de voz con IA
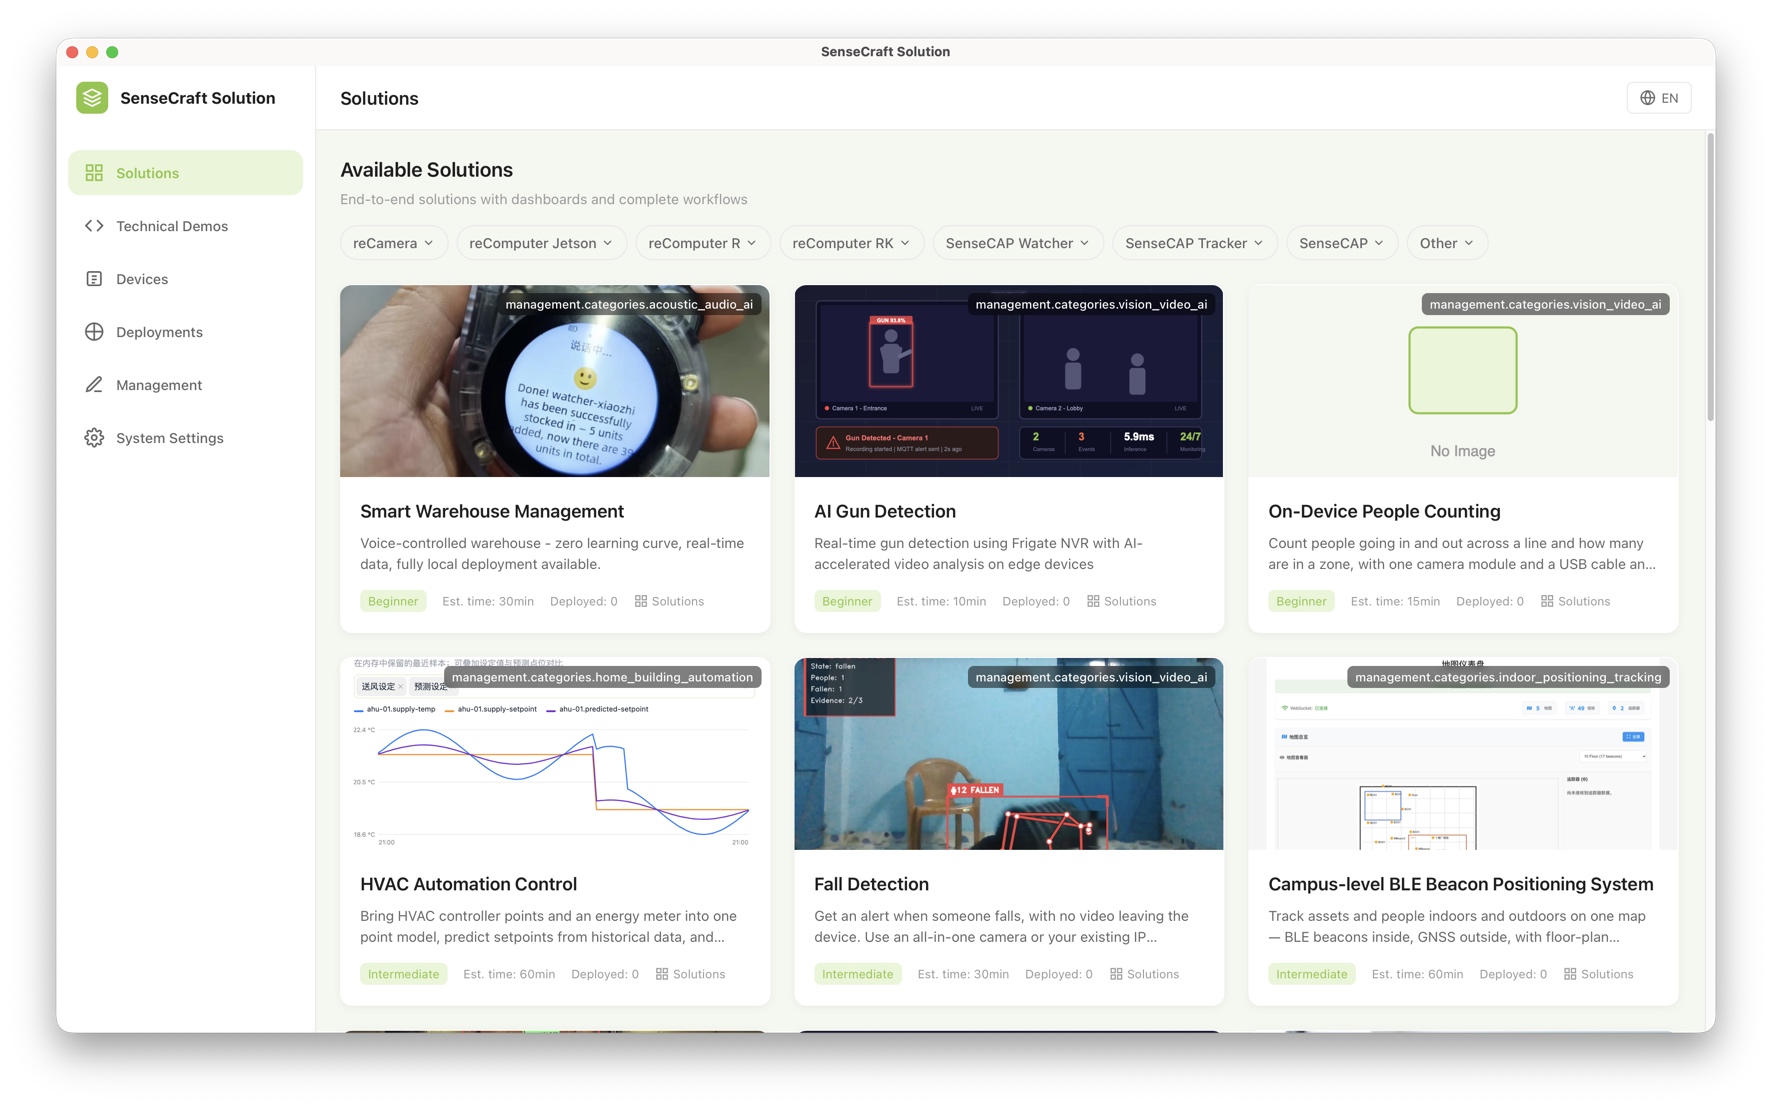
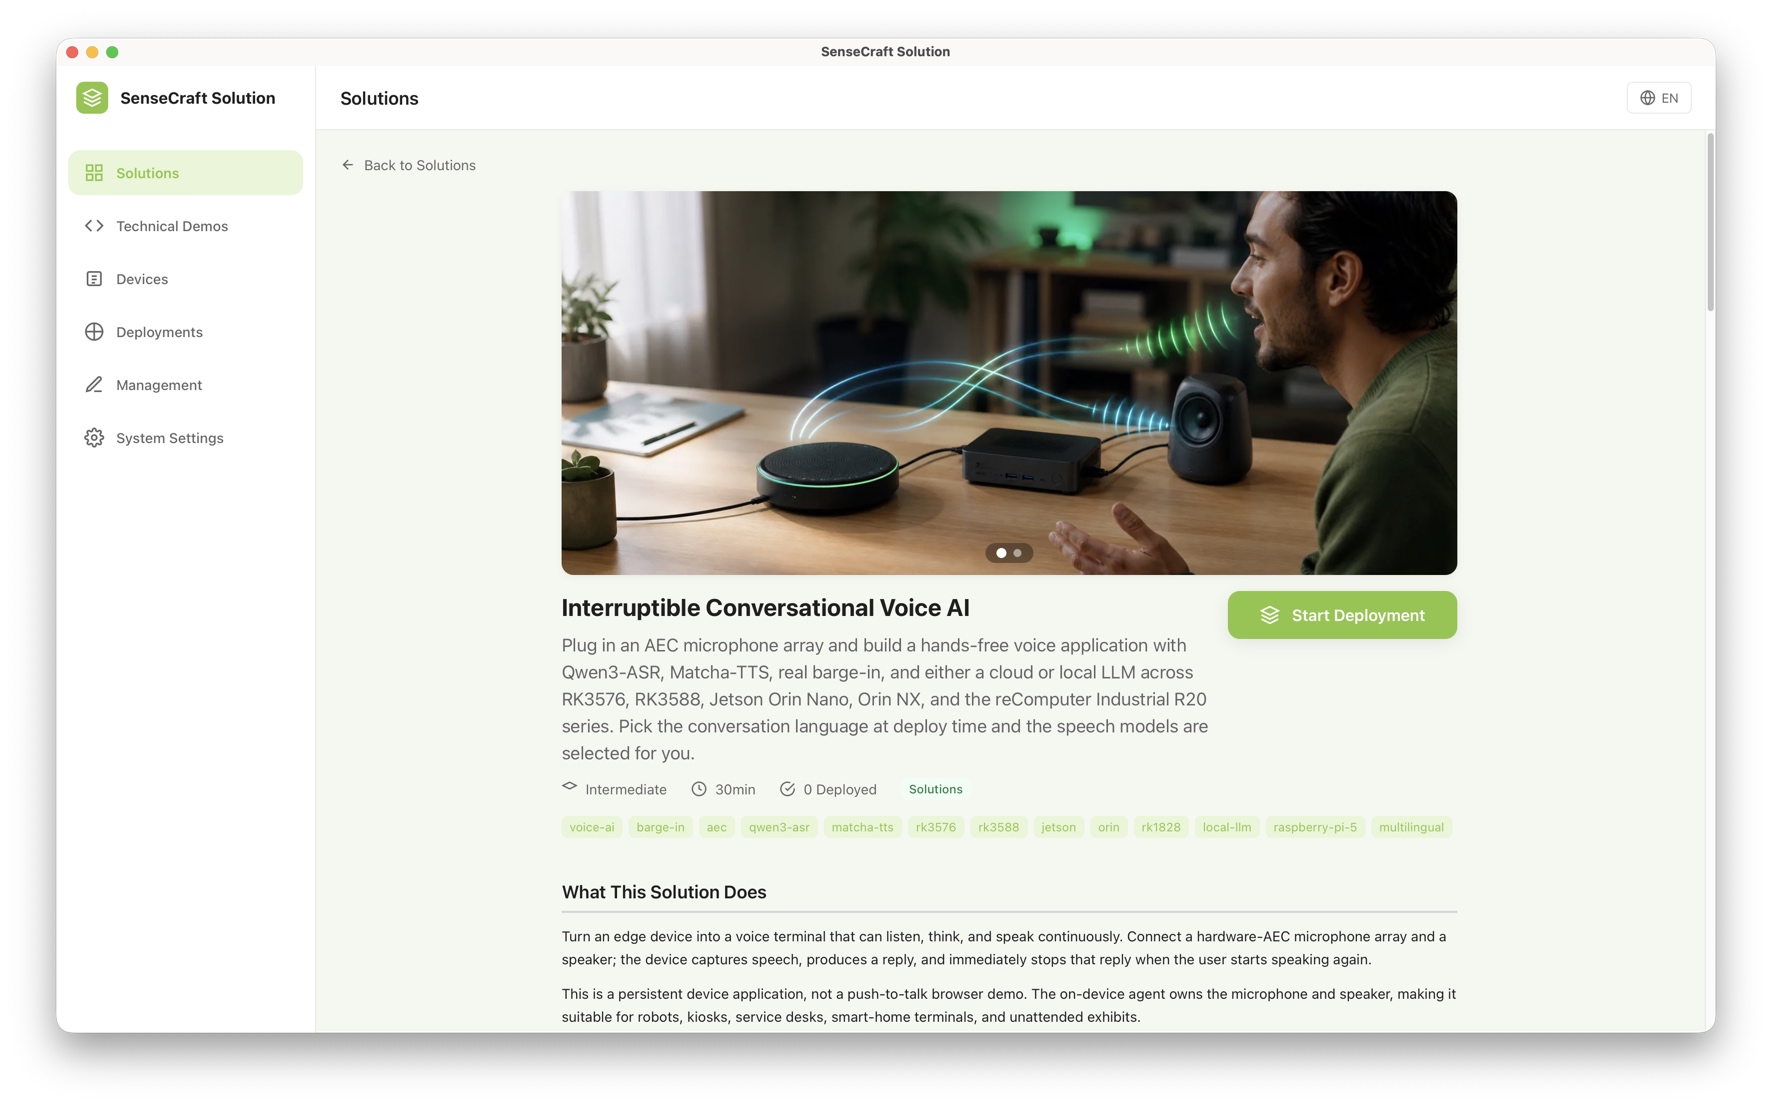
En la página Soluciones, desplázate hasta IA de voz conversacional con interrupciones y abre su tarjeta.
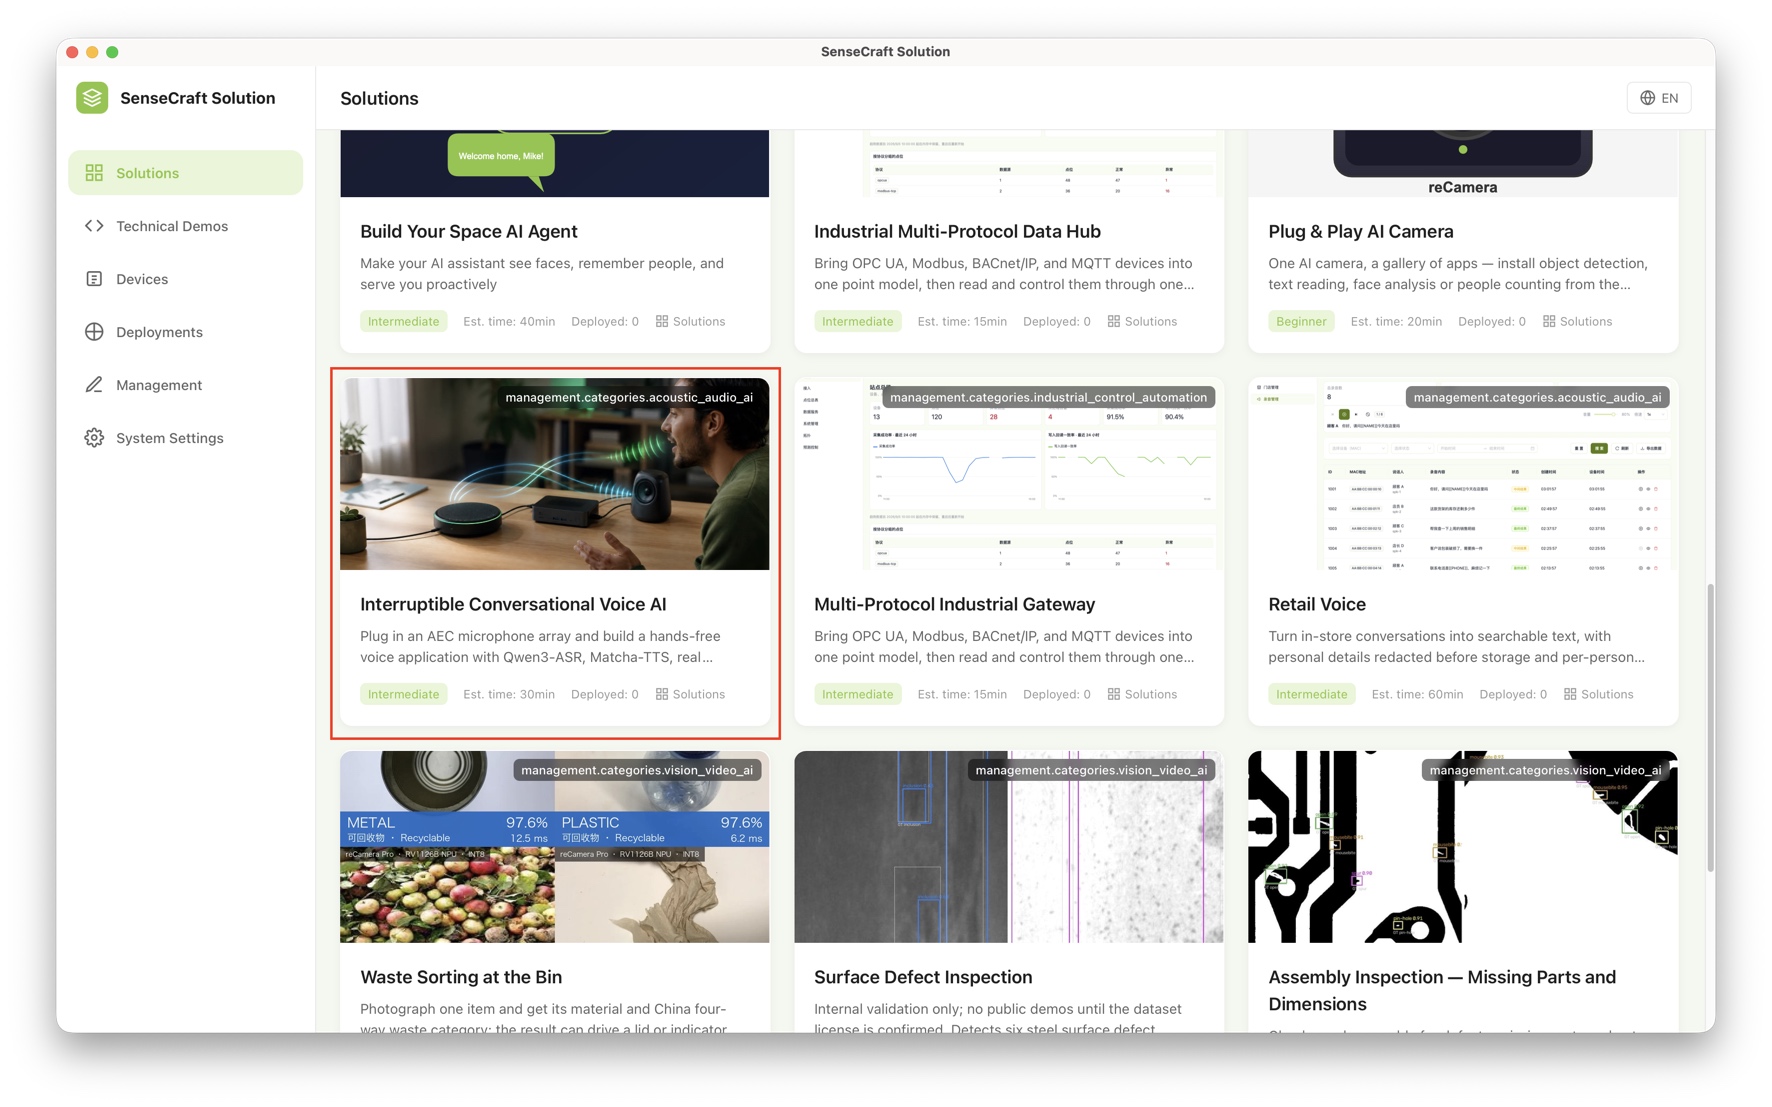
En la página de la solución, haz clic en Iniciar despliegue.
3. Elige el modo de despliegue y el dispositivo
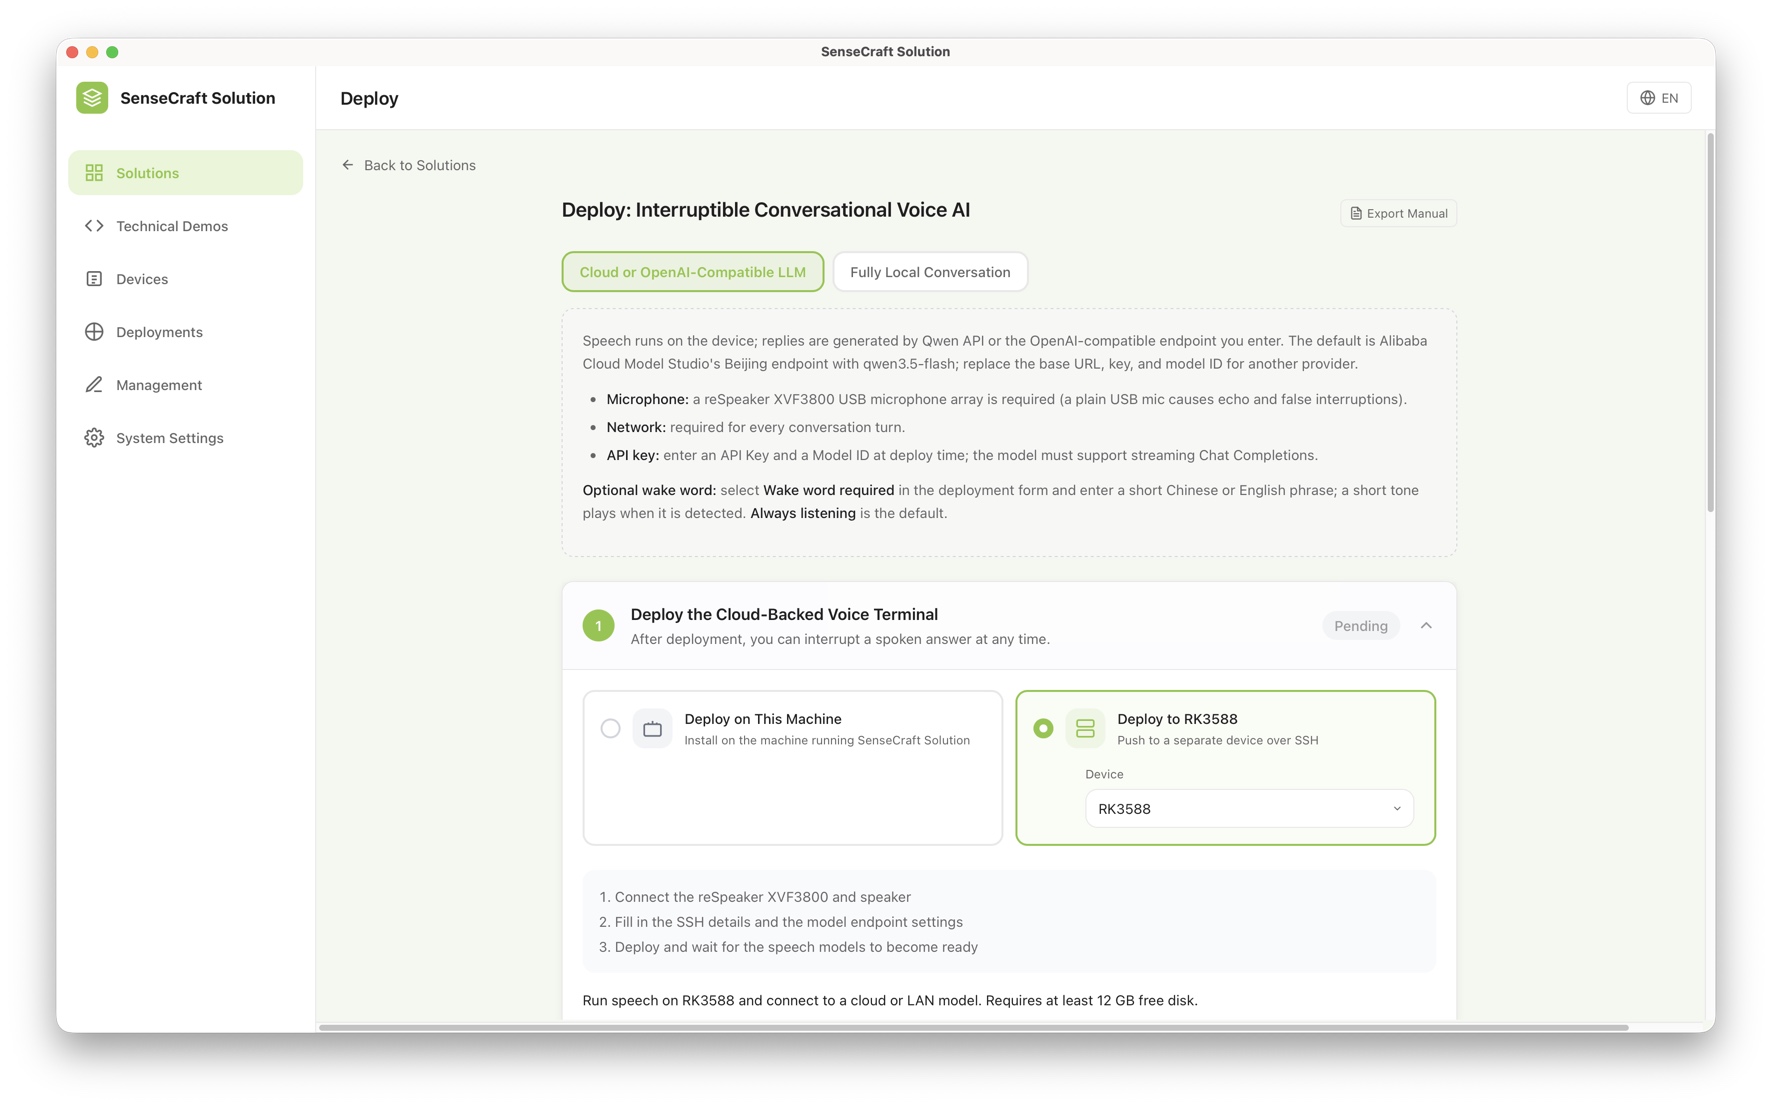
Selecciona LLM en la nube o compatible con OpenAI para reComputer RK3576 o RK3588. Selecciona Conversación totalmente local para reComputer RK3588 con una tarjeta RK1828/RM182X. En el selector de dispositivos, elige el hardware que has conectado.
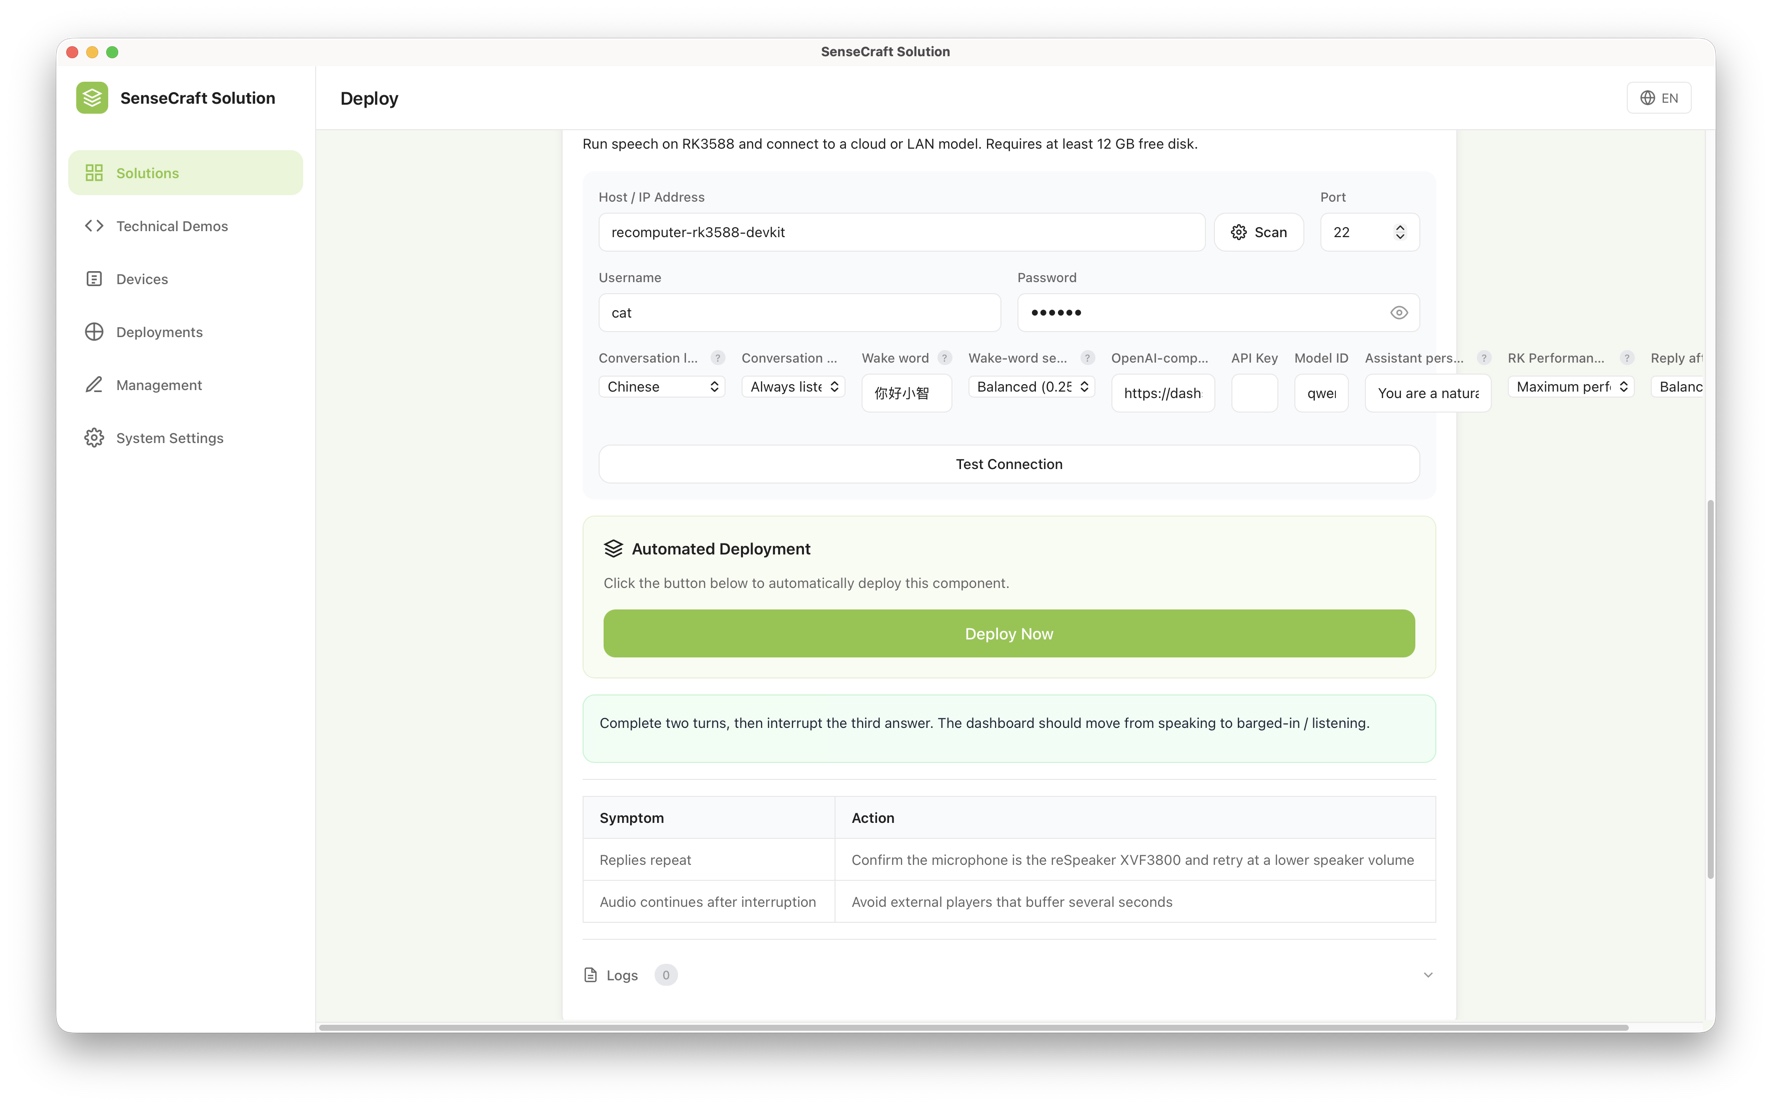
4. Introduce los ajustes de conexión y conversación
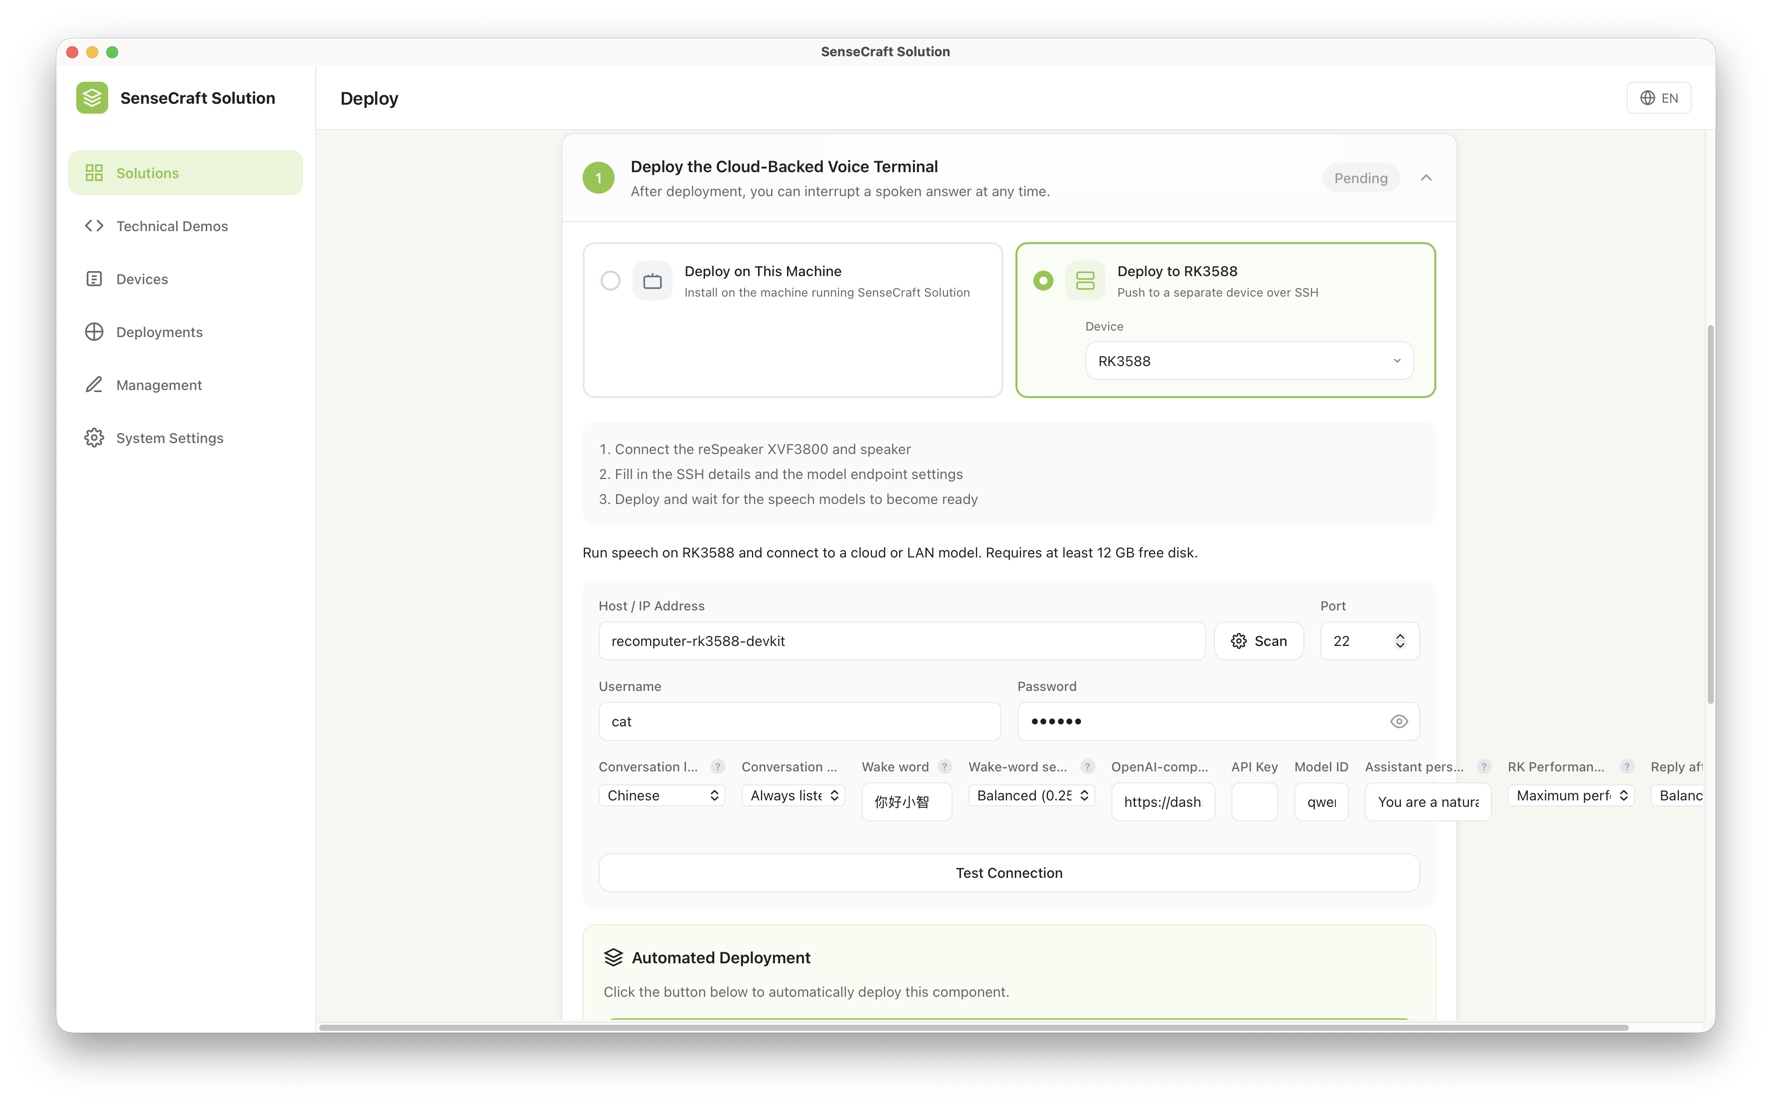
Para un despliegue en la nube, introduce el nombre de host o la dirección IP del equipo de voz, el usuario y la contraseña SSH y el idioma de conversación. Introduce la clave API de tu modelo. Si usas un proveedor personalizado compatible con OpenAI, comprueba también la URL base y el ID del modelo. Usa Probar conexión para comprobar el acceso al equipo.
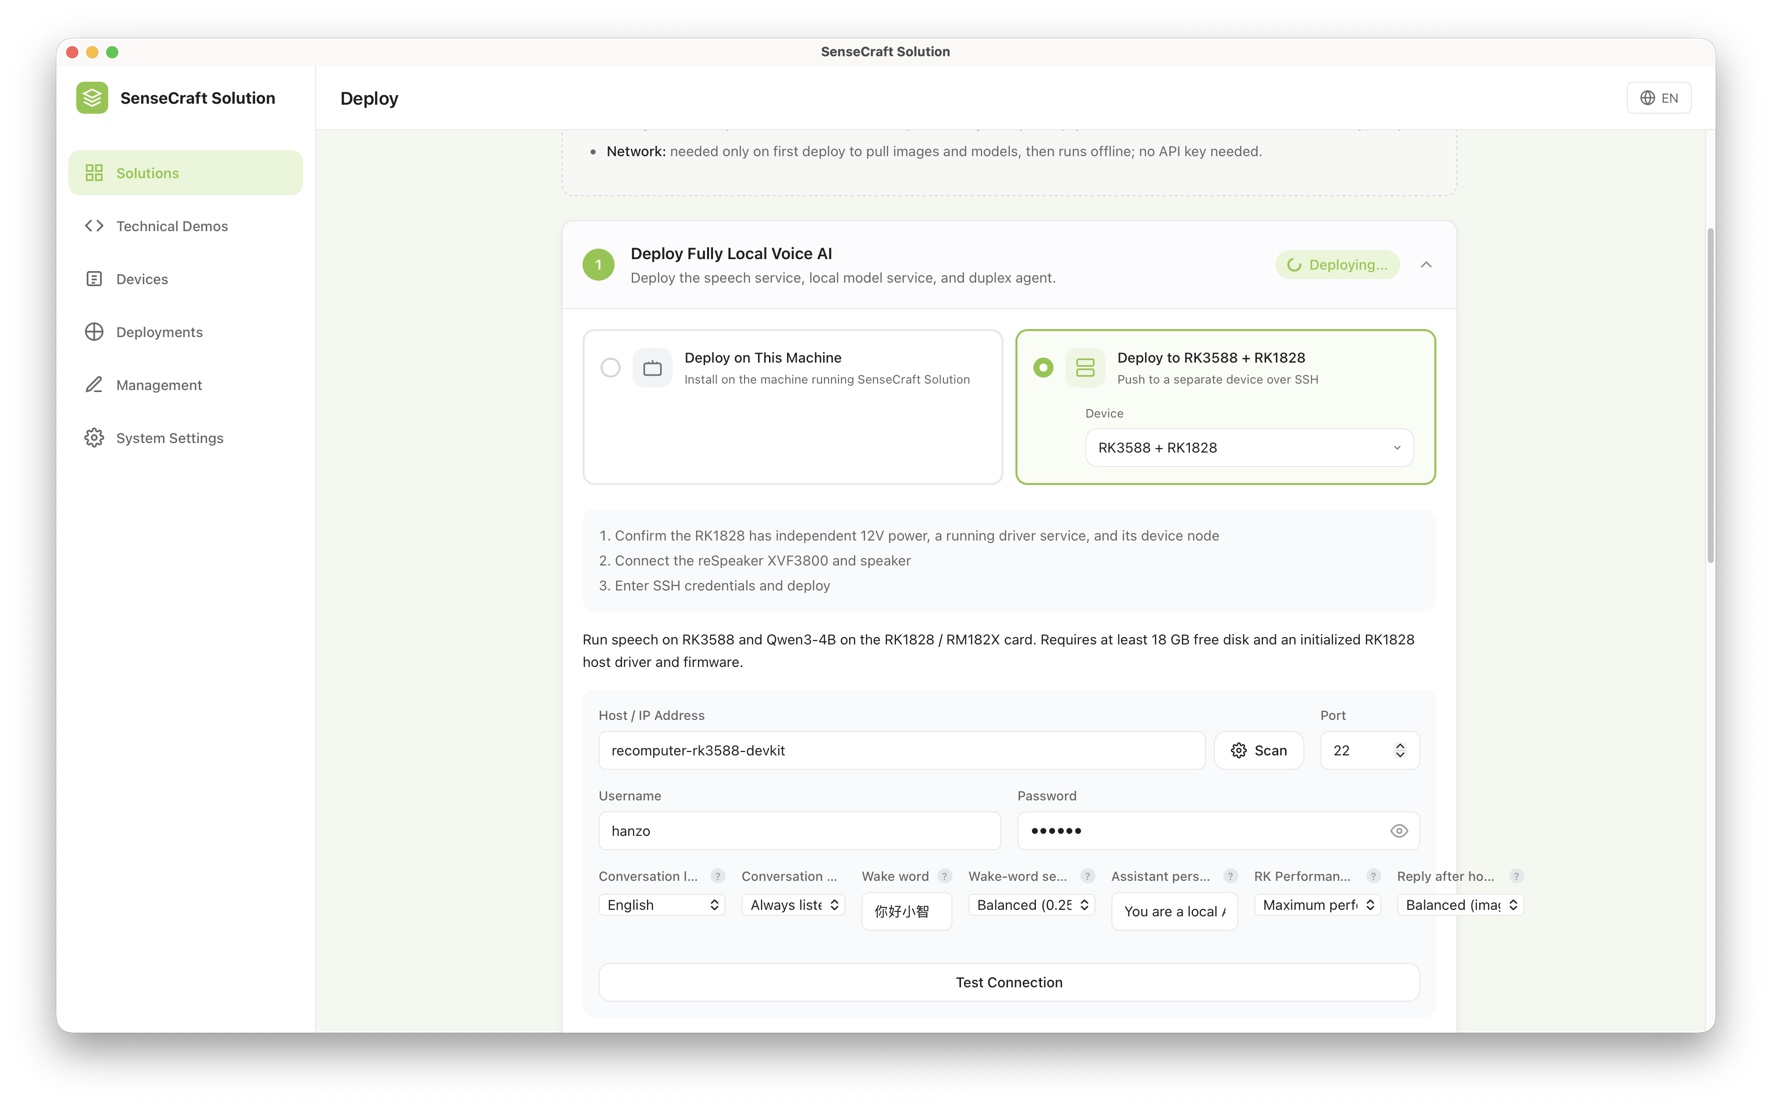
Para un despliegue totalmente local, introduce el nombre de host o la dirección IP del RK3588, el usuario y la contraseña SSH y el idioma de conversación. El modelo local se ejecuta en la tarjeta RK1828/RM182X, por lo que no hace falta una clave API de la nube. Confirma que la tarjeta tiene alimentación independiente de 12 V, controlador y nodo de dispositivo; después selecciona Probar conexión.
5. Despliega la solución
Haz clic en Desplegar ahora y espera a que SenseCraft Solution instale los servicios y prepare automáticamente los modelos de voz. El primer despliegue descarga imágenes de contenedor y archivos del modelo, así que mantén el dispositivo conectado a internet hasta que termine.
6. Abre la Web UI y prueba una conversación
Cuando el despliegue termine correctamente, abre la Web UI del equipo de voz en el puerto 18000. Para el kit de desarrollo RK3588 que se muestra aquí, utiliza http://recomputer-rk3588-devkit.local:18000. Si tu red no resuelve ese nombre, usa http://<device-ip>:18000 con la dirección IP del dispositivo.
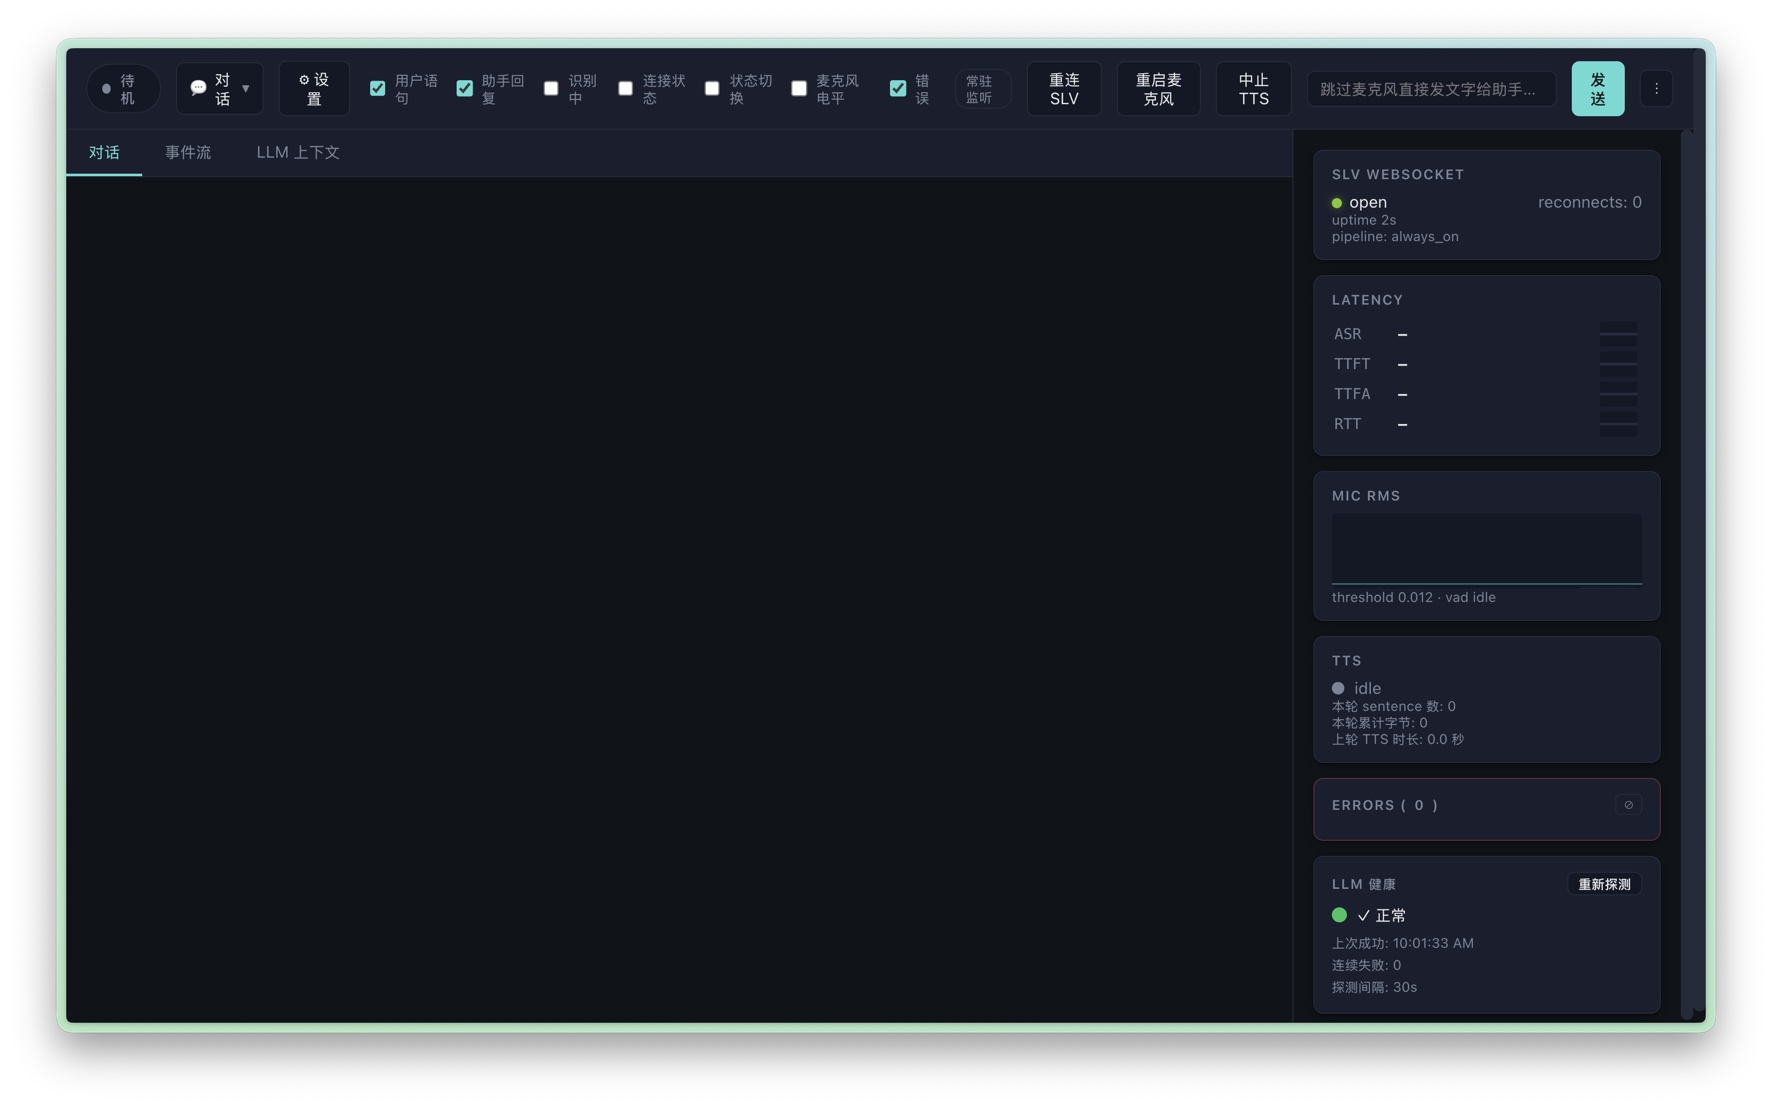
Habla al micrófono y escucha la respuesta en el altavoz conectado al reSpeaker. Luego vuelve a hablar mientras se reproduce una respuesta para comprobar que el terminal deja de hablar y escucha la nueva petición.