Comparaison de quantification de YOLO11 sur reComputer RK3576
Convertissez YOLO11n d’ONNX vers RKNN et comparez la taille, la vitesse d’inférence, la mémoire d’exécution et la précision COCO de FP16, INT8 et W4A16 sur reComputer RK3576.
Comparaison de quantification de YOLO11 sur reComputer RK3576
Un modèle de vision peut-il vraiment fonctionner en 4 bits sur du matériel Rockchip ? Le RK3576 est-il la seule plateforme Rockchip compatible, et un modèle plus petit est-il forcément plus rapide ?
Ce projet convertit le même modèle YOLO11n ONNX en modèles RKNN FP16, INT8 et W4A16, les exécute sur un reComputer RK3576 et les évalue selon un protocole reproductible.
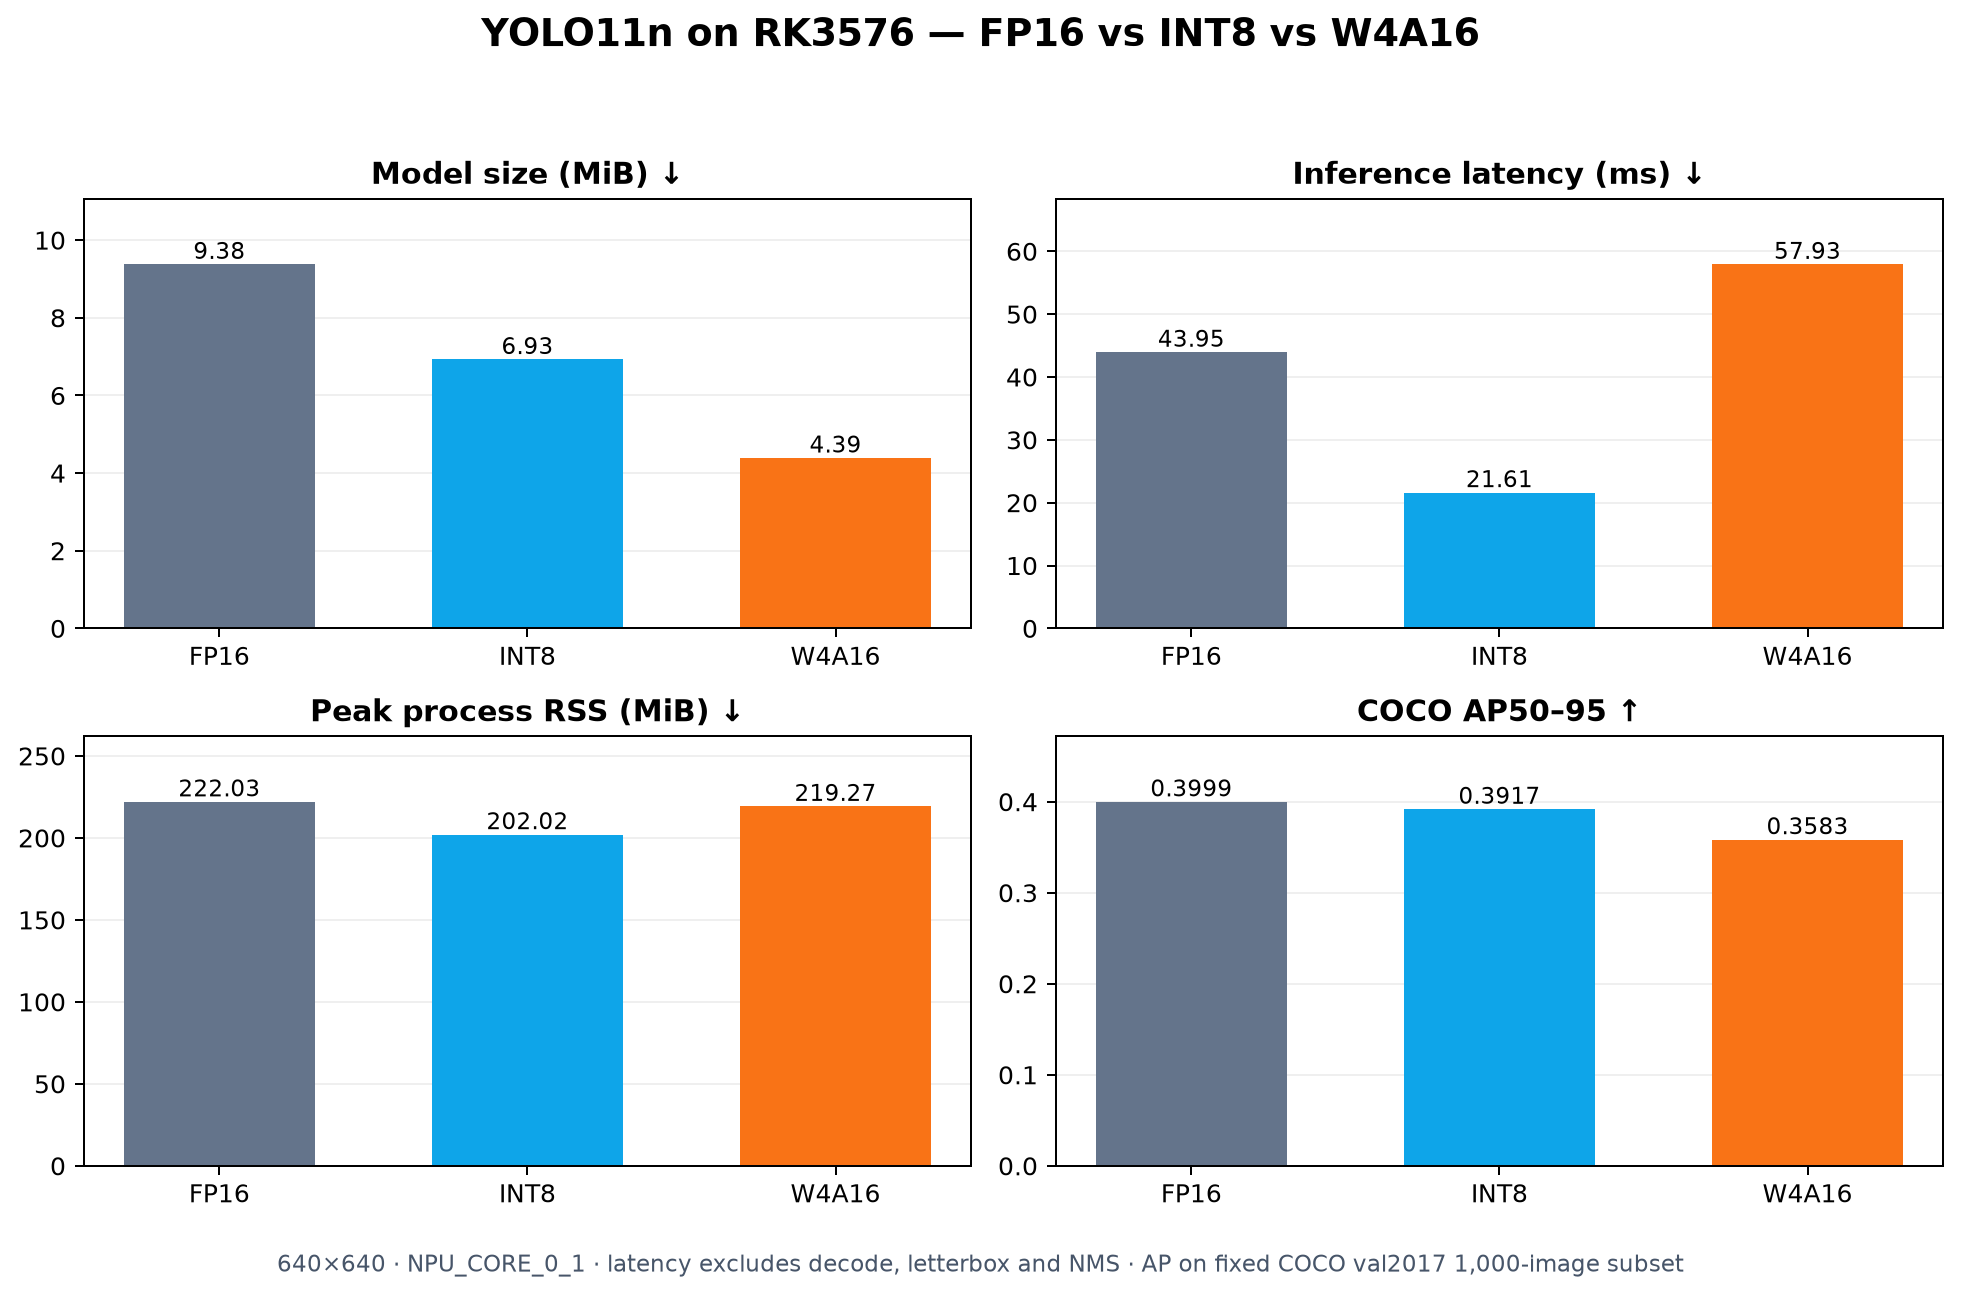
Le résultat ne se résume pas à « moins de bits, c’est mieux ». W4A16 produit le plus petit fichier, mais INT8 offre le meilleur compromis entre débit et précision.
Ce que signifie 4 bits sur RK3576
Dans W4A16, W désigne la précision des poids et A celle des activations.
| Format | Poids | Activations | Description courante |
|---|---|---|---|
| FP16 | Virgule flottante 16 bits | Virgule flottante 16 bits | Demi-précision |
| W8A8 | Entier 8 bits | Entier 8 bits | Quantification INT8 |
| W4A16 | Entier 4 bits | Virgule flottante 16 bits | Quantification des poids sur 4 bits |
| W4A4 | Entier 4 bits | Entier 4 bits | INT4 complet ou pur |
W4A16 stocke les poids sur 4 bits tout en conservant les activations sur 16 bits. Il s’agit donc d’un modèle dont les poids sont quantifiés sur 4 bits, et non d’un réseau entièrement W4A4.
Cette distinction compte en vision. Les poids sont fixes et analysables hors ligne, alors que les activations changent pour chaque image. Les têtes de détection, les caractéristiques des petits objets, les scores de confiance et la régression des boîtes sont souvent sensibles au bruit de quantification. Conserver des activations 16 bits réduit ce risque, mais la mémoire d’exécution ne diminue pas proportionnellement à la taille du fichier.
Le journal des modifications de RKNN-Toolkit2 documente explicitement la quantification symétrique W4A16 pour RK3576. Cela ne signifie pas que le RK3576 est le seul SoC Rockchip capable d’opérations INT4. D’autres puces peuvent proposer certaines opérations à faible précision, ce qui n’équivaut pas au flux complet de conversion CV W4A16 utilisé ici.
Matériel et logiciels
- Carte : reComputer RK3576, 8 Go
- Système : Debian 12 / Armbian
- Noyau :
6.1.115-vendor-seeed-rk3576 - RKNN-Toolkit2 : 2.3.2
- RKNN-Toolkit-Lite2 : 2.3.2
- RKNN Runtime : 2.3.0
- Pilote RKNPU : 0.9.8
- Modèle : YOLO11n ONNX optimisé du Rockchip Model Zoo
- Entrée : 640 × 640 RGB
- Étalonnage : les mêmes 20 images fixes COCO val2017 pour INT8 et W4A16
- Précision : sous-ensemble fixe de 1 000 images COCO val2017, graine 3576
Flux de conversion
YOLO11n ONNX
      +-- FP16 RKNN ------------------------+
      +-- INT8/W8A8 + calibration ---------+--> RK3576 NPU --> benchmark
      +-- W4A16 + GDQ + group128 ----------+
1. Installer RKNN-Toolkit2
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
  rknn-toolkit2==2.3.2 \
  rknn-toolkit-lite2==2.3.2 \
  numpy==1.26.4 onnx==1.16.1 \
  onnxruntime opencv-python pycocotools psutil
2. Préparer des données d’étalonnage représentatives
Créez dataset.txt avec un chemin d’image par ligne :
./calibration/000000000139.jpg
./calibration/000000000285.jpg
./calibration/000000000632.jpg
Utilisez des images représentatives du déploiement réel. Gardez la source ONNX et le jeu d’étalonnage identiques pour comparer les réglages.
3. Établir une référence FP16
from rknn.api import RKNN

rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("yolo11n_fp16.rknn")
Cette configuration accepte une entrée RGB uint8 et la normalise de 0–255 vers 0–1. Ne divisez pas une seconde fois par 255 dans l’application.
4. Construire INT8/W8A8
Ajoutez à la même configuration de prétraitement :
quantized_dtype="w8a8"
quantized_algorithm="normal"
quantized_method="channel"
Activez l’étalonnage pendant la construction :
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_int8.rknn")
5. Construire W4A16
La configuration w4a16 + normal + channel s’est compilée et exécutée, mais sa précision s’est effondrée. Le meilleur réglage testé était GDQ + group128 :
rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    quantized_dtype="w4a16",
    quantized_algorithm="gdq",
    quantized_method="group128",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_w4a16_gdq_group128.rknn")
La conversion W4A16 normale a pris environ 27 secondes, contre environ 641 secondes pour GDQ-group128. Ce coût hors ligne ne se répète pas pendant l’inférence.
group128 n’est pas optimal pour tous les modèles. Comparez la quantification par canal, plusieurs tailles de groupe et GDQ sur vos propres données de validation.
Exécuter le modèle sur RK3576
import cv2
import numpy as np
from rknnlite.api import RKNNLite

runtime = RKNNLite()
runtime.load_rknn("yolo11n_w4a16_gdq_group128.rknn")
runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)

image = cv2.imread("test.jpg")
image = cv2.resize(image, (640, 640))
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
outputs = runtime.inference(inputs=[image[np.newaxis, ...].astype(np.uint8)])

runtime.release()
Cet exemple minimal vérifie uniquement le démarrage du modèle. Une inférence YOLO11 en production nécessite le même letterbox, le décodage DFL, le filtrage des classes, la NMS et la restauration des coordonnées.
Protocole du benchmark
Chaque modèle a utilisé NPU_CORE_0_1, 50 itérations de préchauffage et 500 inférences mesurées. La séquence complète a été répétée trois fois en faisant tourner l’ordre des modèles. La latence couvre uniquement inference() de RKNNLite, sans chargement d’image, letterbox ni NMS.
Pour la précision, les modèles ont utilisé les mêmes 1 000 images COCO, paramètres letterbox, seuil de confiance 0,001, seuil NMS 0,65 et configuration COCOeval.
Comparaison d’inférences réelles
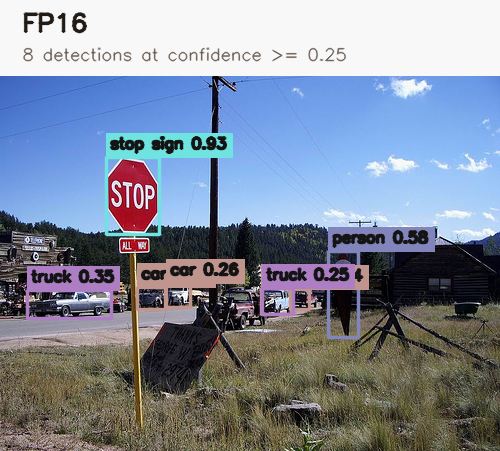
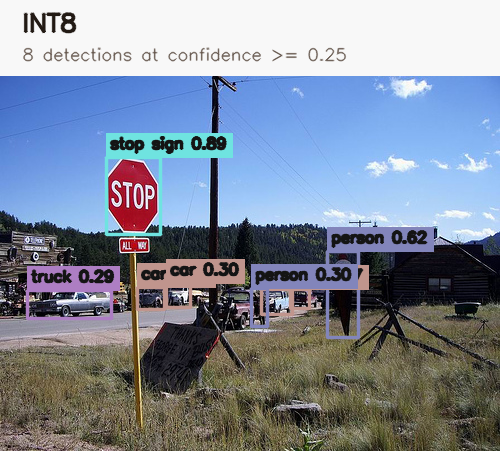
Les images suivantes utilisent la même source COCO val2017 (000000222094.jpg) et les prédictions enregistrées lors de l’évaluation formelle sur 1 000 images. Pour rester lisibles, seules les détections de confiance supérieure ou égale à 0,25 sont tracées ; le seuil NMS reste à 0,65.
FP16 — 8 détections
INT8 — 8 détections
W4A16 GDQ-group128 — 2 détections
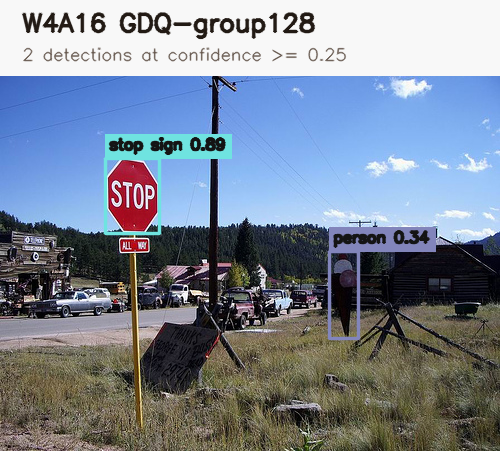
Cet exemple a été choisi parce que l’écart de quantification y est facile à observer. Il reste illustratif et ne remplace pas les résultats COCO AP agrégés ci-dessous.
Résultats
| Précision | Taille | Latence moyenne | Débit | RSS maximal | AP50–95 |
|---|---|---|---|---|---|
| FP16 | 9,38 Mio | 43,95 ms | 22,76 FPS | 222,03 Mio | 0,3999 |
| INT8 | 6,93 Mio | 21,61 ms | 46,36 FPS | 202,02 Mio | 0,3917 |
| W4A16 GDQ-group128 | 4,39 Mio | 57,93 ms | 17,30 FPS | 219,27 Mio | 0,3583 |
INT8 atteint environ 2,04 fois le débit de FP16 avec une perte de seulement 0,82 point d’AP.
W4A16 réduit le fichier à 46,8 % de la taille FP16, mais son débit est inférieur de 24,0 % à FP16 et de 62,7 % à INT8. Son AP50–95 est inférieur de 4,16 points à FP16.
Le premier W4A16 normal + channel n’a obtenu que 0,0121 AP50–95 malgré des tenseurs de forme valide. GDQ-group128 remonte à 0,3583 : une conversion réussie ne remplace donc pas la validation.
Quelle précision choisir ?
- FP16 pour établir une référence fiable de déploiement et de précision.
- INT8 lorsque l’équilibre entre débit et précision est prioritaire.
- W4A16 lorsque le stockage du modèle ou la bande passante des poids est la contrainte principale.
Pour ce déploiement YOLO11n, INT8 constitue le meilleur choix global. W4A16 compresse efficacement les poids, mais n’accélère pas automatiquement l’inférence.