基于 reComputer RK3576 的 YOLO11 量化对比
将 YOLO11n 从 ONNX 转换为 RKNN,并在 reComputer RK3576 上比较 FP16、INT8 和 W4A16 的模型大小、推理速度、运行内存与 COCO 精度。
基于 reComputer RK3576 的 YOLO11 量化对比
计算机视觉模型真的能以 4 位精度运行在 Rockchip 硬件上吗?RK3576 是唯一支持 4 位模型的 Rockchip 平台吗?模型文件更小是否就一定运行得更快?
本项目将同一个 YOLO11n ONNX 模型转换为 FP16、INT8 和 W4A16 三种 RKNN 模型,在 reComputer RK3576 上运行,并使用统一、可复现的测试流程进行评估。
结果并不是简单的“位数越少越好”。W4A16 得到了最小的模型文件,但 INT8 在吞吐量和精度之间取得了最佳平衡。
RK3576 上的 4 位是什么意思
在 W4A16 中,W 表示权重精度,A 表示激活精度:
| 格式 | 权重 | 激活 | 常见描述 |
|---|---|---|---|
| FP16 | 16 位浮点数 | 16 位浮点数 | 半精度 |
| W8A8 | 8 位整数 | 8 位整数 | INT8 量化 |
| W4A16 | 4 位整数 | 16 位浮点数 | 4 位权重量化 |
| W4A4 | 4 位整数 | 4 位整数 | 完整或纯 INT4 |
W4A16 用 4 位存储权重,同时保留 16 位激活。因此它是一个 4 位权重量化模型,而不是完全的 W4A4 网络。
这个区别对计算机视觉非常重要。权重是固定参数,可以在部署前离线分析;激活则会随每张输入图像变化。检测头、小目标特征、置信度和边界框回归往往对激活量化噪声较为敏感。保留 16 位激活可以降低这类风险,但也意味着运行内存不会按照模型文件大小同比例下降。
RKNN-Toolkit2 的更新日志明确记录了 RK3576 的 W4A16 对称量化支持。但这不能被泛化为“RK3576 是唯一能进行任何 INT4 计算的 Rockchip SoC”。其他芯片可能提供特定的低位运算能力,但这不等同于本文使用的完整 RKNN W4A16 计算机视觉模型转换流程。
硬件与软件
- 开发板:reComputer RK3576,8 GB
- 操作系统:Debian 12 / Armbian
- 内核:
6.1.115-vendor-seeed-rk3576 - RKNN-Toolkit2:2.3.2
- RKNN-Toolkit-Lite2:2.3.2
- RKNN Runtime:2.3.0
- RKNPU 驱动:0.9.8
- 模型:来自 Rockchip Model Zoo 的优化版 YOLO11n ONNX
- 输入:640 × 640 RGB
- 校准集:INT8 与 W4A16 使用相同且固定的 20 张 COCO val2017 图像
- 精度集:固定的 1,000 张 COCO val2017 子集,随机种子为 3576
转换流程
YOLO11n ONNX
      +-- FP16 RKNN ------------------------+
      +-- INT8/W8A8 + calibration ---------+--> RK3576 NPU --> benchmark
      +-- W4A16 + GDQ + group128 ----------+
1. 安装 RKNN-Toolkit2
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
  rknn-toolkit2==2.3.2 \
  rknn-toolkit-lite2==2.3.2 \
  numpy==1.26.4 onnx==1.16.1 \
  onnxruntime opencv-python pycocotools psutil
2. 准备有代表性的校准数据
创建 dataset.txt,每行填写一个图像路径:
./calibration/000000000139.jpg
./calibration/000000000285.jpg
./calibration/000000000632.jpg
校准图像应能代表真实部署环境。比较不同量化配置时,应保持 ONNX 源模型和校准集完全一致。
3. 建立 FP16 基线
from rknn.api import RKNN

rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("yolo11n_fp16.rknn")
该配置让 RKNN 运行时接收 uint8 RGB 输入,并将数值从 0–255 归一化到 0–1。应用程序中不要再次除以 255。
4. 构建 INT8/W8A8
沿用相同的预处理配置,然后加入:
quantized_dtype="w8a8"
quantized_algorithm="normal"
quantized_method="channel"
启用校准并构建模型:
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_int8.rknn")
5. 构建 W4A16
基础的 w4a16 + normal + channel 配置可以完成编译和运行,但精度严重下降。本次测试中表现最好的 W4A16 配置为 GDQ + group128:
rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    quantized_dtype="w4a16",
    quantized_algorithm="gdq",
    quantized_method="group128",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_w4a16_gdq_group128.rknn")
在这块开发板上,普通 W4A16 转换约需 27 秒,GDQ-group128 约需 641 秒。这是一次性的离线转换开销,不会在推理时重复发生。
group128 并非对所有模型都最优。请使用自己的验证数据比较 channel 量化、多个 group 大小以及 GDQ。
在 RK3576 上运行模型
import cv2
import numpy as np
from rknnlite.api import RKNNLite

runtime = RKNNLite()
runtime.load_rknn("yolo11n_w4a16_gdq_group128.rknn")
runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)

image = cv2.imread("test.jpg")
image = cv2.resize(image, (640, 640))
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
outputs = runtime.inference(
    inputs=[image[np.newaxis, ...].astype(np.uint8)]
)

runtime.release()
这个最小示例只用于确认模型能够启动。生产环境中的 YOLO11 推理还必须使用一致的 letterbox 预处理、DFL 解码、类别过滤、NMS 和坐标还原。
基准测试方法
性能测试中,每个模型均使用 NPU_CORE_0_1,预热 50 次后测量 500 次推理。完整流程以轮换模型顺序的方式重复三遍。延迟只统计 RKNNLite 的 inference() 调用,不包含图像读取、letterbox 和 NMS。
精度测试中,所有模型使用相同的 1,000 张 COCO 图像、letterbox 设置、0.001 置信度阈值、0.65 NMS 阈值和 COCOeval 配置。
真实推理图片对比
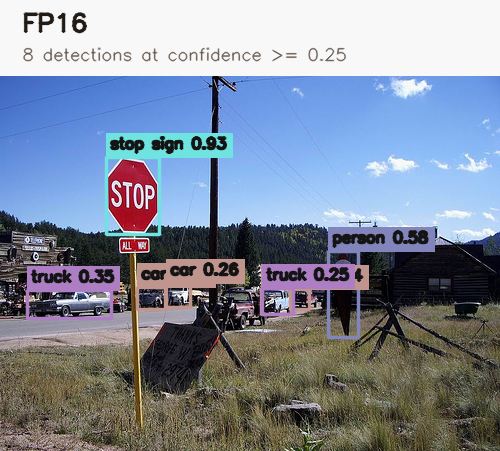
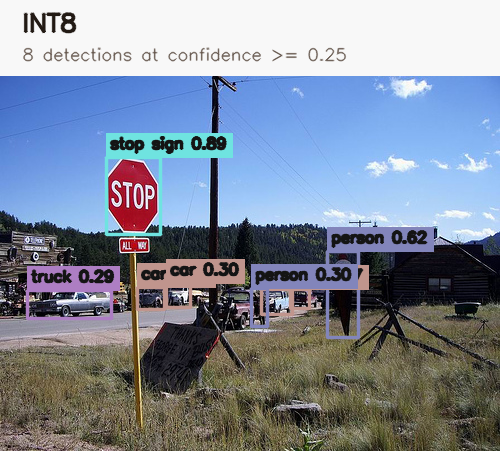
以下结果使用同一张 COCO val2017 原图(000000222094.jpg),预测框来自正式的 1,000 张图精度测试。为了便于阅读,图片只绘制置信度不低于 0.25 的检测结果,NMS 阈值仍为 0.65。
FP16——检出 8 个目标
INT8——检出 8 个目标
W4A16 GDQ-group128——检出 2 个目标
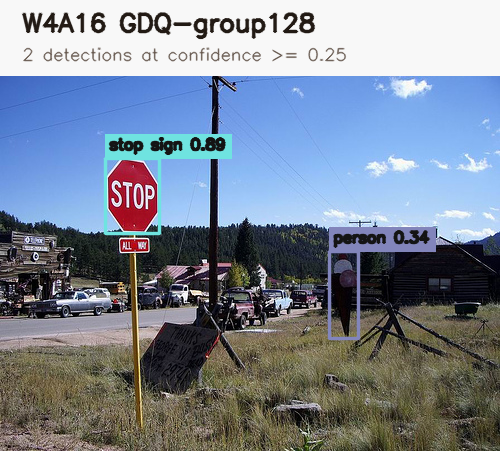
选择这张图片是因为量化差异较容易观察。它只用于直观展示,不能替代下方基于 1,000 张图的 COCO AP 汇总结果。
测试结果
| 精度 | 模型大小 | 平均延迟 | 吞吐量 | 峰值 RSS | AP50–95 |
|---|---|---|---|---|---|
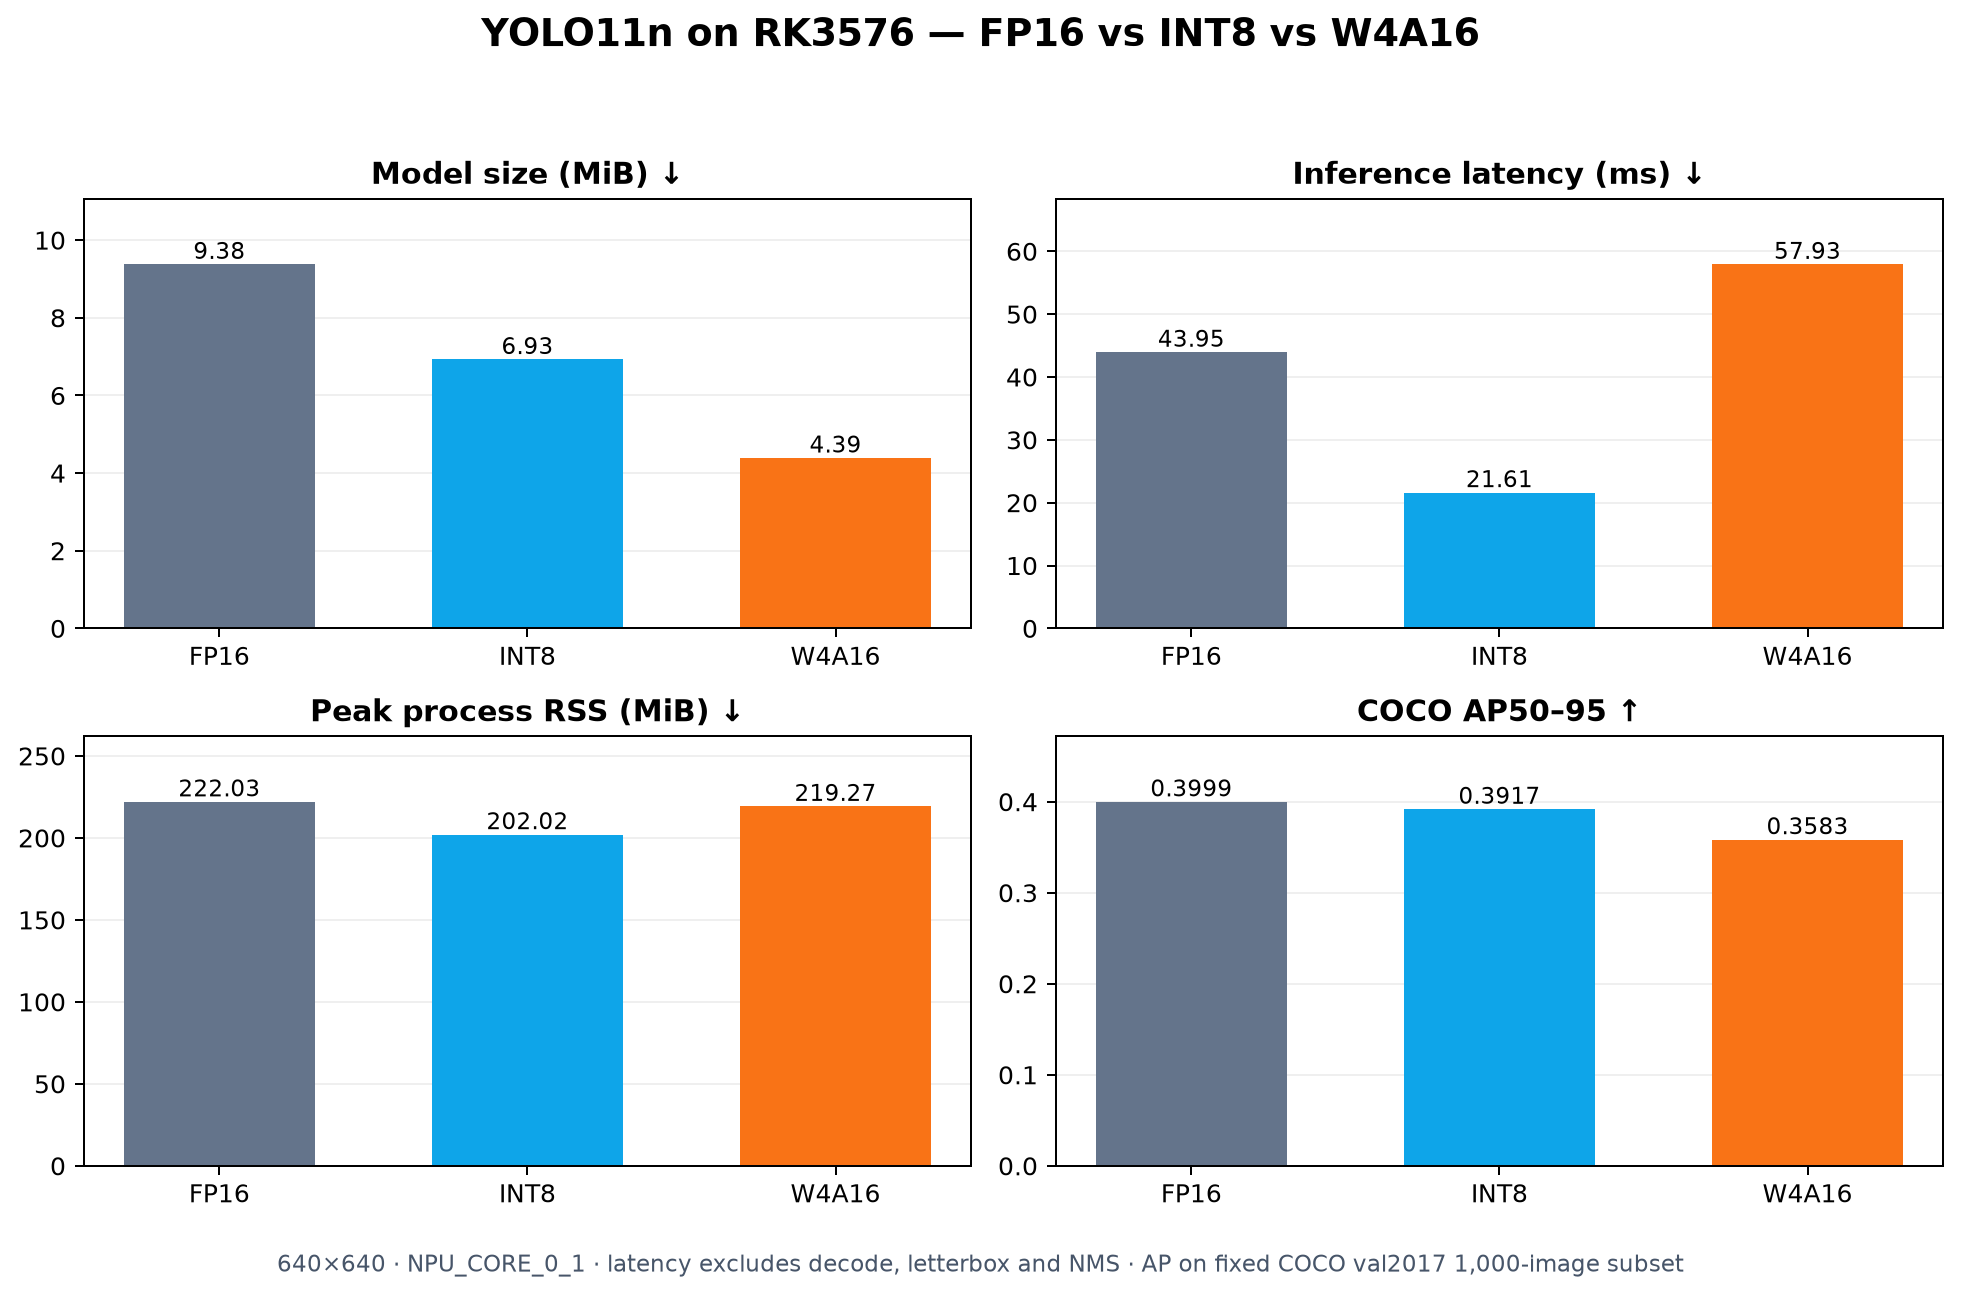
| FP16 | 9.38 MiB | 43.95 ms | 22.76 FPS | 222.03 MiB | 0.3999 |
| INT8 | 6.93 MiB | 21.61 ms | 46.36 FPS | 202.02 MiB | 0.3917 |
| W4A16 GDQ-group128 | 4.39 MiB | 57.93 ms | 17.30 FPS | 219.27 MiB | 0.3583 |
INT8 的吞吐量约为 FP16 的 2.04 倍,而 AP 仅下降 0.82 个百分点。
W4A16 将 RKNN 文件缩小到 FP16 的 46.8%,但吞吐量比 FP16 低 24.0%,比 INT8 低 62.7%;其 AP50–95 比 FP16 低 4.16 个百分点。
第一个采用 normal + channel 的 W4A16 模型虽然可以加载并返回形状正确的张量,但 AP50–95 只有 0.0121。GDQ-group128 将精度恢复到 0.3583,说明转换成功不能代替实际验证。
应该选择哪种精度?
- 选择 FP16,建立可靠的部署和精度基线。
- 选择 INT8,在吞吐量与精度之间取得平衡。
- 当模型存储空间或权重带宽是主要限制时,再测试 W4A16。
对于本次 YOLO11n 部署,INT8 是综合表现最好的选择。W4A16 可以有效压缩权重,但不会自动带来速度提升。