YOLO11-kwantisatievergelijking op reComputer RK3576
Converteer YOLO11n van ONNX naar RKNN en vergelijk modelgrootte, inferentiesnelheid, runtimegeheugen en COCO-nauwkeurigheid van FP16, INT8 en W4A16 op reComputer RK3576.
YOLO11-kwantisatievergelijking op reComputer RK3576
Kan een computervisiemodel echt met 4-bit precisie op Rockchip-hardware draaien? Is RK3576 het enige ondersteunde Rockchip-platform, en is een kleiner modelbestand automatisch sneller?
Dit project converteert hetzelfde YOLO11n ONNX-model naar FP16-, INT8- en W4A16-RKNN-modellen, voert ze uit op een reComputer RK3576 en beoordeelt ze met één reproduceerbaar protocol.
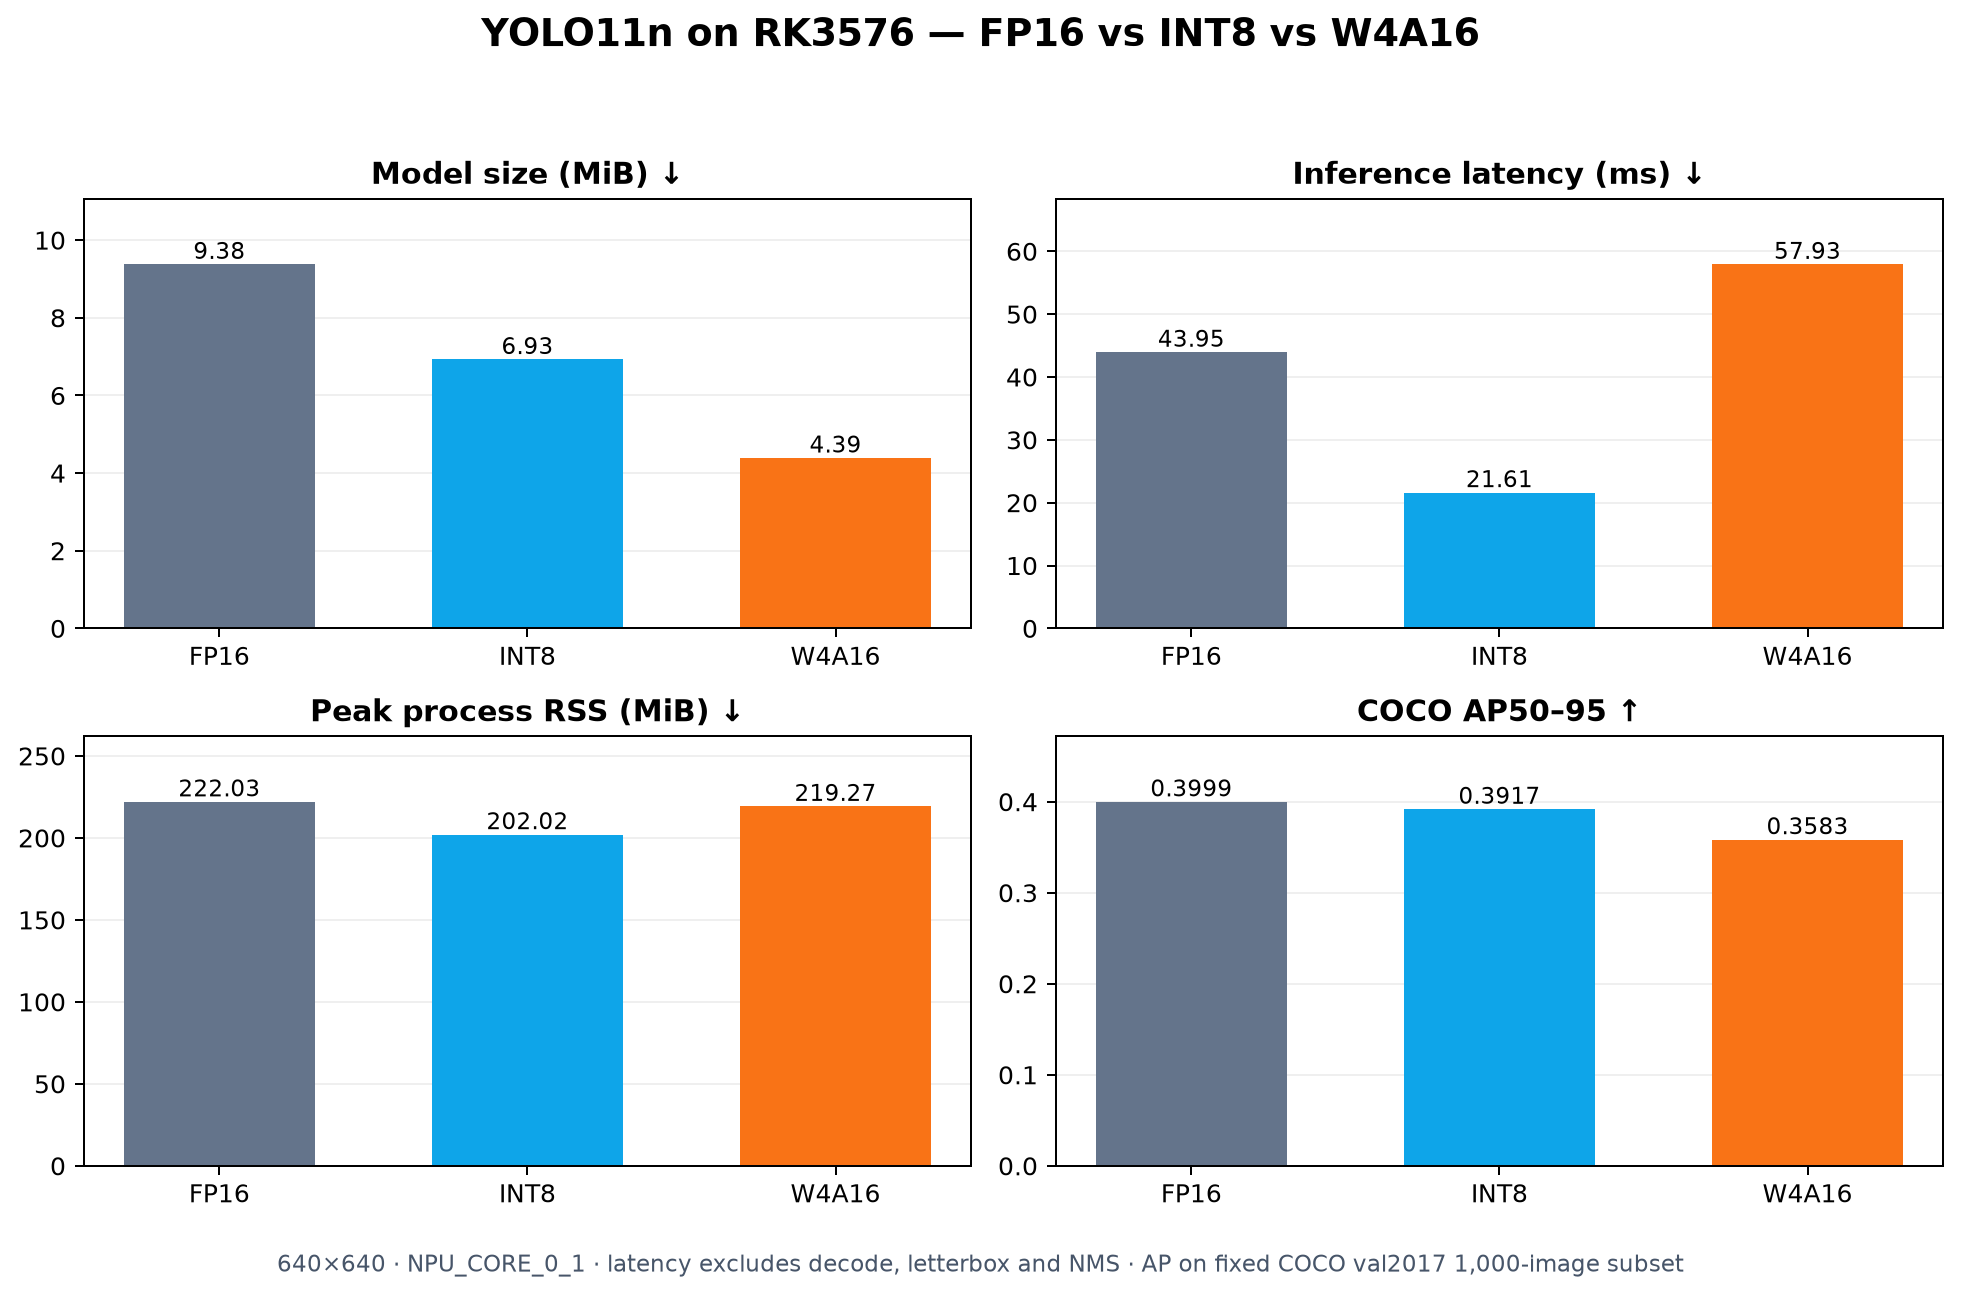
De uitkomst is niet simpelweg “minder bits is beter”. W4A16 leverde het kleinste bestand, maar INT8 bood de beste balans tussen doorvoer en nauwkeurigheid.
Wat 4-bit op RK3576 betekent
In W4A16 staat W voor de precisie van de gewichten en A voor de precisie van de activaties.
| Formaat | Gewichten | Activaties | Gebruikelijke omschrijving |
|---|---|---|---|
| FP16 | 16-bit floating-point | 16-bit floating-point | Halve precisie |
| W8A8 | 8-bit integer | 8-bit integer | INT8-kwantisering |
| W4A16 | 4-bit integer | 16-bit floating-point | 4-bit gewichtskwantisering |
| W4A4 | 4-bit integer | 4-bit integer | Volledige of pure INT4 |
W4A16 slaat gewichten op in 4 bits en houdt activaties op 16 bits. Het is dus een model met 4-bit gekwantiseerde gewichten, niet een volledig W4A4-netwerk.
Dit verschil is belangrijk voor computervisie. Gewichten zijn vast en kunnen vooraf offline worden geanalyseerd, terwijl activaties bij elk beeld veranderen. Detectiekoppen, kenmerken van kleine objecten, betrouwbaarheidsscores en bounding-boxregressie zijn vaak gevoelig voor kwantiseringsruis. 16-bit activaties beperken dat risico, maar het runtimegeheugen krimpt daardoor niet evenredig met het modelbestand.
De changelog van RKNN-Toolkit2 documenteert W4A16 symmetrische kwantisering expliciet voor RK3576. Dit betekent niet dat RK3576 de enige Rockchip-SoC is die enige INT4-bewerking kan uitvoeren. Andere chips kunnen specifieke low-bit-bewerkingen bieden; dat is niet hetzelfde als de volledige RKNN W4A16-CV-conversiestroom die hier wordt gebruikt.
Hardware en software
- Board: reComputer RK3576, 8 GB
- Besturingssysteem: Debian 12 / Armbian
- Kernel:
6.1.115-vendor-seeed-rk3576 - RKNN-Toolkit2: 2.3.2
- RKNN-Toolkit-Lite2: 2.3.2
- RKNN Runtime: 2.3.0
- RKNPU-driver: 0.9.8
- Model: geoptimaliseerde YOLO11n ONNX uit de Rockchip Model Zoo
- Invoer: 640 × 640 RGB
- Kalibratie: dezelfde vaste 20 COCO val2017-afbeeldingen voor INT8 en W4A16
- Nauwkeurigheid: vaste subset van 1.000 COCO val2017-afbeeldingen, seed 3576
Conversiestroom
YOLO11n ONNX
      +-- FP16 RKNN ------------------------+
      +-- INT8/W8A8 + calibration ---------+--> RK3576 NPU --> benchmark
      +-- W4A16 + GDQ + group128 ----------+
1. RKNN-Toolkit2 installeren
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
  rknn-toolkit2==2.3.2 \
  rknn-toolkit-lite2==2.3.2 \
  numpy==1.26.4 onnx==1.16.1 \
  onnxruntime opencv-python pycocotools psutil
2. Representatieve kalibratiegegevens voorbereiden
Maak dataset.txt met één afbeeldingspad per regel:
./calibration/000000000139.jpg
./calibration/000000000285.jpg
./calibration/000000000632.jpg
Gebruik beelden die de echte toepassing vertegenwoordigen. Houd het ONNX-bronmodel en de kalibratieset identiek bij het vergelijken van instellingen.
3. Een FP16-basislijn maken
from rknn.api import RKNN

rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("yolo11n_fp16.rknn")
Hiermee accepteert de RKNN-runtime uint8 RGB-invoer en normaliseert die van 0–255 naar 0–1. Deel in de toepassing niet opnieuw door 255.
4. INT8/W8A8 bouwen
Voeg aan dezelfde preprocessingconfiguratie toe:
quantized_dtype="w8a8"
quantized_algorithm="normal"
quantized_method="channel"
Bouw met kalibratie ingeschakeld:
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_int8.rknn")
5. W4A16 bouwen
w4a16 + normal + channel kon worden gebouwd en uitgevoerd, maar de nauwkeurigheid stortte in. De beste geteste instelling was GDQ + group128:
rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    quantized_dtype="w4a16",
    quantized_algorithm="gdq",
    quantized_method="group128",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_w4a16_gdq_group128.rknn")
Normale W4A16-conversie duurde ongeveer 27 seconden; GDQ-group128 ongeveer 641 seconden. Dit is een eenmalige offline conversiekost en komt niet terug tijdens inferentie.
group128 is niet voor elk model optimaal. Vergelijk kanaalkwantisering, meerdere groepsgroottes en GDQ met eigen validatiegegevens.
Het model op RK3576 uitvoeren
import cv2
import numpy as np
from rknnlite.api import RKNNLite

runtime = RKNNLite()
runtime.load_rknn("yolo11n_w4a16_gdq_group128.rknn")
runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)

image = cv2.imread("test.jpg")
image = cv2.resize(image, (640, 640))
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
outputs = runtime.inference(inputs=[image[np.newaxis, ...].astype(np.uint8)])

runtime.release()
Dit minimale voorbeeld controleert alleen of het model start. Productie-inferentie met YOLO11 vereist overeenkomende letterbox-preprocessing, DFL-decodering, klassefiltering, NMS en coördinatenherstel.
Benchmarkprotocol
Elk model gebruikte NPU_CORE_0_1, 50 opwarmiteraties en 500 gemeten inferenties. De volledige reeks werd driemaal herhaald met een wisselende modelvolgorde. Latentie omvat alleen de RKNNLite-aanroep inference(), zonder beeldladen, letterboxing en NMS.
Voor nauwkeurigheid gebruikten alle modellen dezelfde 1.000 COCO-beelden, letterboxinstellingen, betrouwbaarheidsdrempel 0,001, NMS-drempel 0,65 en COCOeval-configuratie.
Vergelijking van echte inferentiebeelden
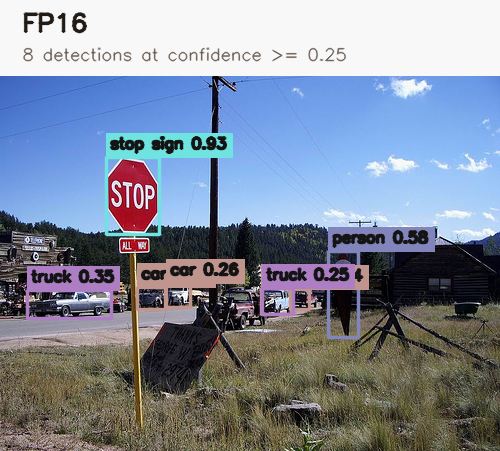
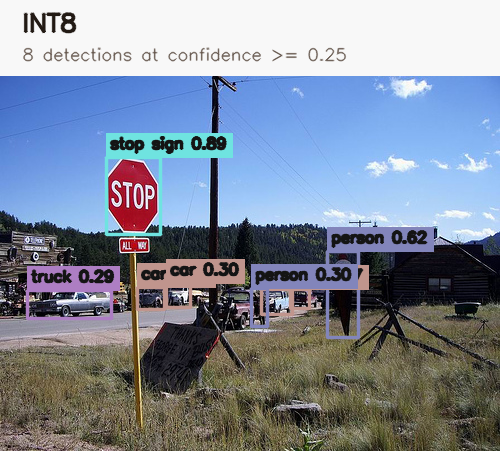
De volgende afbeeldingen gebruiken hetzelfde COCO val2017-bronbeeld (000000222094.jpg) en de voorspellingen die tijdens de formele evaluatie van 1.000 beelden zijn opgeslagen. Voor de leesbaarheid worden alleen detecties met minimaal 0,25 betrouwbaarheid getekend; de NMS-drempel blijft 0,65.
FP16 — 8 detecties
INT8 — 8 detecties
W4A16 GDQ-group128 — 2 detecties
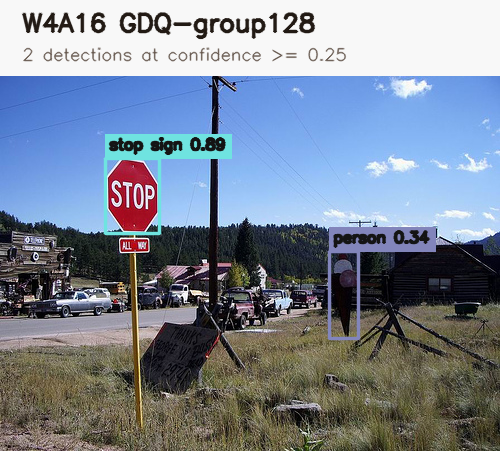
Dit voorbeeld is gekozen omdat het kwantiseringsverschil duidelijk zichtbaar is. Het is alleen illustratief en vervangt de geaggregeerde COCO AP-resultaten hieronder niet.
Resultaten
| Precisie | Modelgrootte | Gemiddelde latentie | Doorvoer | Piek-RSS | AP50–95 |
|---|---|---|---|---|---|
| FP16 | 9,38 MiB | 43,95 ms | 22,76 FPS | 222,03 MiB | 0,3999 |
| INT8 | 6,93 MiB | 21,61 ms | 46,36 FPS | 202,02 MiB | 0,3917 |
| W4A16 GDQ-group128 | 4,39 MiB | 57,93 ms | 17,30 FPS | 219,27 MiB | 0,3583 |
INT8 haalde ongeveer 2,04 keer de FP16-doorvoer met slechts 0,82 AP-punt verlies.
W4A16 verkleinde het RKNN-bestand tot 46,8% van FP16, maar de doorvoer lag 24,0% onder FP16 en 62,7% onder INT8. AP50–95 lag 4,16 punten onder FP16.
Het eerste W4A16-model met normal + channel behaalde slechts 0,0121 AP50–95, ondanks geldige uitvoertensoren. GDQ-group128 herstelde dit tot 0,3583: een geslaagde conversie vervangt validatie niet.
Welke precisie kiest u?
- FP16 voor een betrouwbare basislijn voor implementatie en nauwkeurigheid.
- INT8 wanneer doorvoer en nauwkeurigheid samen belangrijk zijn.
- W4A16 wanneer modelopslag of gewichtsbandbreedte de voornaamste beperking is.
Voor deze YOLO11n-implementatie was INT8 de beste algemene keuze. W4A16 comprimeerde de gewichten, maar leverde niet automatisch extra snelheid op.