Comparación de cuantización de YOLO11 en reComputer RK3576
Convierte YOLO11n de ONNX a RKNN y compara el tamaño, la velocidad de inferencia, la memoria en ejecución y la precisión COCO de FP16, INT8 y W4A16 en reComputer RK3576.
Comparación de cuantización de YOLO11 en reComputer RK3576
¿Puede un modelo de visión artificial ejecutarse realmente con precisión de 4 bits en hardware Rockchip? ¿Es RK3576 la única plataforma Rockchip compatible y un archivo más pequeño siempre implica mayor velocidad?
Este proyecto convierte el mismo modelo YOLO11n ONNX en modelos RKNN FP16, INT8 y W4A16, los ejecuta en un reComputer RK3576 y los evalúa con un protocolo reproducible.
El resultado no es simplemente «menos bits es mejor». W4A16 produjo el archivo más pequeño, pero INT8 ofreció el mejor equilibrio entre rendimiento y precisión.
Qué significan los 4 bits en RK3576
En W4A16, W indica la precisión de los pesos y A la de las activaciones.
| Formato | Pesos | Activaciones | Descripción habitual |
|---|---|---|---|
| FP16 | Coma flotante de 16 bits | Coma flotante de 16 bits | Media precisión |
| W8A8 | Entero de 8 bits | Entero de 8 bits | Cuantización INT8 |
| W4A16 | Entero de 4 bits | Coma flotante de 16 bits | Cuantización de pesos a 4 bits |
| W4A4 | Entero de 4 bits | Entero de 4 bits | INT4 completo o puro |
W4A16 almacena los pesos en 4 bits y mantiene las activaciones en 16 bits. Por tanto, es un modelo con pesos cuantizados a 4 bits, no una red W4A4 completa.
La diferencia es importante en visión artificial. Los pesos son fijos y pueden analizarse sin conexión, pero las activaciones cambian con cada imagen. Las cabezas de detección, las características de objetos pequeños, las puntuaciones de confianza y la regresión de cajas suelen ser sensibles al ruido de cuantización. Mantener activaciones de 16 bits reduce el riesgo, aunque la memoria de ejecución no disminuye en la misma proporción que el archivo.
El registro de cambios de RKNN-Toolkit2 documenta explícitamente la cuantización simétrica W4A16 para RK3576. Esto no significa que RK3576 sea el único SoC Rockchip capaz de cualquier operación INT4. Otros chips pueden ofrecer operaciones específicas de baja precisión, algo distinto del flujo completo de conversión W4A16 para CV utilizado aquí.
Hardware y software
- Placa: reComputer RK3576, 8 GB
- SO: Debian 12 / Armbian
- Kernel:
6.1.115-vendor-seeed-rk3576 - RKNN-Toolkit2: 2.3.2
- RKNN-Toolkit-Lite2: 2.3.2
- RKNN Runtime: 2.3.0
- Controlador RKNPU: 0.9.8
- Modelo: YOLO11n ONNX optimizado del Rockchip Model Zoo
- Entrada: 640 × 640 RGB
- Calibración: las mismas 20 imágenes fijas de COCO val2017 para INT8 y W4A16
- Precisión: subconjunto fijo de 1.000 imágenes de COCO val2017, semilla 3576
Flujo de conversión
YOLO11n ONNX
      +-- FP16 RKNN ------------------------+
      +-- INT8/W8A8 + calibration ---------+--> RK3576 NPU --> benchmark
      +-- W4A16 + GDQ + group128 ----------+
1. Instalar RKNN-Toolkit2
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
  rknn-toolkit2==2.3.2 \
  rknn-toolkit-lite2==2.3.2 \
  numpy==1.26.4 onnx==1.16.1 \
  onnxruntime opencv-python pycocotools psutil
2. Preparar datos de calibración representativos
Crea dataset.txt con una ruta de imagen por línea:
./calibration/000000000139.jpg
./calibration/000000000285.jpg
./calibration/000000000632.jpg
Usa imágenes que representen el entorno real. Mantén idénticos el ONNX y el conjunto de calibración al comparar configuraciones.
3. Establecer la referencia FP16
from rknn.api import RKNN

rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("yolo11n_fp16.rknn")
Esta configuración acepta una entrada RGB uint8 y la normaliza de 0–255 a 0–1. No vuelvas a dividir entre 255 en la aplicación.
4. Compilar INT8/W8A8
A la misma configuración de preprocesamiento añade:
quantized_dtype="w8a8"
quantized_algorithm="normal"
quantized_method="channel"
Activa la calibración al compilar:
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_int8.rknn")
5. Compilar W4A16
La configuración w4a16 + normal + channel compiló y se ejecutó, pero la precisión se desplomó. La mejor configuración de esta prueba fue GDQ + group128:
rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    quantized_dtype="w4a16",
    quantized_algorithm="gdq",
    quantized_method="group128",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_w4a16_gdq_group128.rknn")
La conversión W4A16 normal tardó unos 27 segundos y GDQ-group128 unos 641 segundos. Es un coste de conversión sin conexión que no se repite durante la inferencia.
group128 no es óptimo para todos los modelos. Compara cuantización por canal, varios tamaños de grupo y GDQ con tus propios datos de validación.
Ejecutar el modelo en RK3576
import cv2
import numpy as np
from rknnlite.api import RKNNLite

runtime = RKNNLite()
runtime.load_rknn("yolo11n_w4a16_gdq_group128.rknn")
runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)

image = cv2.imread("test.jpg")
image = cv2.resize(image, (640, 640))
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
outputs = runtime.inference(inputs=[image[np.newaxis, ...].astype(np.uint8)])

runtime.release()
Este ejemplo mínimo solo comprueba que el modelo arranca. Una inferencia YOLO11 de producción necesita el mismo letterbox, decodificación DFL, filtrado de clases, NMS y restauración de coordenadas.
Protocolo del benchmark
Cada modelo utilizó NPU_CORE_0_1, 50 iteraciones de calentamiento y 500 inferencias medidas. La secuencia completa se repitió tres veces rotando el orden. La latencia solo incluye inference() de RKNNLite, no la carga de imágenes, letterbox ni NMS.
Para la precisión se usaron las mismas 1.000 imágenes COCO, ajustes de letterbox, umbral de confianza 0,001, umbral NMS 0,65 y configuración COCOeval.
Comparación de inferencias reales
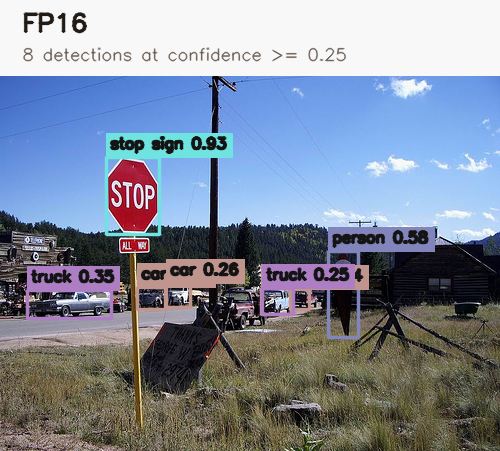
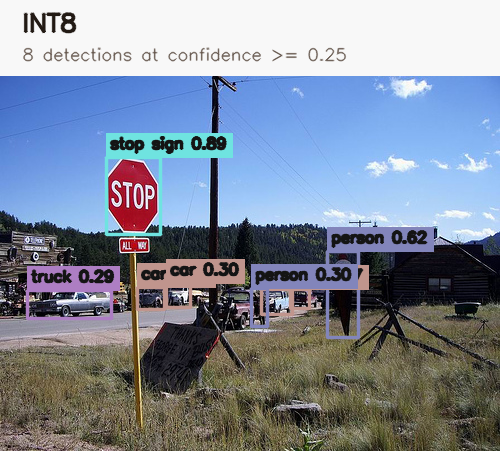
Las siguientes imágenes usan la misma fuente de COCO val2017 (000000222094.jpg) y las predicciones guardadas durante la evaluación formal de 1.000 imágenes. Para facilitar la lectura solo se dibujan detecciones con confianza mínima de 0,25; NMS se mantiene en 0,65.
FP16 — 8 detecciones
INT8 — 8 detecciones
W4A16 GDQ-group128 — 2 detecciones
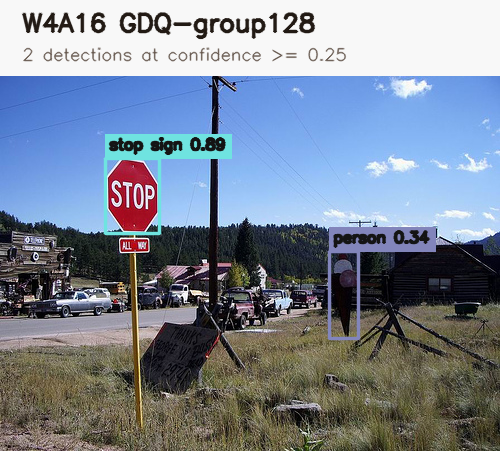
Se eligió este ejemplo porque la diferencia de cuantización se aprecia con claridad. Es una ilustración y no sustituye los resultados COCO AP agregados que aparecen a continuación.
Resultados
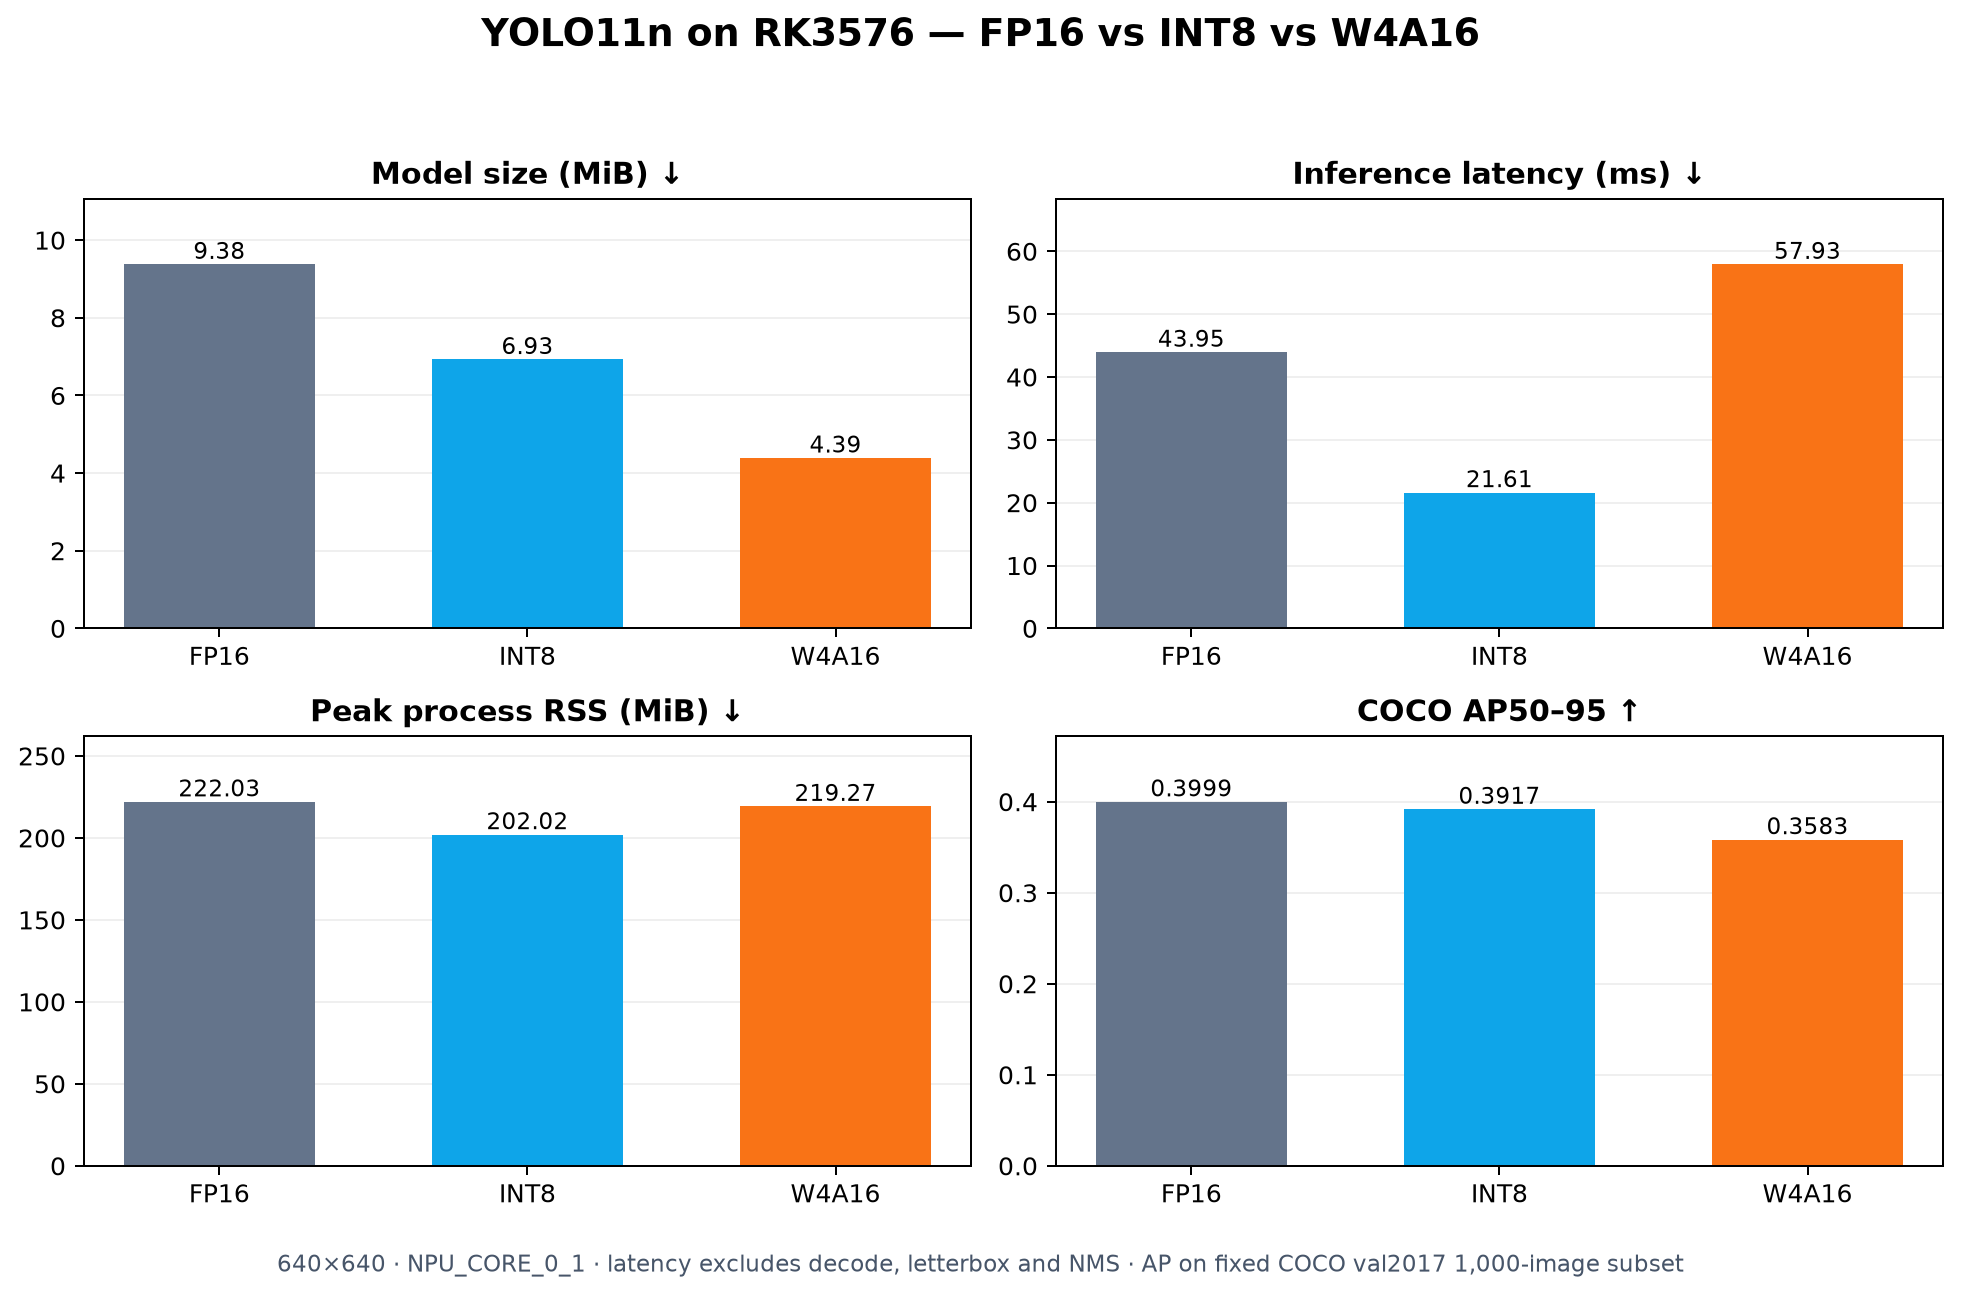
| Precisión | Tamaño | Latencia media | Rendimiento | RSS máximo | AP50–95 |
|---|---|---|---|---|---|
| FP16 | 9,38 MiB | 43,95 ms | 22,76 FPS | 222,03 MiB | 0,3999 |
| INT8 | 6,93 MiB | 21,61 ms | 46,36 FPS | 202,02 MiB | 0,3917 |
| W4A16 GDQ-group128 | 4,39 MiB | 57,93 ms | 17,30 FPS | 219,27 MiB | 0,3583 |
INT8 alcanzó aproximadamente 2,04 veces el rendimiento de FP16 y solo perdió 0,82 puntos de AP.
W4A16 redujo el archivo al 46,8 % del tamaño de FP16, pero su rendimiento fue un 24,0 % inferior a FP16 y un 62,7 % inferior a INT8. Su AP50–95 fue 4,16 puntos menor que FP16.
El primer W4A16 normal + channel obtuvo solo 0,0121 AP50–95 pese a devolver tensores válidos. GDQ-group128 recuperó 0,3583, por lo que una conversión correcta no sustituye la validación.
¿Qué precisión elegir?
- FP16 para establecer una referencia fiable de despliegue y precisión.
- INT8 cuando importan tanto el rendimiento como la precisión.
- W4A16 cuando el almacenamiento o el ancho de banda de los pesos son la principal limitación.
En este despliegue de YOLO11n, INT8 fue la mejor opción general. W4A16 comprimió los pesos, pero no produjo automáticamente mayor velocidad.