YOLO11-Quantisierungsvergleich auf dem reComputer RK3576
Konvertiert YOLO11n von ONNX nach RKNN und vergleicht Modellgröße, Inferenzgeschwindigkeit, Laufzeitspeicher und COCO-Genauigkeit von FP16, INT8 und W4A16 auf dem reComputer RK3576.
YOLO11-Quantisierungsvergleich auf dem reComputer RK3576
Kann ein Computer-Vision-Modell auf Rockchip-Hardware wirklich mit 4 Bit ausgeführt werden? Ist der RK3576 die einzige unterstützte Rockchip-Plattform, und ist ein kleineres Modell automatisch schneller?
Dieses Projekt konvertiert dasselbe YOLO11n-ONNX-Modell in FP16-, INT8- und W4A16-RKNN-Modelle, führt sie auf einem reComputer RK3576 aus und bewertet sie mit einem einheitlichen, reproduzierbaren Protokoll.
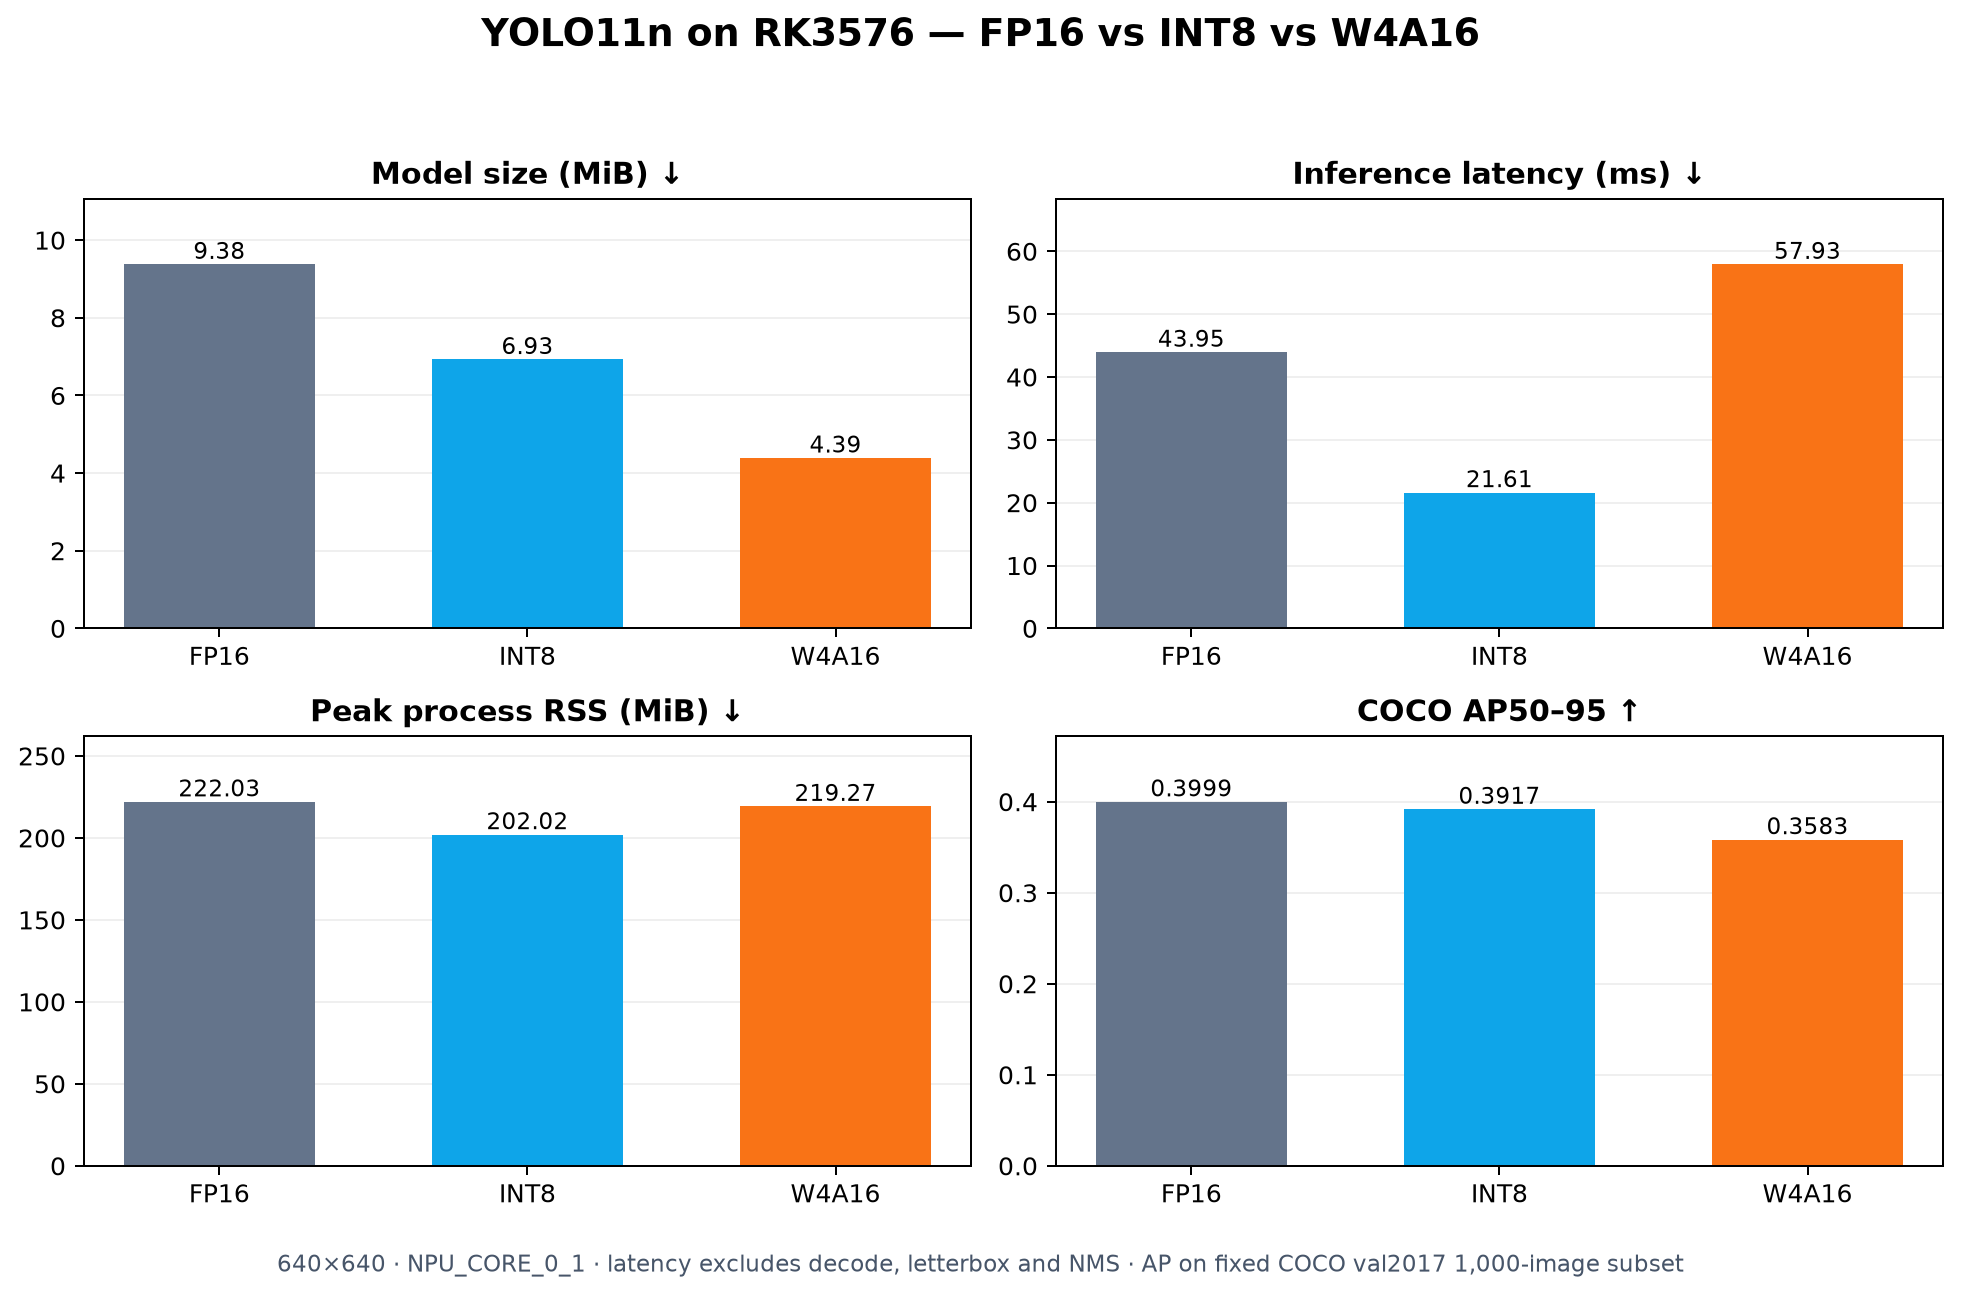
Das Ergebnis lautet nicht einfach „weniger Bits sind besser“. W4A16 erzeugte die kleinste Modelldatei, INT8 bot jedoch das beste Verhältnis aus Durchsatz und Genauigkeit.
Was 4 Bit auf dem RK3576 bedeuten
Bei W4A16 bezeichnet W die Präzision der Gewichte und A die Präzision der Aktivierungen.
| Format | Gewichte | Aktivierungen | Übliche Bezeichnung |
|---|---|---|---|
| FP16 | 16-Bit-Gleitkomma | 16-Bit-Gleitkomma | Halbe Genauigkeit |
| W8A8 | 8-Bit-Ganzzahl | 8-Bit-Ganzzahl | INT8-Quantisierung |
| W4A16 | 4-Bit-Ganzzahl | 16-Bit-Gleitkomma | 4-Bit-Gewichtsquantisierung |
| W4A4 | 4-Bit-Ganzzahl | 4-Bit-Ganzzahl | Vollständiges oder reines INT4 |
W4A16 speichert Gewichte mit 4 Bit und behält 16-Bit-Aktivierungen bei. Es ist somit ein Modell mit 4-Bit-quantisierten Gewichten, kein vollständig quantisiertes W4A4-Netz.
Diese Unterscheidung ist für Computer Vision wichtig. Gewichte sind fest und lassen sich offline analysieren, Aktivierungen ändern sich dagegen mit jedem Bild. Erkennungsköpfe, Merkmale kleiner Objekte, Konfidenzwerte und Bounding-Box-Regression reagieren oft empfindlich auf Quantisierungsrauschen. 16-Bit-Aktivierungen senken dieses Risiko, der Laufzeitspeicher schrumpft dadurch jedoch nicht proportional zur Dateigröße.
Das Änderungsprotokoll von RKNN-Toolkit2 dokumentiert die symmetrische W4A16-Quantisierung ausdrücklich für den RK3576. Daraus folgt nicht, dass nur dieser SoC beliebige INT4-Berechnungen ausführen kann. Andere Chips können einzelne Low-Bit-Operationen bieten; das ist nicht dasselbe wie der hier verwendete vollständige RKNN-W4A16-CV-Konvertierungsablauf.
Hardware und Software
- Board: reComputer RK3576, 8 GB
- Betriebssystem: Debian 12 / Armbian
- Kernel:
6.1.115-vendor-seeed-rk3576 - RKNN-Toolkit2: 2.3.2
- RKNN-Toolkit-Lite2: 2.3.2
- RKNN Runtime: 2.3.0
- RKNPU-Treiber: 0.9.8
- Modell: optimiertes YOLO11n ONNX aus dem Rockchip Model Zoo
- Eingabe: 640 × 640 RGB
- Kalibrierung: dieselben 20 festen COCO-val2017-Bilder für INT8 und W4A16
- Genauigkeit: fester Ausschnitt mit 1.000 COCO-val2017-Bildern, Seed 3576
Konvertierungsablauf
YOLO11n ONNX
      +-- FP16 RKNN ------------------------+
      +-- INT8/W8A8 + calibration ---------+--> RK3576 NPU --> benchmark
      +-- W4A16 + GDQ + group128 ----------+
1. RKNN-Toolkit2 installieren
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
  rknn-toolkit2==2.3.2 \
  rknn-toolkit-lite2==2.3.2 \
  numpy==1.26.4 onnx==1.16.1 \
  onnxruntime opencv-python pycocotools psutil
2. Repräsentative Kalibrierungsdaten vorbereiten
Erstellen Sie eine dataset.txt mit einem Bildpfad pro Zeile:
./calibration/000000000139.jpg
./calibration/000000000285.jpg
./calibration/000000000632.jpg
Die Bilder sollten die reale Einsatzumgebung repräsentieren. Verwenden Sie beim Vergleich stets dieselbe ONNX-Quelle und denselben Kalibrierungssatz.
3. Eine FP16-Basislinie erstellen
from rknn.api import RKNN

rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=False)
rknn.export_rknn("yolo11n_fp16.rknn")
Damit nimmt die RKNN-Laufzeit uint8-RGB entgegen und normalisiert von 0–255 auf 0–1. Teilen Sie in der Anwendung nicht erneut durch 255.
4. INT8/W8A8 erstellen
Ergänzen Sie die identische Vorverarbeitung um:
quantized_dtype="w8a8"
quantized_algorithm="normal"
quantized_method="channel"
Erstellen Sie das Modell mit aktivierter Kalibrierung:
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_int8.rknn")
5. W4A16 erstellen
w4a16 + normal + channel ließ sich erstellen und ausführen, die Genauigkeit brach jedoch ein. Die beste getestete W4A16-Konfiguration war GDQ + group128:
rknn = RKNN(verbose=True)
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform="rk3576",
    quantized_dtype="w4a16",
    quantized_algorithm="gdq",
    quantized_method="group128",
    float_dtype="float16",
    optimization_level=3,
)
rknn.load_onnx(model="yolo11n.onnx")
rknn.build(do_quantization=True, dataset="dataset.txt")
rknn.export_rknn("yolo11n_w4a16_gdq_group128.rknn")
Die normale W4A16-Konvertierung dauerte etwa 27 Sekunden, GDQ-group128 etwa 641 Sekunden. Dieser Offline-Aufwand fällt während der Inferenz nicht erneut an.
group128 ist nicht für jedes Modell optimal. Vergleichen Sie Kanalquantisierung, mehrere Gruppengrößen und GDQ mit eigenen Validierungsdaten.
Modell auf dem RK3576 ausführen
import cv2
import numpy as np
from rknnlite.api import RKNNLite

runtime = RKNNLite()
runtime.load_rknn("yolo11n_w4a16_gdq_group128.rknn")
runtime.init_runtime(core_mask=RKNNLite.NPU_CORE_0_1)

image = cv2.imread("test.jpg")
image = cv2.resize(image, (640, 640))
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
outputs = runtime.inference(inputs=[image[np.newaxis, ...].astype(np.uint8)])

runtime.release()
Dieses Minimalbeispiel prüft nur den Modellstart. Produktive YOLO11-Inferenz benötigt passendes Letterboxing, DFL-Decodierung, Klassenfilterung, NMS und Koordinatenrückrechnung.
Benchmark-Protokoll
Jedes Modell nutzte NPU_CORE_0_1, 50 Aufwärmdurchläufe und 500 gemessene Inferenzen. Die gesamte Sequenz wurde mit wechselnder Modellreihenfolge dreimal wiederholt. Die Latenz umfasst nur den RKNNLite-Aufruf inference(), nicht Bildladen, Letterboxing oder NMS.
Für die Genauigkeit kamen dieselben 1.000 COCO-Bilder, Letterbox-Einstellungen, ein Konfidenzschwellwert von 0,001, ein NMS-Schwellwert von 0,65 und dieselbe COCOeval-Konfiguration zum Einsatz.
Vergleich realer Inferenzergebnisse
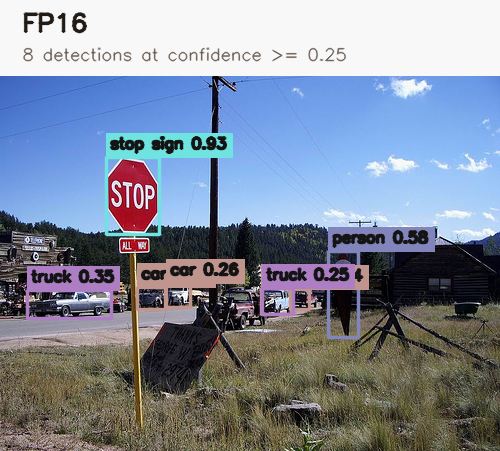
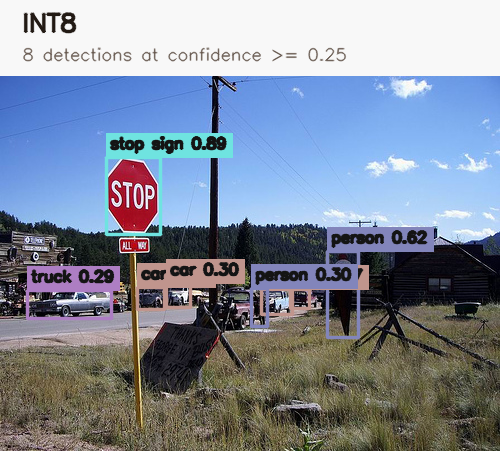
Die folgenden Bilder verwenden dasselbe COCO-val2017-Quellbild (000000222094.jpg) und die während der formalen 1.000-Bilder-Auswertung gespeicherten Vorhersagen. Für bessere Lesbarkeit werden nur Erkennungen ab 0,25 Konfidenz gezeichnet; der NMS-Schwellwert bleibt 0,65.
FP16 — 8 Erkennungen
INT8 — 8 Erkennungen
W4A16 GDQ-group128 — 2 Erkennungen
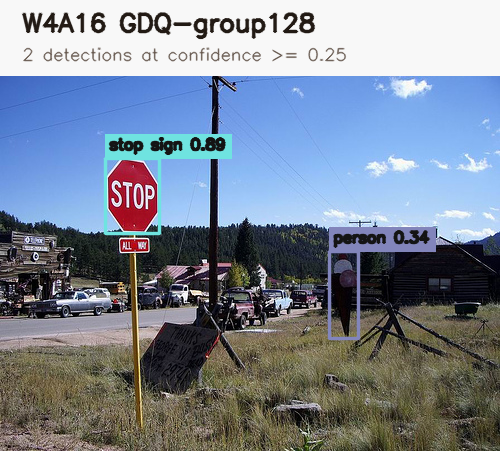
Dieses Beispiel wurde gewählt, weil der Quantisierungsunterschied gut sichtbar ist. Es dient der Veranschaulichung und ersetzt nicht die nachfolgenden aggregierten COCO-AP-Ergebnisse.
Ergebnisse
| Präzision | Modellgröße | Mittlere Latenz | Durchsatz | Maximaler RSS | AP50–95 |
|---|---|---|---|---|---|
| FP16 | 9,38 MiB | 43,95 ms | 22,76 FPS | 222,03 MiB | 0,3999 |
| INT8 | 6,93 MiB | 21,61 ms | 46,36 FPS | 202,02 MiB | 0,3917 |
| W4A16 GDQ-group128 | 4,39 MiB | 57,93 ms | 17,30 FPS | 219,27 MiB | 0,3583 |
INT8 erreichte etwa den 2,04-fachen FP16-Durchsatz bei nur 0,82 AP-Punkten Verlust.
W4A16 verkleinerte die Datei auf 46,8 % von FP16, war beim Durchsatz aber 24,0 % langsamer als FP16 und 62,7 % langsamer als INT8. AP50–95 lag 4,16 Punkte unter FP16.
Das erste W4A16-Modell mit normal + channel erreichte trotz gültiger Ausgabetensoren nur 0,0121 AP50–95. GDQ-group128 stellte 0,3583 wieder her: Eine erfolgreiche Konvertierung ersetzt keine Validierung.
Welche Präzision ist sinnvoll?
- FP16 für eine zuverlässige Bereitstellungs- und Genauigkeitsbasis.
- INT8 für ein gutes Verhältnis aus Durchsatz und Genauigkeit.
- W4A16, wenn Modellspeicher oder Gewichtsbandbreite die wichtigste Einschränkung sind.
Für dieses YOLO11n-Deployment war INT8 insgesamt die beste Wahl. W4A16 komprimierte die Gewichte, führte aber nicht automatisch zu höherer Geschwindigkeit.